Quantum Elements의 Qiskit 함수인 Orbit을 사용하여 QFT+M 프로세스의 정확도를 벤치마킹합니다
예상 실행 시간: Heron r3 프로세서에서 2분. (참고: 이는 단지 추정치일 뿐입니다.) (실행 시간은 상황에 따라 다를 수 있습니다.) 기본적으로 이 튜토리얼에서는 3개의 Orbit 함수 작업을 하나의 IBM Quantum Compute Service 배치 모드 워크로드로 제출하며, 작업당 300개의 PUB를 사용하여 총 900개의 PUB와 921,600개의 샷을 처리합니다.
경고: 동적 회로는 현재 실험적 기능이며, Quantum Compute [3] 에서 적용되는 제한 사항으로 인해 작업이 실패할 수 있습니다. 예를 들어, 오류 6073은 작업이 클래식 제어 하드웨어의 메모리 한도를 초과했음을 나타냅니다 [4]. 이 노트북은 하나의 배치 내에서 세 개의 양자 컴퓨팅 작업에 회로 크기를 분산함으로써 이러한 위험을 줄여줍니다 [5]. 각 고정 크기 비교 작업은 하나의 작업으로 유지되는 반면, 큰 크기와 작은 크기는 작업 간의 클래식-컨트롤 워크로드를 균형 있게 분배하기 위해 짝을 이룹니다.
학습 성과
- 문헌 [1] 의 그림 2a 에 제시된 표본 추출 기반 공정 충실도 추정기가 사용하는 제품 상태 를 준비한다.
- 양자 푸리에 변환과 측정(QFT+M)에 대한 등가적인 유니터리 및 동적 구현을 구축하십시오.
- 현재의 보정 및 연결성 데이터를 활용하여 동적 회로에 사용할 물리적 큐비트를 선택하십시오.
- 회로 크기가 커짐에 따라 원시 단일, 원시 동적, 그리고 Orbit으로 강화된 동적 QFT+M 과정 충실도 추정치를 비교하십시오.
transpilation_mode="validate"Orbit의 간소화된 트랜스파일링 API를 및 와mode="raw"함께 사용하세요.- 배치 모드 API를 통해 여러 Orbit 워크로드를 제출하되, 고정 크기의 3가지 전략 비교를 모두 하나의 작업에 포함시킵니다.
- Orbit 메타데이터를 검토하여 동적 분리(DD) 및 측정 오차 완화(MEM)가 적용되었는지 확인하십시오.
배경
참고문헌 [1] 의 그림 2a 은 이상적인 QFT+M 채널의 과정 충실도를 잡음이 있는 유니터리 구현 및 동적 구현과 비교하여 평가하고 있다. 샘플링된 계산 기반 레이블 에 대해, 벤치마크는 를 준비하고, 노이즈가 포함된 QFT+M 구현을 적용한 뒤, 해당 이상적인 출력을 얻을 확률 을 추정합니다. 이러한 역-QFT 상태들은 분리 가능하며, 하다마르 게이트와 가상 위상 회전을 통해 효율적으로 생성할 수 있다.
의 독립적으로 표본 추출된 레이블에 대해, 이 노트북은 참고문헌 [1] 에서 도출된 무편향 추정량을 사용합니다:
이 동적 구성은 유니터리 QFT+M의 제어 위상 게이트를 회로 중간 측정과 고전적으로 조건이 부여된 위상 회전으로 대체한다 [1]. 이연 측정 방식에 따르면, 두 회로 모두 동일한 이상적인 출력 분포를 갖습니다. 이 동적 형태는 모든 쌍 간의 2-큐비트 게이트 요구 사항을 제거하고, 대신 피드포워드 방식을 적용하며 연결성 제약이 없는 의 회로 중간 측정 방식을 사용합니다. 측정 및 피드포워드 과정은 또한 아직 측정되지 않은 큐비트에 긴 유휴 시간을 남기므로, DD가 특히 중요해집니다.
그림 2a 과의 관계. 이 노트북은 해당 논문의 샘플링된 프로세스 충실도 프로토콜을 따르지만, 단순한 재현이 아닌 ‘오빗(Orbit)’에 초점을 맞춘 튜토리얼용 개작본입니다. 예를 들어, 그림 2a 에서는 ibm_kyiv 2000샷을 사용했지만, 우리는 QPU 처리 시간을 절약하기 위해 샷 수가 더 적은 1024샷을 사용하는 최신 장치를 ibm_aachen 활용합니다.
결과 예제
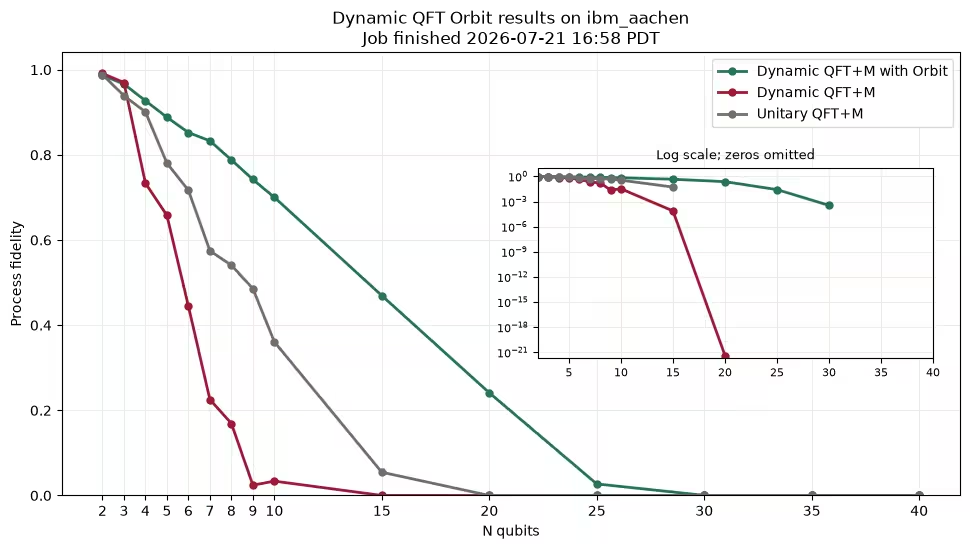
아래의 정적 그래프는 아래에 설명된 프로세스를 사용하여 ibm_aachen 연속으로 실행된 세 번의 개발 작업에서 도출된 평균 프로세스 충실도 곡선을 보여줍니다. 여기서 보여준 바와 같이, Orbit은 동적 회로의 품질을 크게 향상시킬 수 있으며, 동적 QFT는 발표된 벤치마크 수준에 부합할 뿐만 아니라 표준 유니터리 QFT에 비해 개선된 성능을 보여줍니다. 나중에 살펴보게 되겠지만, 이러한 결과는 큐비트의 자동 최적 선택, 자동 동적 디커플링 삽입(이 문제에 대해 수동으로 최적화된 것이 아님), 그리고 측정 오차 완화에서 비롯된 것입니다. 재미 삼아, 특히 다른 백엔드를 선택한 경우라면, 마지막에 이 결과들을 여러분의 결과와 꼭 비교해 보세요.
참고: 이 결과는 Orbit을 사용하여 이전에 성공적으로 수행된 실행의 예시일 뿐, 성능을 보장하는 것은 아닙니다. 아래의 결과는 대략적으로 비슷해 보일 것이나, 구체적인 내용은 선택한 장치와 그 특성, 특히 실행 시 발생하는 측정 오차 및 유휴 오차에 따라 달라집니다.

요구사항
이 튜토리얼을 실행하기 전에 다음 패키지의 최신 버전을 설치하십시오:
numpymatplotlibqiskitqiskit-ibm-runtimeqiskit-ibm-catalog
pip install qiskit qiskit-ibm-runtime qiskit-ibm-catalog numpy matplotlib설정
IBM Quantum® Platform 로 인증하고, 로드를 실행한 ibm_aachen다음, Qiskit Functions Catalog 에서 Quantum Elements Orbit을 불러옵니다. 기본 스윕은 15가지 회로 크기, 크기당 20개의 샘플링된 비트스트링, 그리고 3가지 전략을 평가합니다. NUM_BATCH_JOBS=3 한 배치 내의 세 가지 작업에 크기를 분배합니다. M개별 동적 회로 작업이 여전히 백엔드의 고전 제어 메모리 한도에 도달하는 경우, 또는 을 N_VALUES 줄이거나, 을 NUM_BATCH_JOBS 늘리십시오. 회로의 수나 복잡도보다는 실행 사용량을 줄이는 것이 목표일 때는 Reduce를 SHOTS 사용합니다.
import warnings
from collections import Counter, defaultdict

import matplotlib.pyplot as plt
import numpy as np
from qiskit import (
    ClassicalRegister,
    QuantumCircuit,
    QuantumRegister,
    transpile,
)
from qiskit.circuit import IfElseOp
from qiskit.synthesis.qft import synth_qft_full
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from qiskit_ibm_runtime import Batch, QiskitRuntimeService

IBM_BACKEND_NAME = "ibm_aachen"

N_VALUES = [2, 3, 4, 5, 6, 7, 8, 9, 10, 15, 20, 25, 30, 35, 40]
M = 20
SHOTS = 1024
RNG_SEED = 12345
OPTIMIZATION_LEVEL = 0
NUM_BATCH_JOBS = 3
STRATEGY_LABELS = ("unitary/raw", "dynamic/raw", "dynamic/orbit")


def balanced_n_groups(
    n_values: list[int], num_jobs: int = 3
) -> list[list[int]]:
    values = sorted(n_values)
    if len(set(values)) != len(values):
        raise ValueError("N_VALUES must not contain duplicates")
    if not 1 <= num_jobs <= len(values):
        raise ValueError("NUM_BATCH_JOBS must be between 1 and len(N_VALUES)")

    max_group_size = (len(values) + num_jobs - 1) // num_jobs
    groups = [[] for _ in range(num_jobs)]
    loads = [0] * num_jobs
    pair_counts = [0] * num_jobs
    remaining = values.copy()

    while len(remaining) >= 2:
        candidates = [
            i
            for i, group in enumerate(groups)
            if len(group) + 2 <= max_group_size
        ]
        if not candidates:
            break
        smallest = remaining.pop(0)
        largest = remaining.pop()
        job_index = min(
            candidates, key=lambda i: (loads[i], len(groups[i]), i)
        )
        pair = (
            [largest, smallest]
            if pair_counts[job_index] % 2 == 0
            else [smallest, largest]
        )
        groups[job_index].extend(pair)
        loads[job_index] += smallest + largest
        pair_counts[job_index] += 1

    while remaining:
        value = remaining.pop()
        candidates = [
            i for i, group in enumerate(groups) if len(group) < max_group_size
        ]
        job_index = min(
            candidates, key=lambda i: (loads[i], len(groups[i]), i)
        )
        groups[job_index].append(value)
        loads[job_index] += value

    return groups


N_GROUPS = balanced_n_groups(N_VALUES, NUM_BATCH_JOBS)

service = QiskitRuntimeService(channel="ibm_quantum_platform")
backend = service.backend(IBM_BACKEND_NAME)
if "if_else" not in backend.target.operation_names:
    backend.target.add_instruction(IfElseOp, name="if_else")

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
quantum_elements_orbit = catalog.load("quantum-elements/orbit")
if quantum_elements_orbit is None:
    raise RuntimeError(
        "Quantum Elements Orbit is not enabled for this IBM Quantum instance."
    )

required_qubits = max(N_VALUES)
if backend.num_qubits < required_qubits:
    raise ValueError(
        f"Backend {backend.name} has {backend.num_qubits} qubits, "
        f"but this benchmark needs at least {required_qubits}."
    )

{
    "backend": backend.name,
    "num_qubits": backend.num_qubits,
    "n_values": N_VALUES,
    "m": M,
    "shots": SHOTS,
    "num_function_jobs": NUM_BATCH_JOBS,
    "n_groups": N_GROUPS,
    "pubs_per_job": [
        len(group) * M * len(STRATEGY_LABELS) for group in N_GROUPS
    ],
    "total_pubs": len(N_VALUES) * M * len(STRATEGY_LABELS),
    "total_shots": len(N_VALUES) * M * len(STRATEGY_LABELS) * SHOTS,
}
Output:
qiskit_runtime_service._discover_account:WARNING:2026-07-21 15:57:39,310: Loading account with the given token. A saved account will not be used.
{'backend': 'ibm_aachen',
 'num_qubits': 156,
 'n_values': [2, 3, 4, 5, 6, 7, 8, 9, 10, 15, 20, 25, 30, 35, 40],
 'm': 20,
 'shots': 1024,
 'num_function_jobs': 3,
 'n_groups': [[40, 2, 7, 15, 10], [35, 3, 6, 20, 9], [30, 4, 5, 25, 8]],
 'pubs_per_job': [300, 300, 300],
 'total_pubs': 900,
 'total_shots': 921600}
QFT+M 회로 구축
표본 추출된 각 정수 에 대해, bit_inv_qft 하다마드 연산을 수행한 뒤 위상 회전을 적용하여 의 곱 상태를 준비한다. 그런 다음 이 노트는 표준 단일체 양자장론(QFT)이나, 이에 상응하는 준고전적 동역학적 QFT+M 중 하나를 부록으로 수록합니다.
두 구현 모두 마지막 스왑 네트워크를 생략하고 있습니다. format(x, f"0{n}b")[::-1]따라서 Qiskit의 클래식 비트 표시 순서에 따르면, 예상되는 측정된 문자열은 의 0으로 채워진 이진 표현과 반대 순서가 되며, 이는 로 인코딩됩니다.
def bit_inv_qft(circuit: QuantumCircuit, x: int, conv: str = "LSB") -> None:
    num_qubits = circuit.num_qubits
    circuit.h(range(num_qubits))
    for j in range(num_qubits):
        phase = (
            2 * np.pi * x / 2 ** (num_qubits - j)
            if conv == "LSB"
            else 2 * np.pi * x / 2 ** (j + 1)
        )
        circuit.p(-phase, j)


def build_unitary_qft_circuit(num_qubits: int, x: int) -> QuantumCircuit:
    if not 0 <= x < 2**num_qubits:
        raise ValueError(
            f"x={x} is outside the {num_qubits}-qubit basis range"
        )
    qreg = QuantumRegister(num_qubits, "q")
    creg = ClassicalRegister(num_qubits, "c")
    circuit = QuantumCircuit(qreg, creg, name=f"unitary_qft_{num_qubits}q")
    bit_inv_qft(circuit, x)
    circuit.append(
        synth_qft_full(num_qubits, do_swaps=False), range(num_qubits)
    )
    circuit.measure(range(num_qubits), range(num_qubits))
    return circuit


def _warn_if_precision_loss(max_num_entanglements: int) -> None:
    if max_num_entanglements > -np.finfo(float).minexp:
        warnings.warn(
            "precision loss in QFT."
            f" The rotation needed to represent {max_num_entanglements} entanglements"
            " is smaller than the smallest normal floating-point number.",
            category=RuntimeWarning,
            stacklevel=4,
        )


def synth_dynamic_qft(
    circuit: QuantumCircuit, *, do_swaps: bool = False
) -> QuantumCircuit:
    num_qubits = circuit.num_qubits
    creg = circuit.cregs[0]
    _warn_if_precision_loss(num_qubits - 1)

    for j in reversed(range(num_qubits)):
        circuit.h(j)
        circuit.measure([j], [j])

        if j > 0:
            with circuit.if_test((creg[j], 1)):
                for k in reversed(range(j)):
                    circuit.p(np.pi * (2.0 ** (k - j)), k)

    if do_swaps:
        for i in range(num_qubits // 2):
            circuit.swap(i, num_qubits - i - 1)
    return circuit


def build_dynamic_qft_circuit(num_qubits: int, x: int) -> QuantumCircuit:
    if not 0 <= x < 2**num_qubits:
        raise ValueError(
            f"x={x} is outside the {num_qubits}-qubit basis range"
        )
    qreg = QuantumRegister(num_qubits, "q")
    creg = ClassicalRegister(num_qubits, "c")
    circuit = QuantumCircuit(qreg, creg, name=f"dynamic_qft_{num_qubits}q")
    bit_inv_qft(circuit, x)
    synth_dynamic_qft(circuit, do_swaps=False)
    return circuit


def target_output_bitstring(x: int, n_qubits: int) -> str:
    return format(int(x), f"0{n_qubits}b")[::-1]


def process_fidelity_from_success_probabilities(
    success_probabilities: list[float],
) -> float:
    m = len(success_probabilities)
    if m <= 1:
        raise ValueError(
            "m must be larger than 1 for the process-fidelity estimator"
        )
    succ = np.asarray(success_probabilities, dtype=float)
    return float(
        (m / (m - 1)) * (np.mean(np.sqrt(succ)) ** 2)
        - np.sum(succ) / (m * (m - 1))
    )
동적 회로 물리 큐비트 선택
동적 구현 방식은 2-큐비트 게이트를 필요로 하지 않으므로, 물리적 큐비트들이 연결된 부분그래프를 형성할 필요가 없다. 각 회로 규모에 대해, 선택기는 판독 오류(readout error)를 낮추는 데 80%, 양자 위상 오차( )와 양자 위상 오차( )를 높이는 데 각각 10%의 가중치를 부여한 점수를 바탕으로 현재 백엔드 큐비트를 순위를 매깁니다. 먼저, 가능한 경우 서로 직접 결합이 없는 고득점 큐비트를 선택하여 가장 가까운 이웃 간의 크로스톡(crosstalk) 영향을 줄인 다음, 남은 위치를 점수 순으로 채웁니다.
와 dynamic/orbit 변형은 dynamic/raw 주어진 크기에 대해 정확히 동일한 선택된 레이아웃을 사용하므로, 두 변형 간의 비교는 레이아웃에 따라 결정됩니다. 이 unitary/raw 회로는 2큐비트 연결성이 필요하기 때문에 트랜스파일러에 의해 매핑 및 라우팅됩니다. 이 런타임 보정 기반 선택 방식은 본 튜토리얼에 한정된 것이며, 논문 내 그림 2a 의 실험에 사용된 고정된 40-큐비트 ibm_kyiv 레이아웃과는 다릅니다.
def value_from_property(raw):
    if raw is None:
        return None
    if isinstance(raw, tuple):
        return raw[0]
    return getattr(raw, "value", raw)


def qubit_property_value(properties, qubit: int, *names: str) -> float | None:
    for name in names:
        try:
            value = value_from_property(
                properties.qubit_property(qubit, name)
            )
        except Exception:
            value = None
        if value is not None:
            return float(value)
    return None


def measurement_error(properties, qubit: int) -> float | None:
    readout = qubit_property_value(properties, qubit, "readout_error")
    if readout is not None:
        return readout
    p01 = qubit_property_value(properties, qubit, "prob_meas0_prep1")
    p10 = qubit_property_value(properties, qubit, "prob_meas1_prep0")
    if p01 is not None and p10 is not None:
        return 0.5 * (p01 + p10)
    return None


def coupling_edges(backend) -> list[tuple[int, int]]:
    coupling_map = getattr(backend, "coupling_map", None)
    if coupling_map is not None:
        try:
            return [(int(a), int(b)) for a, b in coupling_map.get_edges()]
        except Exception:
            pass
    built = backend.target.build_coupling_map()
    return [(int(a), int(b)) for a, b in built.get_edges()]


def neighbor_map(backend) -> dict[int, set[int]]:
    neighbors = {qubit: set() for qubit in range(backend.num_qubits)}
    for a, b in coupling_edges(backend):
        neighbors[a].add(b)
        neighbors[b].add(a)
    return neighbors


def anchored_score(
    value: float | None, *, good: float, bad: float, higher_is_better: bool
) -> float:
    if value is None:
        return 0.0
    if higher_is_better:
        low, high = sorted((bad, good))
        score = (value - low) / (high - low)
    else:
        low, high = sorted((good, bad))
        score = (high - value) / (high - low)
    return float(min(1.0, max(0.0, score)))


def qubit_metrics(backend) -> list[dict]:
    properties = backend.properties()
    rows = []
    for qubit in range(backend.num_qubits):
        t1 = qubit_property_value(properties, qubit, "T1", "t1")
        t2 = qubit_property_value(properties, qubit, "T2", "t2")
        meas_error = measurement_error(properties, qubit)
        measurement_score = anchored_score(
            meas_error, good=0.005, bad=0.05, higher_is_better=False
        )
        t1_score = anchored_score(
            t1, good=0.00025, bad=0.00005, higher_is_better=True
        )
        t2_score = anchored_score(
            t2, good=0.00025, bad=0.00005, higher_is_better=True
        )
        rows.append(
            {
                "qubit": qubit,
                "t1": t1,
                "t2": t2,
                "measurement_error": meas_error,
                "score": 0.8 * measurement_score
                + 0.1 * t1_score
                + 0.1 * t2_score,
            }
        )
    return sorted(rows, key=lambda row: row["score"], reverse=True)


def select_dynamic_qubits(backend, n_qubits: int) -> list[int]:
    ranked = qubit_metrics(backend)
    neighbors = neighbor_map(backend)
    selected = []
    blocked = set()
    for row in ranked:
        qubit = row["qubit"]
        if qubit in blocked:
            continue
        selected.append(qubit)
        blocked.add(qubit)
        blocked.update(neighbors.get(qubit, set()))
        if len(selected) == n_qubits:
            return selected

    for row in ranked:
        qubit = row["qubit"]
        if qubit not in selected:
            selected.append(qubit)
        if len(selected) == n_qubits:
            return selected
    raise RuntimeError(f"Could not select {n_qubits} physical qubits")


print("The top 3 qubits (according to our scoring): ")
print(qubit_metrics(backend)[0:3])
print("Worst  3 qubits (according to our scoring): ")
print(qubit_metrics(backend)[-3:])
Output:
The top 3 qubits (according to our scoring):
[{'qubit': 0, 't1': 0.0002514242577986401, 't2': 0.00037559012475638467, 'measurement_error': 0.0028076171875, 'score': 1.0}, {'qubit': 20, 't1': 0.0002526252407383437, 't2': 0.00038493543771861573, 'measurement_error': 0.00390625, 'score': 1.0}, {'qubit': 25, 't1': 0.0002712841332005567, 't2': 0.00025793268824583597, 'measurement_error': 0.0040283203125, 'score': 1.0}]
Worst  3 qubits (according to our scoring):
[{'qubit': 146, 't1': 7.619772882181663e-05, 't2': 0.00014166983578724752, 'measurement_error': 0.0802001953125, 'score': 0.05893378230453208}, {'qubit': 51, 't1': 0.00014200221819602618, 't2': 1.930870507157441e-06, 'measurement_error': 0.054443359375, 'score': 0.04600110909801309}, {'qubit': 35, 't1': 7.116087485472031e-05, 't2': 9.463696242928626e-05, 'measurement_error': 0.14501953125, 'score': 0.03289891864200328}]
벤치마크 PUB 준비하기
각 (N, x) 쌍에 대해, 노트북은 먼저 논리 회로를 트랜스파일링하고 각 전략마다 하나의 샘플러 PUB 를 생성합니다:
unitary/raw: 트랜스파일러가 선택한 레이아웃을 기반으로 한 단일 QFT+M 모델로, 필요한 경우 라우팅을 적용하되 Orbit DD나 MEM은 포함하지 않습니다.dynamic/raw: 보정 과정을 통해 선별된 물리적 큐비트를 대상으로 한 동적 QFT+M으로, Orbit DD나 MEM은 사용하지 않습니다.dynamic/orbit: Orbit DD 및 MEM이 활성화된 상태에서, 동일한 물리적 큐비트에 대해 동일한 트랜스파일된 동적 회로를 실행한 경우.
궤도 강화형 PUB 는 매핑이 이미 선택되어 있기 때문에 이를 사용합니다 transpilation_mode="validate" . Orbit은 제공된 물리적 회로를 재매핑하지 않고 검증한 다음, 자체 DD 및 MEM 파이프라인을 적용합니다. 향상된 동적 곡선만이 MEM을 요청하기 때문에, 이를 DD 적용 여부에 대한 독립적인 비교로 해석해서는 안 됩니다.
PUB, per- PUB 옵션 및 결과 레코드는 배치 작업 인덱스별로 저장됩니다. 고정된 각 에 대해, unitary/raw dynamic/raw, 및 dynamic/orbit PUB는 동일한 작업에 함께 포함됩니다. 이 그룹화 헬퍼는 크고 작은 회로 크기를 짝지우고, 그 순서를 번갈아 가며, 세 가지 작업에 걸쳐 ‘ ’의 합을 균형 있게 분배함으로써, 고전 제어 워크로드를 간단히 대리합니다.
strategy_options = {
    "unitary/raw": {"mode": "raw"},
    "dynamic/raw": {"mode": "raw"},
    "dynamic/orbit": {"mode": "orbit", "transpilation_mode": "validate"},
}
rng = np.random.default_rng(RNG_SEED)
pubs_by_job = [[] for _ in N_GROUPS]
pub_options_by_job = [[] for _ in N_GROUPS]
pub_records_by_job = [[] for _ in N_GROUPS]
layout_summary = {}

target_decimals_by_n = {
    n_qubits: [int(x) for x in rng.integers(0, 2**n_qubits, size=M)]
    for n_qubits in N_VALUES
}

for job_index, n_group in enumerate(N_GROUPS):
    for n_qubits in n_group:
        dynamic_qubits = select_dynamic_qubits(backend, n_qubits)
        layout_summary[str(n_qubits)] = {"dynamic_qubits": dynamic_qubits}

        for x in target_decimals_by_n[n_qubits]:
            target_bitstring = target_output_bitstring(x, n_qubits)
            unitary_logical = build_unitary_qft_circuit(n_qubits, x)
            dynamic_logical = build_dynamic_qft_circuit(n_qubits, x)

            unitary_transpiled = transpile(
                unitary_logical,
                backend=backend,
                optimization_level=OPTIMIZATION_LEVEL,
                seed_transpiler=RNG_SEED,
            )
            dynamic_transpiled = transpile(
                dynamic_logical,
                backend=backend,
                optimization_level=OPTIMIZATION_LEVEL,
                seed_transpiler=RNG_SEED,
                initial_layout=dynamic_qubits,
            )

            circuits_by_label = {
                "unitary/raw": unitary_transpiled,
                "dynamic/raw": dynamic_transpiled,
                "dynamic/orbit": dynamic_transpiled,
            }
            for label in STRATEGY_LABELS:
                circuit = circuits_by_label[label]
                options = dict(strategy_options[label])
                pubs_by_job[job_index].append((circuit, None, SHOTS))
                pub_options_by_job[job_index].append(options)
                pub_records_by_job[job_index].append(
                    {
                        "job_index": job_index,
                        "n_qubits": n_qubits,
                        "target_decimal": x,
                        "target_bitstring": target_bitstring,
                        "label": label,
                        "pub_options": options,
                        "dynamic_qubits": (
                            dynamic_qubits
                            if label.startswith("dynamic/")
                            else None
                        ),
                        "transpiled_depth": circuit.depth(),
                        "transpiled_size": circuit.size(),
                    }
                )

{
    "num_function_jobs": len(N_GROUPS),
    "n_groups": {
        job_index: group for job_index, group in enumerate(N_GROUPS)
    },
    "n_load_per_job": {
        job_index: sum(group) for job_index, group in enumerate(N_GROUPS)
    },
    "pubs_per_job": {
        job_index: len(pubs) for job_index, pubs in enumerate(pubs_by_job)
    },
    "expected_executions_per_job": {
        job_index: len(pubs) * SHOTS
        for job_index, pubs in enumerate(pubs_by_job)
    },
    "first_pub_record_by_job": {
        job_index: records[0]
        for job_index, records in enumerate(pub_records_by_job)
    },
    "largest_dynamic_qubit_set": layout_summary[str(max(N_VALUES))][
        "dynamic_qubits"
    ],
}
Output:
{'num_function_jobs': 3,
 'n_groups': {0: [40, 2, 7, 15, 10],
  1: [35, 3, 6, 20, 9],
  2: [30, 4, 5, 25, 8]},
 'n_load_per_job': {0: 74, 1: 73, 2: 72},
 'pubs_per_job': {0: 300, 1: 300, 2: 300},
 'expected_executions_per_job': {0: 307200, 1: 307200, 2: 307200},
 'first_pub_record_by_job': {0: {'job_index': 0,
   'n_qubits': 40,
   'target_decimal': 853235401719,
   'target_bitstring': '1110111111000000110100110001010101100011',
   'label': 'unitary/raw',
   'pub_options': {'mode': 'raw'},
   'dynamic_qubits': None,
   'transpiled_depth': 4778,
   'transpiled_size': 28259},
  1: {'job_index': 1,
   'n_qubits': 35,
   'target_decimal': 26888951661,
   'target_bitstring': '10110110111010110010110101000010011',
   'label': 'unitary/raw',
   'pub_options': {'mode': 'raw'},
   'dynamic_qubits': None,
   'transpiled_depth': 3614,
   'transpiled_size': 21204},
  2: {'job_index': 2,
   'n_qubits': 30,
   'target_decimal': 620442965,
   'target_bitstring': '101010101010110011011111001001',
   'label': 'unitary/raw',
   'pub_options': {'mode': 'raw'},
   'dynamic_qubits': None,
   'transpiled_depth': 2835,
   'transpiled_size': 15078}},
 'largest_dynamic_qubit_set': [0,
  20,
  25,
  27,
  33,
  59,
  74,
  80,
  95,
  144,
  151,
  155,
  79,
  90,
  60,
  68,
  114,
  107,
  13,
  126,
  133,
  103,
  3,
  87,
  53,
  41,
  130,
  5,
  98,
  135,
  153,
  15,
  116,
  45,
  7,
  48,
  136,
  11,
  147,
  77]}
벤치마크 실행하기
배치 하나를 생성한 다음, 해당 배치에 Orbit 함수 작업 3개를 제출합니다.
작업은 큐비트 수 그룹별로 분할되어, 고정된 에 대한 세 가지 전략을 모두 비교할 수 있도록 합니다. 즉, 고정된 에 해당하는 60개의 PUB(20개의 표본 입력에 세 가지 전략을 곱한 결과)가 모두 동일한 작업 내에서 실행되므로, 가능한 한 공정하게 비교할 수 있습니다(반대로, 서로 다른 작업에서 실행될 경우 대기열에 있는 동안 장치의 상태가 변동될 수 있습니다). 기본 그룹은 대규모 회로와 소규모 회로를 결합하여 각각 300개의 PUB로 구성되며, 이를 통해 하나의 작업에 가장 큰 동적 프로그램이 모두 집중될 가능성을 줄이면서도 작업 내 비교는 유지합니다.
runtime_batch = Batch(backend=backend)
jobs = []
try:
    for job_index, pubs in enumerate(pubs_by_job):
        jobs.append(
            quantum_elements_orbit.run(
                primitive="sampler",
                pubs=pubs,
                backend_name=backend.name,
                options={
                    "pub_options": pub_options_by_job[job_index],
                    "save_backend_info": True,
                },
            )
        )
except Exception:
    runtime_batch.close()
    raise

{
    "runtime_batch_id": runtime_batch.session_id,
    "jobs": {
        job_index: {
            "backend": backend.name,
            "function_job_id": job.job_id,
            "status": job.status(),
            "n_values": N_GROUPS[job_index],
            "num_pubs": len(pubs_by_job[job_index]),
        }
        for job_index, job in enumerate(jobs)
    },
}
Output:
{'runtime_batch_id': '80120e36-436d-46c7-96c9-597ec86060c1',
 'jobs': {0: {'backend': 'ibm_aachen',
   'function_job_id': '2b6b05ac-0136-40f0-94bf-ade5658f5f4f',
   'status': 'QUEUED',
   'n_values': [40, 2, 7, 15, 10],
   'num_pubs': 300},
  1: {'backend': 'ibm_aachen',
   'function_job_id': '4f046fd4-80e4-460b-87c7-e7252691f764',
   'status': 'QUEUED',
   'n_values': [35, 3, 6, 20, 9],
   'num_pubs': 300},
  2: {'backend': 'ibm_aachen',
   'function_job_id': '6d70d64d-fa38-4ca2-9cbd-ffda5d8c99be',
   'status': 'QUEUED',
   'n_values': [30, 4, 5, 25, 8],
   'num_pubs': 300}}}
결과를 가져오고 처리 정확도를 계산합니다
각 큐비트 그룹의 결과를 개별적으로 가져와 유효성을 확인한 다음, 세 개의 작업 스트림을 해당 작업 인덱스 기록에 따라 병합합니다. 배치는 모든 함수 결과가 요청되는 동안 열린 상태로 유지되며, 모든 작업의 실행 시도가 완료된 후 한 finally 번에 닫힙니다. 각 PUB 에 대해, 는 예상 비트열에 할당된 확률이다. dynamic/orbit``extract_counts 호출자에게 반환된 카운트를 읽습니다. 의 경우, 이는 완화 조치가 성공했을 때 MEM으로 조정된 카운트입니다. extract_raw_counts 또한 Orbit 메타데이터에 기록된 해당 완화되지 않은 카운트 값도 복원합니다. 이 코드는 각 (N, label) 쌍에 대해 의 20개 값을 그룹화하고, 앞서 소개한 추정기를 적용합니다.
dynamic/orbit``dynamic/raw따라서 그래프에 표시된 process_fidelity 사전은 와 에 대해서는 unitary/raw 원시 집계 수치를 사용하지만, 에 대해서는 MEM 조정 집계 수치를 사용합니다. 병렬 raw_process_fidelity 사전은 모든 전략에 대해 수정되지 않은 계산 결과를 유지하며, MEM의 영향을 Orbit 파이프라인의 나머지 부분과 분리하여 분석할 때 유용합니다. MEM은 반환된 출력 히스토그램을 보정하지만, 실시간 피드포워드에서 이미 사용된 회로 중간 측정 결과를 소급하여 변경할 수는 없습니다.
def extract_counts(pub_result) -> dict[str, int]:
    data = getattr(pub_result, "data", None)
    if data is None:
        raise TypeError("pub_result.data is missing")

    for name in dir(data):
        if name.startswith("_"):
            continue
        register = getattr(data, name)
        get_counts = getattr(register, "get_counts", None)
        if callable(get_counts):
            counts = get_counts()
            if counts:
                return counts

    raise TypeError(
        "No classical register with get_counts() found in pub_result.data"
    )


def extract_raw_counts(pub_result) -> dict[str, int]:
    orbit_metadata = pub_result.metadata.get("quantum_elements_orbit", {})
    mem_report = orbit_metadata.get("measurementErrorMitigation", {})
    return mem_report.get("rawCounts") or extract_counts(pub_result)


def probability_for_bitstring(
    counts: dict[str, int], bitstring: str, n_qubits: int
) -> float:
    total = sum(counts.values())
    if total <= 0:
        return 0.0
    normalized = Counter()
    for measured, count in counts.items():
        key = measured.replace(" ", "")[-n_qubits:].zfill(n_qubits)
        normalized[key] += count
    return float(normalized.get(bitstring, 0) / total)


results_by_job = {}
job_failures = []
try:
    for job_index, job in enumerate(jobs):
        try:
            job_result = job.result()
        except Exception as exc:
            job_logs = getattr(job, "logs", lambda: "")()
            if job_logs:
                print(f"Logs for job {job_index} ({job.job_id}):\n{job_logs}")
            job_failures.append(
                f"job {job_index} ({job.job_id}) failed: {type(exc).__name__}: {exc}"
            )
            continue

        expected_results = len(pub_records_by_job[job_index])
        if len(job_result) != expected_results:
            job_failures.append(
                f"job {job_index} ({job.job_id}) returned {len(job_result)} PUB results; "
                f"expected {expected_results}"
            )
            continue
        results_by_job[job_index] = job_result
finally:
    runtime_batch.close()

if job_failures:
    raise RuntimeError(
        "One or more batched Orbit jobs failed:\n" + "\n".join(job_failures)
    )

grouped_success = defaultdict(list)
grouped_raw_success = defaultdict(list)
pub_summaries = []

for job_index, job_result in sorted(results_by_job.items()):
    records = pub_records_by_job[job_index]
    for record, pub_result in zip(records, job_result, strict=True):
        label = record["label"]
        n_qubits = record["n_qubits"]
        counts = extract_counts(pub_result)
        raw_counts = extract_raw_counts(pub_result)
        success = probability_for_bitstring(
            counts, record["target_bitstring"], n_qubits
        )
        raw_success = probability_for_bitstring(
            raw_counts, record["target_bitstring"], n_qubits
        )
        key = (n_qubits, label)
        grouped_success[key].append(success)
        grouped_raw_success[key].append(raw_success)

        orbit_report = pub_result.metadata.get("quantum_elements_orbit", {})
        mem_report = orbit_report.get("measurementErrorMitigation", {})
        pub_summaries.append(
            {
                **record,
                "function_job_id": jobs[job_index].job_id,
                "runtime_batch_id": runtime_batch.session_id,
                "success_probability": success,
                "raw_success_probability": raw_success,
                "orbit_mode": orbit_report.get("mode"),
                "transpilation_mode": orbit_report.get("transpilationMode"),
                "physical_layout": orbit_report.get("physicalLayout"),
                "dd_status": orbit_report.get("status", "not_applied"),
                "num_sequences_added": orbit_report.get(
                    "numSequencesAdded", 0
                ),
                "num_gaps_filled": orbit_report.get("numGapsFilled", 0),
                "dynamic_dd_seq": orbit_report.get("dynamicDdSeq"),
                "mem_status": mem_report.get("status", "not_requested"),
                "warnings": orbit_report.get("warnings", [])
                + mem_report.get("warnings", []),
            }
        )

process_fidelity = defaultdict(dict)
raw_process_fidelity = defaultdict(dict)
mean_success_probability = defaultdict(dict)
raw_mean_success_probability = defaultdict(dict)

for (n_qubits, label), probabilities in sorted(grouped_success.items()):
    n_key = str(n_qubits)
    process_fidelity[n_key][label] = (
        process_fidelity_from_success_probabilities(probabilities)
    )
    mean_success_probability[n_key][label] = float(np.mean(probabilities))

for (n_qubits, label), probabilities in sorted(grouped_raw_success.items()):
    n_key = str(n_qubits)
    raw_process_fidelity[n_key][label] = (
        process_fidelity_from_success_probabilities(probabilities)
    )
    raw_mean_success_probability[n_key][label] = float(np.mean(probabilities))

process_fidelity = dict(process_fidelity)
raw_process_fidelity = dict(raw_process_fidelity)
mean_success_probability = dict(mean_success_probability)
raw_mean_success_probability = dict(raw_mean_success_probability)

{
    "runtime_batch_id": runtime_batch.session_id,
    "function_job_ids": {
        job_index: job.job_id for job_index, job in enumerate(jobs)
    },
    "n_groups": {
        job_index: group for job_index, group in enumerate(N_GROUPS)
    },
    "process_fidelity": process_fidelity,
    "mean_success_probability": mean_success_probability,
}
Output:
{'runtime_batch_id': '80120e36-436d-46c7-96c9-597ec86060c1',
 'function_job_ids': {0: '2b6b05ac-0136-40f0-94bf-ade5658f5f4f',
  1: '4f046fd4-80e4-460b-87c7-e7252691f764',
  2: '6d70d64d-fa38-4ca2-9cbd-ffda5d8c99be'},
 'n_groups': {0: [40, 2, 7, 15, 10],
  1: [35, 3, 6, 20, 9],
  2: [30, 4, 5, 25, 8]},
 'process_fidelity': {'2': {'dynamic/orbit': 0.9870551835473073,
   'dynamic/raw': 0.9912537998030566,
   'unitary/raw': 0.9884650767434809},
  '3': {'dynamic/orbit': 0.9662998634131841,
   'dynamic/raw': 0.9699631603283018,
   'unitary/raw': 0.9388637172865901},
  '4': {'dynamic/orbit': 0.9271266520750502,
   'dynamic/raw': 0.7334377020091254,
   'unitary/raw': 0.9010122207121433},
  '5': {'dynamic/orbit': 0.8883501513887149,
   'dynamic/raw': 0.6577660260669806,
   'unitary/raw': 0.7806443417987445},
  '6': {'dynamic/orbit': 0.8524225652033044,
   'dynamic/raw': 0.4444025126308521,
   'unitary/raw': 0.7167426842521228},
  '7': {'dynamic/orbit': 0.832962085697061,
   'dynamic/raw': 0.2253787798698553,
   'unitary/raw': 0.5746335601063436},
  '8': {'dynamic/orbit': 0.7881895956180588,
   'dynamic/raw': 0.16909516699831612,
   'unitary/raw': 0.5408263851227074},
  '9': {'dynamic/orbit': 0.7422635627368794,
   'dynamic/raw': 0.0242474245097341,
   'unitary/raw': 0.4855953298367578},
  '10': {'dynamic/orbit': 0.7002274273149545,
   'dynamic/raw': 0.033718865729016285,
   'unitary/raw': 0.3607634828181049},
  '15': {'dynamic/orbit': 0.4694995355699914,
   'dynamic/raw': 7.70970394736842e-05,
   'unitary/raw': 0.054582117352985286},
  '20': {'dynamic/orbit': 0.24118032284867608,
   'dynamic/raw': 4.235164736271502e-22,
   'unitary/raw': 0.0},
  '25': {'dynamic/orbit': 0.027122712989729438,
   'dynamic/raw': 0.0,
   'unitary/raw': 0.0},
  '30': {'dynamic/orbit': 0.0003581886014704875,
   'dynamic/raw': 0.0,
   'unitary/raw': 0.0},
  '35': {'dynamic/orbit': 0.0, 'dynamic/raw': 0.0, 'unitary/raw': 0.0},
  '40': {'dynamic/orbit': 0.0, 'dynamic/raw': 0.0, 'unitary/raw': 0.0}},
 'mean_success_probability': {'2': {'dynamic/orbit': 0.987060546875,
   'dynamic/raw': 0.991259765625,
   'unitary/raw': 0.9884765625},
  '3': {'dynamic/orbit': 0.96630859375,
   'dynamic/raw': 0.969970703125,
   'unitary/raw': 0.939013671875},
  '4': {'dynamic/orbit': 0.9271484375,
   'dynamic/raw': 0.7337890625,
   'unitary/raw': 0.901318359375},
  '5': {'dynamic/orbit': 0.88837890625,
   'dynamic/raw': 0.657861328125,
   'unitary/raw': 0.78115234375},
  '6': {'dynamic/orbit': 0.85244140625,
   'dynamic/raw': 0.44453125,
   'unitary/raw': 0.71728515625},
  '7': {'dynamic/orbit': 0.8330078125,
   'dynamic/raw': 0.22568359375,
   'unitary/raw': 0.575390625},
  '8': {'dynamic/orbit': 0.788232421875,
   'dynamic/raw': 0.169189453125,
   'unitary/raw': 0.541796875},
  '9': {'dynamic/orbit': 0.742333984375,
   'dynamic/raw': 0.0244140625,
   'unitary/raw': 0.487353515625},
  '10': {'dynamic/orbit': 0.70029296875,
   'dynamic/raw': 0.033935546875,
   'unitary/raw': 0.363037109375},
  '15': {'dynamic/orbit': 0.4697265625,
   'dynamic/raw': 0.00029296875,
   'unitary/raw': 0.055615234375},
  '20': {'dynamic/orbit': 0.241357421875,
   'dynamic/raw': 4.8828125e-05,
   'unitary/raw': 0.0},
  '25': {'dynamic/orbit': 0.041015625, 'dynamic/raw': 0.0, 'unitary/raw': 0.0},
  '30': {'dynamic/orbit': 0.0013671875,
   'dynamic/raw': 0.0,
   'unitary/raw': 0.0},
  '35': {'dynamic/orbit': 0.0, 'dynamic/raw': 0.0, 'unitary/raw': 0.0},
  '40': {'dynamic/orbit': 0.0, 'dynamic/raw': 0.0, 'unitary/raw': 0.0}}}
Orbit DD 메타데이터 확인
아래 요약은 요청된 DD가 삽입되었다고 가정하지 않고, dynamic/orbitPUB 메타데이터를 확인합니다. 상태, 보고된 동적 DD 시퀀스, 경고 사항, 그리고 메워진 갭의 수와 추가된 시퀀스의 수를 확인하십시오. 삽입이 성공하면 적어도 일부 PUB에 대해서는 0이 아닌 카운트 값이 산출되어야 하지만, 정확한 값은 스케줄링된 회로, 백엔드 타이밍 제약 조건 및 회로 크기에 따라 달라집니다. 이 메타데이터는 Orbit에 적용된 순서를 설명하는 것으로, 해당 보고서가 그 동등성을 명시적으로 입증하지 않는 한, 이를 논문의 FC-DD 프로토콜로 표기해서는 안 됩니다.
dd_summary = defaultdict(lambda: Counter())
sequence_totals = defaultdict(int)
warning_examples = []

for summary in pub_summaries:
    if summary["label"] != "dynamic/orbit":
        continue
    n_key = str(summary["n_qubits"])
    dd_summary[n_key][summary["dd_status"]] += 1
    sequence_totals[n_key] += int(summary.get("num_sequences_added") or 0)
    if summary.get("warnings") and len(warning_examples) < 5:
        warning_examples.append(
            {
                "n_qubits": summary["n_qubits"],
                "target_decimal": summary["target_decimal"],
                "warnings": summary["warnings"],
            }
        )

{
    "dynamic_orbit_dd_status_counts": {
        key: dict(value) for key, value in dd_summary.items()
    },
    "dynamic_orbit_sequences_added": dict(sequence_totals),
    "warning_examples": warning_examples,
}
Output:
{'dynamic_orbit_dd_status_counts': {'40': {'dd_inserted': 20},
  '2': {'dd_inserted': 20},
  '7': {'dd_inserted': 20},
  '15': {'dd_inserted': 20},
  '10': {'dd_inserted': 20},
  '35': {'dd_inserted': 20},
  '3': {'dd_inserted': 20},
  '6': {'dd_inserted': 20},
  '20': {'dd_inserted': 20},
  '9': {'dd_inserted': 20},
  '30': {'dd_inserted': 20},
  '4': {'dd_inserted': 20},
  '5': {'dd_inserted': 20},
  '25': {'dd_inserted': 20},
  '8': {'dd_inserted': 20}},
 'dynamic_orbit_sequences_added': {'40': 31200,
  '2': 40,
  '7': 840,
  '15': 4200,
  '10': 1800,
  '35': 23800,
  '3': 120,
  '6': 600,
  '20': 7600,
  '9': 1440,
  '30': 17400,
  '4': 240,
  '5': 400,
  '25': 12000,
  '8': 1120},
 'warning_examples': [{'n_qubits': 40,
   'target_decimal': 853235401719,
   'warnings': ['Post-DD x/y pulses are rewritten into the target basis (e.g. sx) for ISA compliance; this shifts exact pulse timing within each gap, so DD spacing is approximate. A future release will emit native pulses directly.',
    'MEM was applied unconditionally to the returned output bitstring without inferring whether each bit came from a terminal measurement or a mid-circuit measurement. This is meaningful for bits intended as circuit outputs, but Orbit does not retroactively or in real time change conditional branches that used unmitigated measurement results.']},
  {'n_qubits': 40,
   'target_decimal': 954673909846,
   'warnings': ['Post-DD x/y pulses are rewritten into the target basis (e.g. sx) for ISA compliance; this shifts exact pulse timing within each gap, so DD spacing is approximate. A future release will emit native pulses directly.',
    'MEM was applied unconditionally to the returned output bitstring without inferring whether each bit came from a terminal measurement or a mid-circuit measurement. This is meaningful for bits intended as circuit outputs, but Orbit does not retroactively or in real time change conditional branches that used unmitigated measurement results.']},
  {'n_qubits': 40,
   'target_decimal': 524641045908,
   'warnings': ['Post-DD x/y pulses are rewritten into the target basis (e.g. sx) for ISA compliance; this shifts exact pulse timing within each gap, so DD spacing is approximate. A future release will emit native pulses directly.',
    'MEM was applied unconditionally to the returned output bitstring without inferring whether each bit came from a terminal measurement or a mid-circuit measurement. This is meaningful for bits intended as circuit outputs, but Orbit does not retroactively or in real time change conditional branches that used unmitigated measurement results.']},
  {'n_qubits': 40,
   'target_decimal': 185651043478,
   'warnings': ['Post-DD x/y pulses are rewritten into the target basis (e.g. sx) for ISA compliance; this shifts exact pulse timing within each gap, so DD spacing is approximate. A future release will emit native pulses directly.',
    'MEM was applied unconditionally to the returned output bitstring without inferring whether each bit came from a terminal measurement or a mid-circuit measurement. This is meaningful for bits intended as circuit outputs, but Orbit does not retroactively or in real time change conditional branches that used unmitigated measurement results.']},
  {'n_qubits': 40,
   'target_decimal': 587114273567,
   'warnings': ['Post-DD x/y pulses are rewritten into the target basis (e.g. sx) for ISA compliance; this shifts exact pulse timing within each gap, so DD spacing is approximate. A future release will emit native pulses directly.',
    'MEM was applied unconditionally to the returned output bitstring without inferring whether each bit came from a terminal measurement or a mid-circuit measurement. This is meaningful for bits intended as circuit outputs, but Orbit does not retroactively or in real time change conditional branches that used unmitigated measurement results.']}]}
공정 충실도 곡선 그리기
이 그래프는 세 가지 전략에 대해, 샘플링된 QFT+M 과정의 충실도 점 추정치를 큐비트 수에 따라 나타낸 것입니다. dynamic/raw 그리고 dynamic/orbit 각 크기별로 물리적 레이아웃을 공유하며, unitary/raw 트랜스파일러의 레이아웃과 라우팅을 사용합니다.
그림 2a 과 달리, 이 그래프에는 DD를 적용한 단일 곡선이나 불확실성 대역이 표시되어 있지 않으며, 원본 곡선에는 판독 오차 보정이 적용되지 않았습니다. 이 내용은 발표된 곡선을 그대로 재현한 것이 아니라, 이 Orbit 워크플로우에 대한 ‘ Figure-2a-style ’ 스케일링 비교로 이해하는 것이 가장 좋습니다.
from datetime import datetime
from zoneinfo import ZoneInfo

closed_at = runtime_batch.details()["closed_at"]  # "2026-07-22T00:08:54.89Z"
closed_dt = datetime.fromisoformat(closed_at.replace("Z", "+00:00"))
closed_local = closed_dt.astimezone(ZoneInfo("America/Los_Angeles"))
labels = ["dynamic/orbit", "dynamic/raw", "unitary/raw"]
colors = {
"dynamic/orbit": "#26735b",
"dynamic/raw": "#9b1c31",
"unitary/raw": "#6e6e6e",
}
pretty_labels = {
"dynamic/orbit": "Dynamic QFT+M with Orbit",
"dynamic/raw": "Dynamic QFT+M",
"unitary/raw": "Unitary QFT+M",
}
series = []
for label in labels:
values = [process_fidelity[str(n)][label] for n in N_VALUES]
log_values = [value if value > 0.0 else float("nan") for value in values]
series.append((label, values, log_values))
nonzero_values = [
value
for _, _, log_values in series
for value in log_values
if value > 0.0
]
if not nonzero_values:
raise RuntimeError(
"No nonzero process-fidelity values found for log inset"
)
log_floor = min(nonzero_values) / 2
fig, ax = plt.subplots(figsize=(9.8, 5.6))
for label, values, _ in series:
ax.plot(
N_VALUES,
values,
marker="o",
linewidth=2.0,
markersize=5,
color=colors[label],
label=pretty_labels[label],
)
ax.set_xlabel("N qubits")
ax.set_ylabel("Process fidelity")
finished_time_for_title = globals().get("finished_local", closed_local)
ax.set_title(
f"Dynamic QFT Orbit results on {IBM_BACKEND_NAME}\n"
f"Job finished {finished_time_for_title:%Y-%m-%d %H:%M %Z}"
)
ax.set_xticks(N_VALUES)
ax.set_ylim(bottom=0)
ax.grid(axis="both", alpha=0.25)
ax.legend(loc="upper right")
inset = ax.inset_axes([0.53, 0.31, 0.44, 0.43])
for label, _, log_values in series:
inset.plot(
N_VALUES,
log_values,
marker="o",
linewidth=2.0,
markersize=5,
color=colors[label],
)
inset.set_yscale("log")
inset.set_ylim(bottom=log_floor)
inset.set_xlim(min(N_VALUES), max(N_VALUES))
inset.set_title("Log scale; zeros omitted", fontsize=9)
inset.grid(axis="both", alpha=0.25)
inset.tick_params(axis="both", labelsize=8)
inset.patch.set_alpha(0.96)
fig.tight_layout()
plt.show()Output:
참조
다음 단계
- Orbit 가이드와 API 참조 문서를 확인해 주세요.
- 다른 백엔드나 대체 레이아웃을 사용해 보거나, 옵션을
dd_strategy변경하여 궤도 기반 동적 분리 시퀀스를 실험해 보세요. 동적 회로는 실험적인 성격을 띠고 있으므로, 발생할 수 있는 작업 실패 양상에 주의해야 한다는 점을 명심하십시오( [3] 및 [4] 참조). 음의 스트레치 값 [3] 이 나타나면, 더 작은(펄스 수가 적은) DD 시퀀스를 시도해 보십시오.N_VALUES``M``NUM_BATCH_JOBS[4] 가 발생하면, 을 늘리거나, 을 줄이거나, 의 가장 큰 값들을 줄이십시오.