양자 커널 훈련
예상 소요 시간: Heron r3 프로세서 기준 1분 미만 (참고: 이는 예상치에 불과합니다.) (실행 시간은 다를 수 있습니다.)
학습 성과
- 커널 방법과 그 활용
- 양자 커널과 이를 통해 향상된 특징 공간을 제공하는 방법
- 양자 커널 회로 구성
- Qiskit 패턴 을 사용하여 양자 커널을 훈련하는 방법: 매핑, 최적화, 실행 및 사후 처리
전제조건
- 양자 커널: 그 중요성과 실제 활용 사례
- 군 구조를 갖는 데이터를 위한 공변 양자 커널 (논문)
- 양자 커널과 서포트 벡터 머신 개론 (동영상)
- 실무에서의 양자 커널 (동영상)
군론에 대한 기본적인 이해를 갖추는 것도 도움이 됩니다.
배경
커널 기법은 머신러닝 응용 분야에서 흔히 사용됩니다. 이 맥락에서 “커널”은 커널 행렬 또는 그 안의 개별 원소를 의미합니다. 일반적으로 커널은 고차원 특징 공간 에 인코딩된 데이터 간의 유사도 측정 기준이며, 예를 들어 서포트 벡터 머신(SVM)을 활용한 분류 작업에 활용될 수 있다.
양자 커널 방법은 양자 컴퓨터를 사용하여 커널을 추정하는 방법입니다. 양자 컴퓨터는 양자 강화된 특징 공간에 데이터를 인코딩할 수 있어, 사실상 기존 아날로그 방식을 대체할 수 있는 것으로 알려져 있다. 와 의 경우, 일반적으로 와 함께 사용되며, 는 특징 맵이고, 입니다. 의 목표는 데이터를 초평면으로 구분하는 것입니다. 특징 매핑 공간의 벡터들을 인수로 받아, 커널 함수 는 이들의 내적을 반환합니다: . 전통적으로, 관심 있는 특징 매핑은 커널 함수를 쉽게 계산할 수 있는 경우입니다; 즉, 특징 매핑 공간에서의 내적을 원본 데이터 벡터들로 표현할 수 있고, 및 를 별도로 구성할 필요가 없는 경우를 말합니다. 양자 커널의 경우, 특징 매핑은 양자 회로에 의해 수행되며, 회로에서 추출된 측정 확률을 사용하여 커널을 추정합니다.
이 튜토리얼에서는 이진 분류에 사용되는 양자 커널 행렬의 입력값을 평가하기 위한 Qiskit 패턴을 구축하는 방법을 설명합니다.
요구사항
이 튜토리얼을 시작하기 전에 다음이 설치되어 있는지 확인하세요:
- Qiskit SDK v2.3.1 또는 그 이후 버전, 시각화 기능 지원
- Qiskit Runtime v0.44.0 또는 그 이후 (
pip install qiskit-ibm-runtime)
설정
# General Imports and helper functions
import urllib.request

import pandas as pd
import numpy as np
import matplotlib.pyplot as plt


from qiskit.circuit import Parameter, ParameterVector, QuantumCircuit
from qiskit.circuit.library import unitary_overlap
from qiskit.primitives import StatevectorSampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService, Sampler

# Download the dataset (portable across platforms)
urllib.request.urlretrieve(
    "https://raw.githubusercontent.com/qiskit-community/prototype-quantum-kernel-training/main/data/dataset_graph7.csv",
    "dataset_graph7.csv",
)


def visualize_counts(res_counts, num_qubits, num_shots):
    """Visualize the outputs from the Qiskit Sampler primitive."""
    zero_prob = res_counts.get(0, 0.0)
    top_10 = dict(
        sorted(res_counts.items(), key=lambda item: item[1], reverse=True)[
            :10
        ]
    )
    top_10.update({0: zero_prob})
    by_key = dict(sorted(top_10.items(), key=lambda item: item[0]))
    x_vals, y_vals = list(zip(*by_key.items()))
    x_vals = [bin(x_val)[2:].zfill(num_qubits) for x_val in x_vals]
    y_vals_prob = []
    for t in range(len(y_vals)):
        y_vals_prob.append(y_vals[t] / num_shots)
    y_vals = y_vals_prob
    plt.bar(x_vals, y_vals)
    plt.xticks(rotation=75)
    plt.title("Results of sampling")
    plt.xlabel("Measured bitstring")
    plt.ylabel("Probability")
    plt.show()


def get_training_data():
    """Read the training data."""
    df = pd.read_csv("dataset_graph7.csv", sep=",", header=None)
    training_data = df.values[:20, :]
    ind = np.argsort(training_data[:, -1])
    X_train = training_data[ind][:, :-1]

    return X_train
소규모 시뮬레이터 예시
이 섹션에서는 오류가 있는 코셋 라벨링(labeling-cosets-with-error) 문제를 7큐비트 인스턴스에 적용하여 Qiskit 패턴의 네 단계를 단계별로 살펴보고, Qiskit의 프라이머리(primitive)를 StatevectorSampler 사용하여 커널 행렬의 단일 요소를 평가합니다. 상태 벡터 시뮬레이터는 (샷 노이즈 수준에서) 정확하며, QPU 시간을 소모하지 않고도 전체 과정을 보여줍니다. 그런 다음 하드웨어 예제 섹션에서 실제 하드웨어에서 동일한 과정을 반복합니다.
1단계: 고전적 입력을 양자 문제에 매핑하기
- 입력: 학습 데이터 세트.
- 출력: 커널 행렬 항목을 계산하기 위한 추상 회로입니다.
여기서 해결하고자 하는 이진 분류 문제는 “오류를 동반한 몫집합 라벨링”이라고 불립니다 입력 훈련 데이터셋은 군과 부분군으로 구성된 두 개의 몫집합으로 이루어진 군 구조를 포함하고 있습니다. 이 군은 양자 비트(qubit)에 대해 로 정의되며, 이는 행렬로 이루어진 특수한 유니터리 군으로, 자연계에서 광범위하게 적용됩니다. 예를 들어, 입자 물리학의 표준 모델이 이에 해당합니다. 가장자리 와 정점 를 갖는 그래프에 대해, (그래프 안정화자) 부분군 를 취하고, 를 정의한다. 안정화자들은 를 만족하는 안정화자 상태를 고정한다는 점에 유의하라. 마지막으로, 두 개의 를 무작위로 선택하여 두 개의 좌측 몫집합 를 정의한다.
데이터셋과 그 생성 방법에 대한 자세한 내용은 Quantum Kernel Training Toolkit의 이 노트북을 참조하십시오.
우리는 커널 행렬의 한 요소를 계산하는 데 사용되는 양자 회로를 생성합니다.
입력 데이터는 회로의 매개변수화 게이트에 대한 회전 각도를 결정하는 데 사용됩니다.
간단함을 위해 데이터 표본 x1=14 와 x2=19를 사용하겠습니다.
참고: 이 튜토리얼에 사용된 데이터 세트는 여기에서 다운로드할 수 있습니다.
# Prepare training data
X_train = get_training_data()

# Empty kernel matrix
num_samples = np.shape(X_train)[0]
kernel_matrix = np.full((num_samples, num_samples), np.nan)

# Prepare feature map for computing overlap
num_features = np.shape(X_train)[1]
num_qubits = int(num_features / 2)
entangler_map = [[0, 2], [3, 4], [2, 5], [1, 4], [2, 3], [4, 6]]
fm = QuantumCircuit(num_qubits)
training_param = Parameter("θ")
feature_params = ParameterVector("x", num_qubits * 2)
fm.ry(training_param, fm.qubits)
for cz in entangler_map:
    fm.cz(cz[0], cz[1])
for i in range(num_qubits):
    fm.rz(-2 * feature_params[2 * i + 1], i)
    fm.rx(-2 * feature_params[2 * i], i)

# Assign tunable parameter to known optimal value and set the data params for
# first two samples
x1 = 14
x2 = 19
unitary1 = fm.assign_parameters(list(X_train[x1]) + [np.pi / 2])
unitary2 = fm.assign_parameters(list(X_train[x2]) + [np.pi / 2])

# Create the overlap circuit
overlap_circ = unitary_overlap(unitary1, unitary2)
overlap_circ.measure_all()
overlap_circ.draw("mpl", scale=0.6, style="iqp")
Output:

2단계: 양자 하드웨어 실행을 위한 문제 최적화
- 입력: 추상 회로로, 특정 백엔드에 최적화되지 않았습니다.
- 출력: 선택한 QPU에 최적화된 대상 회로.
이 섹션에서 사용하는 상태 벡터 시뮬레이터 경로의 경우, 백엔드별 최적화가 필요하지 않으며, 추상 회로를 직접 샘플링할 수 있습니다. optimization_level=3아래 하드웨어 예제에서 이 단계를 실행해 보겠습니다. 이 예제에서는 실제 QPU를 대상으로 회로를 트랜스파일링하며, 이때 와 를 사용합니다 generate_preset_pass_manager .
3단계: Qiskit primitives 명령어로 실행합니다
- 입력: 추상 회로.
- 출력: 준확률 분포.
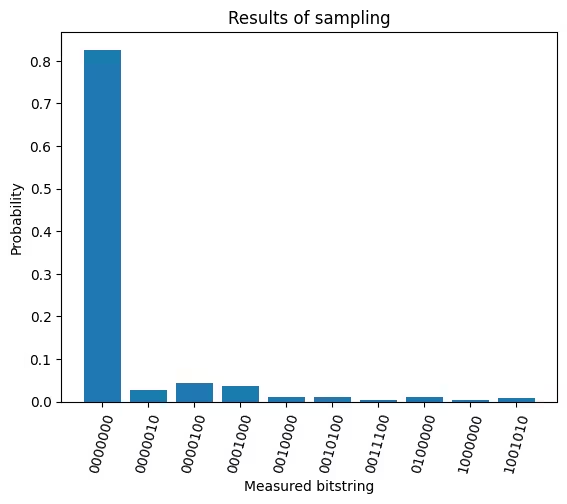
Qiskit의 프라이머리(primitive)를 StatevectorSampler 사용하여 회로 샘플링을 통해 도출된 상태의 준확률 분포를 재구성합니다. 커널 행렬을 생성하는 작업에서, 우리는 특히 |0> 상태를 관측할 확률에 관심을 두고 있습니다.
sampler = StatevectorSampler()

# Execute and get counts
num_shots = 10_000
results = sampler.run([overlap_circ], shots=num_shots).result()
counts = results[0].data.meas.get_int_counts()

# Plot counts
visualize_counts(counts, num_qubits, num_shots)
Output:
4단계: 후처리 수행 및 원하는 클래식 형식으로 결과 반환
- 입력: 확률 분포.
- 출력: 단일 커널 행렬 요소.
중첩 회로에서 가 측정될 확률을 계산하고, 이 특정 중첩 회로가 나타내는 샘플에 해당하는 위치(15행, 20열)에 커널 행렬을 채워 넣으십시오.
kernel_matrix[x1, x2] = counts.get(0, 0.0) / num_shots
print(f"Fidelity (simulator): {kernel_matrix[x1, x2]}")
Output:
Fidelity (simulator): 0.8261
하드웨어 예시
양자 커널 행렬은 개의 훈련 샘플에 대해 개의 요소를 가지며, 각 요소를 처리하려면 특징 맵의 크기에 따라 2-큐비트 게이트의 깊이가 증가하는 오버랩 회로를 실행해야 한다. 결과적으로, 이 튜토리얼을 더 큰 문제로 확장할 경우 두 가지 복합적인 비용이 발생합니다. 즉, 커널 행렬당 QPU 처리 시간은 에 따라 2차 함수적으로 증가하며, (특징 맵과 그 공역 행렬을 합성하는) 깊이는 unitary_overlap 현재 하드웨어의 시스템 규모와 연결성에서 정확도를 저하시킵니다. 데모를 간결하게 유지하고 명확한 비교를 위해, 우리는 소규모 예제에서 사용된 것과 동일한 7큐비트 인스턴스를 실제 QPU에서 실행하고, 단일 커널 행렬 요소의 충실도를 앞서 계산한 시뮬레이터 값과 비교합니다.
# ------------------------------ Step 1 ------------------------------
# Prepare training data
X_train = get_training_data()

# Empty kernel matrix
num_samples = np.shape(X_train)[0]
kernel_matrix = np.full((num_samples, num_samples), np.nan)

# Prepare feature map for computing overlap
num_features = np.shape(X_train)[1]
num_qubits = int(num_features / 2)
entangler_map = [[0, 2], [3, 4], [2, 5], [1, 4], [2, 3], [4, 6]]
fm = QuantumCircuit(num_qubits)
training_param = Parameter("θ")
feature_params = ParameterVector("x", num_qubits * 2)
fm.ry(training_param, fm.qubits)
for cz in entangler_map:
    fm.cz(cz[0], cz[1])
for i in range(num_qubits):
    fm.rz(-2 * feature_params[2 * i + 1], i)
    fm.rx(-2 * feature_params[2 * i], i)

# Assign tunable parameter to known optimal value and
# set the data params for first two samples
x1 = 14
x2 = 19
unitary1 = fm.assign_parameters(list(X_train[x1]) + [np.pi / 2])
unitary2 = fm.assign_parameters(list(X_train[x2]) + [np.pi / 2])

# Create the overlap circuit
overlap_circ = unitary_overlap(unitary1, unitary2)
overlap_circ.measure_all()

# ------------------------------ Step 2 ------------------------------
service = QiskitRuntimeService()
# backend = service.least_busy(
#    operational=True, simulator=False, min_num_qubits=overlap_circ.num_qubits
# )
backend = service.backend("ibm_pittsburgh")
print(f"Using backend: {backend.name}")
pm = generate_preset_pass_manager(optimization_level=3, backend=backend)
overlap_ibm = pm.run(overlap_circ)

# ------------------------------ Step 3 ------------------------------
sampler = Sampler(mode=backend)
sampler.options.environment.job_tags = ["TUT_QKT"]

num_shots = 10_000
results = sampler.run([overlap_ibm], shots=num_shots).result()
counts = results[0].data.meas.get_int_counts()
visualize_counts(counts, num_qubits, num_shots)

# ------------------------------ Step 4 ------------------------------
kernel_matrix[x1, x2] = counts.get(0, 0.0) / num_shots
print(f"Fidelity (hardware): {kernel_matrix[x1, x2]}")
Output:
Using backend: ibm_pittsburgh

Fidelity (hardware): 0.7517
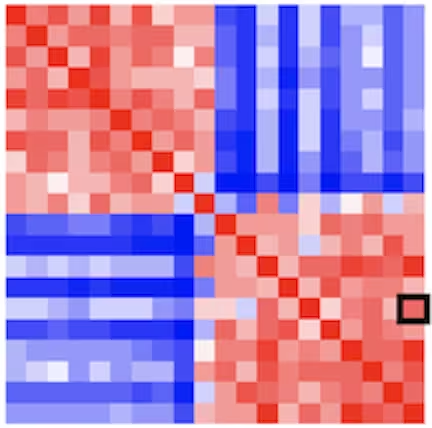
커널 행렬 전체를 채우려면, 그 고유 원소 각각에 대해 양자 실험을 수행해야 합니다. 아래 그림은 이 데이터셋에 대한 결과 행렬을 보여줍니다. 붉은색이 진할수록 1.0 에 더 가까운 정확도를 나타냅니다.
다음 단계
이 글이 흥미로웠다면, 다음 자료도 참고해 보시기 바랍니다:
- Quantum Kernel Training Toolkit - 이 튜토리얼의 기반이 되는 프로토타입 저장소
- Machine Learning 애플리케이션을 위한 양자 커널 훈련 - 훈련 가능한 매개변수를 훈련하는 방법을 보여주는 Qiskit Machine Learning 튜토리얼
- 양자 머신 러닝 입문: 양자 머신 러닝( Machine Learning ) 강좌
- IBM Research 의 양자 기계 학습 ( Machine Learning ) - IBM 에서 진행 중인 QML 연구 개요
- 군 구조를 가진 데이터를 위한 공변 양자 커널 - 이 튜토리얼의 기초가 된 논문