양자 알고리즘: 변분 양자 알고리즘
이마미치 타카시 (2024년 5월 24일)
원본 강의의 PDF를 다운로드하세요. 일부 코드 스니펫은 정적 이미지이므로 더 이상 사용되지 않을 수 있습니다.
이 실험을 실행하는 데 걸리는 대략적인 QPU 시간은 9분입니다(Eagle 프로세서에서 테스트).
(이 노트북은 오픈 플랜에서 허용된 시간 내에 평가되지 않을 수 있습니다. 양자 컴퓨팅 리소스를 현명하게 사용하세요.)
1. 소개
이 튜토리얼에서는 하이브리드 양자-클래식 알고리즘에 대한 개요를 제공하며, 특히 가변 양자 아이겐솔버(VQE)와 양자 근사 최적화 알고리즘(QAOA)에 중점을 둡니다. 이러한 알고리즘의 주요 목표는 파라미터화된 양자 게이트가 있는 양자 회로를 사용하여 최적화 문제를 해결하는 것입니다.
양자 컴퓨팅의 발전에도 불구하고 현재 양자 디바이스에는 노이즈가 존재하기 때문에 심층 양자 회로에서 의미 있는 결과를 추출하는 것이 어렵습니다. 이러한 문제를 극복하기 위해 VQE와 QAOA는 양자 계산을 사용하여 비교적 짧은 양자 회로를 반복적으로 실행하고 고전 계산을 사용하여 목표 파라미터화된 양자 회로의 파라미터를 최적화하는 하이브리드 양자-클래식 접근 방식을 채택합니다.
QAOA는 다양한 오류 완화 및 억제 기술을 적용하여 유틸리티 규모에서 대상 문제에 대한 최적의 솔루션을 제공할 수 있는 잠재력을 가지고 있습니다. VQE는 양자 화학처럼 확장성이 떨어지는 응용 분야가 많습니다. 하지만 크릴로프 아공간 대각선화, 샘플링 기반 양자 대각선화(SQD) 등 VQE를 보완하고 강화하기 위해 등장한 고유값 관련 접근 방식이 많이 있습니다. VQE를 이해하는 것은 최근 등장한 다양한 클래식-퀀텀 하이브리드 알고리즘을 이해하는 데 중요한 첫 단계입니다.
이 모듈에서는 VQE 및 QAOA의 기본 개념과 구현에 대해 설명합니다. 추가 튜토리얼에서는 이러한 알고리즘을 확장하기 위한 고급 주제와 기술을 살펴볼 것입니다.
이 노트북을 실행하려면 사용자 환경에 다음 라이브러리가 필요합니다. 아직 설치하지 않았다면 다음 셀의 댓글을 삭제하고 실행하여 설치할 수 있습니다.
# % pip install 'qiskit[visualization]' qiskit-ibm-runtime2. 단순 해밀토니안의 최소 고유값 계산
먼저 아주 간단한 사례에 VQE를 적용하여 어떻게 작동하는지 살펴보겠습니다. 폴리 행렬의 최소 고유값을 VQE로 계산해 보겠습니다. 몇 가지 일반 패키지를 가져오는 것부터 시작하겠습니다.
import numpy as np
from qiskit.circuit import ParameterVector, QuantumCircuit
from qiskit.primitives import StatevectorEstimator, StatevectorSampler
from qiskit.quantum_info import SparsePauliOp
from scipy.optimize import minimize
이제 관심 연산자를 정의하고 이를 행렬 형식으로 볼 수 있습니다.
op = SparsePauliOp("Z")
op.to_matrix()
Output:
array([[ 1.+0.j,  0.+0.j],
       [ 0.+0.j, -1.+0.j]])
고유값은 고전적으로 쉽게 구할 수 있으므로 작업을 확인할 수 있습니다. 이는 유틸리티로 확장함에 따라 어려워질 수 있습니다. 여기서는 numpy를 사용합니다.
# compute eigenvalues with numpy
result = np.linalg.eigh(op.to_matrix())
print("Eigenvalues:", result.eigenvalues)
Output:
Eigenvalues: [-1. 1.]
가변 양자 알고리즘을 사용하여 고유값을 구하기 위해 가변 파라미터를 취하는 게이트로 회로를 구성합니다:
# define a variational form
param = ParameterVector("a", 3)
qc = QuantumCircuit(1, 1)
qc.u(param[0], param[1], param[2], 0)
qc_estimator = qc.copy()
qc.measure(0, 0)
qc.draw("mpl")
Output:

연산자의 기대값(예: )을 추정하려면 추정기를 사용해야 합니다. 시스템 상태를 확인하려면 샘플러를 사용합니다.
sampler = StatevectorSampler()
estimator = StatevectorEstimator()
샘플러를 사용하여 임의의 매개변수 값 [1, 2, 3] 으로 비트 문자열 0과 1의 개수를 계산할 수 있습니다.
# compute counts of bitstrings with random parameter values by Sampler
result = sampler.run([(qc, [1, 2, 3])]).result()
counts = result[0].data.c.get_counts()
counts
Output:
{'0': 783, '1': 241}
우리는 Z의 기대값을 확률 으로 으로 계산할 수 있다는 것을 알고 있습니다.
# compute the expectation value of Z based on the counts
(counts.get("0", 0) - counts.get("1", 0)) / sum(counts.values())
Output:
0.529296875
이 회로는 작동했지만 선택한 매개변수 값이 매우 낮은 에너지(또는 낮은 고유값) 상태와 일치하지 않았습니다. 얻은 고유값은 최소값보다 상당히 높습니다. 추정기를 사용할 때도 결과는 비슷합니다.
추정기는 측정 없이 양자 회로를 사용합니다.
result = estimator.run([(qc_estimator, op, [1, 2, 3])]).result()
result[0].data.evs
Output:
array(0.54030231)
매개변수를 검색하여 가장 낮은 고유값을 산출하는 매개변수를 찾아야 합니다. 변형 형식의 매개변수 값을 수신하고 기대값을 반환하는 함수를 만들어 .
# define a cost function to look for the minimum eigenvalue of Z
def cost(x):
    result = sampler.run([(qc, x)]).result()
    counts = result[0].data.c.get_counts()
    expval = (counts.get("0", 0) - counts.get("1", 0)) / sum(counts.values())
    # the following line shows the trajectory of the optimization
    print(expval, counts)
    return expval
SciPy's minimize 함수를 적용하여 Z의 최소 고유값을 구해 보겠습니다.
# minimize the cost function with scipy's minimize
min_result = minimize(cost, [0, 0, 0], method="COBYLA", tol=1e-8)
min_result
Output:
1.0 {'0': 1024}
0.494140625 {'0': 765, '1': 259}
0.466796875 {'0': 751, '1': 273}
0.564453125 {'0': 801, '1': 223}
-0.4296875 {'1': 732, '0': 292}
-0.984375 {'1': 1016, '0': 8}
-0.8984375 {'1': 972, '0': 52}
-0.990234375 {'1': 1019, '0': 5}
-0.892578125 {'1': 969, '0': 55}
-0.986328125 {'1': 1017, '0': 7}
-0.861328125 {'1': 953, '0': 71}
-1.0 {'1': 1024}
-0.982421875 {'1': 1015, '0': 9}
-0.99609375 {'1': 1022, '0': 2}
-0.986328125 {'1': 1017, '0': 7}
-1.0 {'1': 1024}
-0.990234375 {'1': 1019, '0': 5}
-0.998046875 {'1': 1023, '0': 1}
-0.99609375 {'1': 1022, '0': 2}
-1.0 {'1': 1024}
-1.0 {'1': 1024}
-1.0 {'1': 1024}
-1.0 {'1': 1024}
-0.998046875 {'1': 1023, '0': 1}
-1.0 {'1': 1024}
-1.0 {'1': 1024}
-0.998046875 {'1': 1023, '0': 1}
-0.998046875 {'1': 1023, '0': 1}
-0.998046875 {'1': 1023, '0': 1}
-1.0 {'1': 1024}
-0.99609375 {'1': 1022, '0': 2}
-1.0 {'1': 1024}
-0.99609375 {'1': 1022, '0': 2}
-0.998046875 {'1': 1023, '0': 1}
-0.998046875 {'1': 1023, '0': 1}
-0.99609375 {'1': 1022, '0': 2}
-0.998046875 {'1': 1023, '0': 1}
-1.0 {'1': 1024}
-0.998046875 {'1': 1023, '0': 1}
-0.998046875 {'1': 1023, '0': 1}
-0.99609375 {'1': 1022, '0': 2}
-1.0 {'1': 1024}
-0.998046875 {'1': 1023, '0': 1}
-1.0 {'1': 1024}
-0.998046875 {'1': 1023, '0': 1}
-0.998046875 {'1': 1023, '0': 1}
-1.0 {'1': 1024}
-0.998046875 {'1': 1023, '0': 1}
-0.998046875 {'1': 1023, '0': 1}
-1.0 {'1': 1024}
-1.0 {'1': 1024}
-1.0 {'1': 1024}
-1.0 {'1': 1024}
-1.0 {'1': 1024}
-1.0 {'1': 1024}
-0.998046875 {'1': 1023, '0': 1}
-0.994140625 {'1': 1021, '0': 3}
-1.0 {'1': 1024}
-1.0 {'1': 1024}
-1.0 {'1': 1024}
-1.0 {'1': 1024}
-1.0 {'1': 1024}
-1.0 {'1': 1024}
 message: Optimization terminated successfully.
 success: True
  status: 1
     fun: -1.0
       x: [ 3.182e+00  1.338e+00  1.664e-01]
    nfev: 63
   maxcv: 0.0
# check counts of bitstrings with the optimal parameters
result = sampler.run([(qc, min_result.x)]).result()
result[0].data.c.get_counts()
Output:
{'0': 1, '1': 1023}
2.1 운동
VQE를 사용하여 의 최소 고유값을 계산합니다.
z2 = SparsePauliOp("ZZ")
print(z2)
print(z2.to_matrix())
Output:
SparsePauliOp(['ZZ'],
              coeffs=[1.+0.j])
[[ 1.+0.j  0.+0.j  0.+0.j  0.+0.j]
 [ 0.+0.j -1.+0.j  0.+0.j  0.+0.j]
 [ 0.+0.j  0.+0.j -1.+0.j  0.+0.j]
 [ 0.+0.j  0.+0.j  0.+0.j  1.+0.j]]
# compute eigenvalues with numpy# define a variational form
# qc = ...# compute counts of bitstrings with a random parameter values by Sampler
# result = sampler.run(...)
# result# compute the expectation value of ZZ based on the counts# verify the expectation value of ZZ with Estimator# define a cost function to look for the minimum eigenvalue of ZZ
# def cost(x):
# expval = ...
# return expval# minimize the cost function with scipy's minimize
# min_result = minimize(cost, [...], method="COBYLA", tol=1e-8)
# min_result# check counts of bitstrings with the optimal parameter values
# result = sampler.run(qc, min_result.x).result()
# result연습 문제의 해답
관심 연산자를 정의하고 이를 매트릭스 형식으로 확인합니다.
z2 = SparsePauliOp("ZZ")
print(z2)
print(z2.to_matrix())
Output:
SparsePauliOp(['ZZ'],
              coeffs=[1.+0.j])
[[ 1.+0.j  0.+0.j  0.+0.j  0.+0.j]
 [ 0.+0.j -1.+0.j  0.+0.j  0.+0.j]
 [ 0.+0.j  0.+0.j -1.+0.j  0.+0.j]
 [ 0.+0.j  0.+0.j  0.+0.j  1.+0.j]]
가변 양자 알고리즘을 사용하여 고유값을 구하기 위해 가변 파라미터를 취하는 게이트로 회로를 구성합니다:
# define a variational form
param = ParameterVector("a", 6)
qc = QuantumCircuit(2, 2)
qc.u(param[0], param[1], param[2], 0)
qc.u(param[3], param[4], param[5], 1)
qc_estimator = qc.copy()
qc.measure([0, 1], [0, 1])
qc.draw("mpl")
Output:

연산자(예: )의 기대값을 추정하려면 추정기를 사용합니다. 시스템 상태를 확인하려면 샘플러를 사용합니다.
sampler = StatevectorSampler()
estimator = StatevectorEstimator()
# compute counts of bitstrings with random parameter values by Sampler
result = sampler.run([(qc, [1, 2, 3, 4, 5, 6])]).result()
counts = result[0].data.c.get_counts()
countsOutput:
{'10': 661, '11': 203, '01': 47, '00': 113}
# compute the expectation value of ZZ based on the counts
(
    counts.get("00", 0)
    - counts.get("01", 0)
    - counts.get("10", 0)
    + counts.get("11", 0)
) / sum(counts.values())
Output:
-0.3828125
이 회로는 작동했지만 선택한 매개변수 값이 매우 낮은 에너지(또는 낮은 고유값) 상태와 일치하지 않았습니다. 얻은 고유값은 최소값보다 상당히 높습니다. 추정기를 사용할 때도 결과는 비슷합니다.
# verify the expectation value of ZZ with Estimator
result = estimator.run([(qc_estimator, z2, [1, 2, 3, 4, 5, 6])]).result()
result[0].data.evs
Output:
array(-0.35316516)
매개변수를 검색하여 가장 낮은 고유값을 산출하는 매개변수를 찾아야 합니다.
# define a cost function to look for the minimum eigenvalue of ZZ
def cost(x):
    result = sampler.run([(qc, x)]).result()
    counts = result[0].data.c.get_counts()
    expval = (
        counts.get("00", 0)
        - counts.get("01", 0)
        - counts.get("10", 0)
        + counts.get("11", 0)
    ) / sum(counts.values())
    print(expval, counts)
    return expval
# minimize the cost function with scipy's minimize
min_result = minimize(cost, [0, 0, 0, 0, 0, 0], method="COBYLA", tol=1e-8)
min_resultOutput:
1.0 {'00': 1024}
0.578125 {'00': 808, '01': 216}
0.5234375 {'00': 780, '01': 244}
0.548828125 {'00': 793, '01': 231}
0.3515625 {'00': 637, '10': 164, '11': 55, '01': 168}
0.3359375 {'00': 638, '11': 46, '10': 174, '01': 166}
0.283203125 {'00': 602, '10': 181, '01': 186, '11': 55}
-0.087890625 {'01': 414, '00': 184, '10': 143, '11': 283}
0.236328125 {'10': 27, '11': 623, '01': 364, '00': 10}
-0.0625 {'11': 261, '01': 403, '00': 219, '10': 141}
0.248046875 {'01': 366, '11': 628, '00': 11, '10': 19}
-0.0625 {'10': 145, '11': 254, '01': 399, '00': 226}
0.228515625 {'01': 373, '11': 609, '00': 20, '10': 22}
0.0546875 {'11': 376, '10': 273, '01': 211, '00': 164}
-0.447265625 {'01': 731, '10': 10, '11': 267, '00': 16}
-0.71484375 {'01': 871, '11': 99, '00': 47, '10': 7}
-0.46484375 {'01': 741, '00': 253, '10': 9, '11': 21}
-0.87890625 {'01': 962, '00': 39, '11': 23}
-0.640625 {'00': 176, '01': 837, '11': 8, '10': 3}
-0.88671875 {'01': 966, '00': 41, '11': 17}
-0.994140625 {'01': 1021, '11': 3}
-0.91796875 {'01': 982, '11': 35, '00': 7}
-0.994140625 {'01': 1021, '11': 2, '00': 1}
-0.939453125 {'01': 993, '00': 31}
-0.990234375 {'01': 1019, '11': 5}
-0.90234375 {'01': 974, '00': 21, '11': 29}
-0.98046875 {'01': 1014, '11': 10}
-0.994140625 {'01': 1021, '00': 3}
-0.990234375 {'01': 1019, '11': 4, '00': 1}
-0.98828125 {'01': 1018, '11': 6}
-0.990234375 {'01': 1019, '11': 4, '00': 1}
-0.994140625 {'01': 1021, '11': 2, '00': 1}
-0.99609375 {'01': 1022, '11': 2}
-0.998046875 {'01': 1023, '00': 1}
-0.99609375 {'01': 1022, '00': 2}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-0.998046875 {'01': 1023, '11': 1}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-0.998046875 {'01': 1023, '00': 1}
-0.998046875 {'01': 1023, '11': 1}
-0.998046875 {'01': 1023, '00': 1}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-0.998046875 {'01': 1023, '11': 1}
-0.998046875 {'01': 1023, '11': 1}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-0.998046875 {'01': 1023, '11': 1}
-0.998046875 {'01': 1023, '11': 1}
-0.998046875 {'01': 1023, '00': 1}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-0.998046875 {'01': 1023, '00': 1}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-0.998046875 {'01': 1023, '11': 1}
-0.998046875 {'01': 1023, '11': 1}
-1.0 {'01': 1024}
-0.998046875 {'01': 1023, '11': 1}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-0.998046875 {'01': 1023, '11': 1}
-0.998046875 {'01': 1023, '11': 1}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-0.998046875 {'01': 1023, '11': 1}
-0.998046875 {'01': 1023, '11': 1}
-0.998046875 {'01': 1023, '00': 1}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-0.998046875 {'01': 1023, '11': 1}
-1.0 {'01': 1024}
-0.99609375 {'01': 1022, '00': 1, '11': 1}
-0.998046875 {'01': 1023, '11': 1}
-0.998046875 {'01': 1023, '00': 1}
-0.998046875 {'01': 1023, '11': 1}
-1.0 {'01': 1024}
-0.99609375 {'01': 1022, '11': 1, '00': 1}
-1.0 {'01': 1024}
-0.998046875 {'01': 1023, '00': 1}
-0.994140625 {'01': 1021, '00': 3}
-0.998046875 {'01': 1023, '00': 1}
-0.99609375 {'01': 1022, '11': 2}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-0.998046875 {'01': 1023, '11': 1}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-0.998046875 {'01': 1023, '11': 1}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-0.998046875 {'01': 1023, '11': 1}
-0.998046875 {'01': 1023, '11': 1}
-1.0 {'01': 1024}
-0.998046875 {'01': 1023, '00': 1}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-1.0 {'01': 1024}
-0.998046875 {'01': 1023, '11': 1}
-0.998046875 {'01': 1023, '11': 1}
-0.998046875 {'01': 1023, '11': 1}
-0.99609375 {'01': 1022, '11': 2}
-1.0 {'01': 1024}
-0.998046875 {'01': 1023, '11': 1}
 message: Optimization terminated successfully.
 success: True
  status: 1
     fun: -0.998046875
       x: [ 3.167e+00  6.940e-01  1.033e+00 -2.894e-02  8.933e-01
            1.885e+00]
    nfev: 128
   maxcv: 0.0
 message: Optimization terminated successfully.
 success: True
  status: 1
     fun: -0.99609375
       x: [ 3.098e+00 -5.402e-01  1.091e+00 -1.004e-02  3.615e-01
            6.913e-01]
    nfev: 115
   maxcv: 0.0
Numpy에서 주어진 최소값에 매우 근접한 고유값을 얻었습니다.
# check counts of bitstrings with the optimal parameters
result = sampler.run([(qc, min_result.x)]).result()
result[0].data.c.get_counts()
Output:
{'01': 1024}
3. Qiskit 패턴을 활용한 양자 최적화
이 튜토리얼에서는 키스킷 패턴과 퀀텀 근사 최적화에 대해 알아보세요. 키스킷 패턴은 양자 컴퓨팅 워크플로우를 구현하기 위한 직관적이고 반복 가능한 단계 집합입니다:
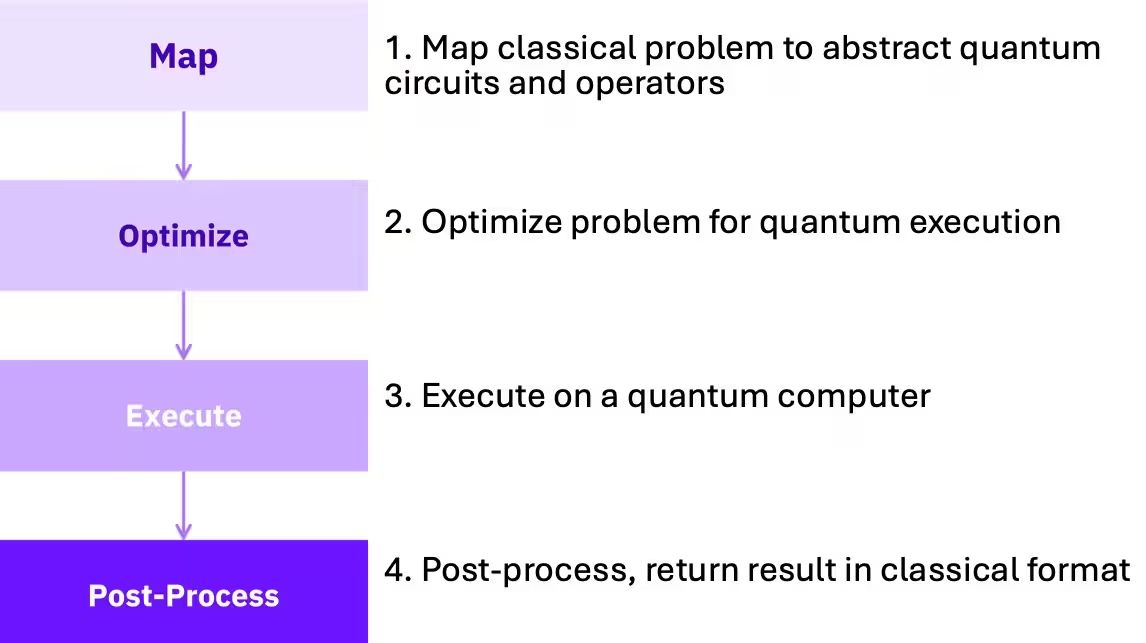
우리는 이러한 패턴을 조합 최적화 분야에 적용하고, 하이브리드(양자-고전) 반복 방법인 양자 근사 최적화 알고리즘(QAOA) 을 사용하여 최대 절단 문제를 해결하는 방법을 보여줄 것이다.
이 QAOA 파트는 퀀텀 근사 최적화 알고리즘 튜토리얼의 '파트 1: 소규모 QAOA'를 기반으로 한다는 점에 유의하세요. 확장하는 방법을 알아보려면 튜토리얼을 참조하세요.
3.1 (소규모) 최적화를 위한 Qiskit 패턴
이 부분에서는 소규모 최대 절단 문제를 예로 들어, 양자 컴퓨터를 사용하여 최적화 문제를 해결하는 데 필요한 단계를 설명하겠습니다.
최대 절단 문제는 해결하기 어려운 최적화 문제(더 구체적으로는 NP-완전 문제)로, 클러스터링, 네트워크 과학, 통계 물리학 등 다양한 분야에서 응용되고 있다. 이 튜토리얼에서는 변으로 연결된 노드들로 구성된 그래프를 다루며, 변을 “자르는” 방식으로 노드들을 두 집합으로 나누되, 잘리는 변의 개수가 최대가 되도록 하는 것을 목표로 합니다.

이 문제를 양자 알고리즘에 적용하기 전에 배경 지식을 설명하자면, 먼저 함수의 최소화 문제를 고려해 보면 최대 절단 문제가 어떻게 고전적 조합 최적화 문제가 되는지 더 잘 이해할 수 있습니다.
여기서 입력은 그래프의 각 노드에 해당하는 구성 요소가 있는 벡터입니다. 그런 다음 이러한 각 구성 요소를 또는 (컷에 포함되거나 포함되지 않음을 나타냄)으로 제한합니다. 이 소규모 예시 사례에서는 노드가 있는 그래프를 사용합니다.
해당 에지 가 컷에 있는지 여부를 나타내는 한 쌍의 노드( ) 함수를 작성할 수 있습니다. 예를 들어 함수는 또는 중 하나가 1(즉, 가장자리가 컷에 있음을 의미)인 경우에만 1이 되고 그렇지 않으면 0이 됩니다. 컷에서 가장자리를 최대화하는 문제는 다음과 같이 공식화할 수 있습니다
양식을 최소화하여 다시 작성할 수 있습니다
이 경우 최소값 은 컷이 통과하는 가장자리 수가 최대인 경우입니다. 보시다시피 아직 양자 컴퓨팅과 관련된 내용은 없습니다. 이 문제를 양자 컴퓨터가 이해할 수 있는 형태로 재구성해야 합니다.
노드로 그래프를 만들어 문제를 초기화합니다.
import matplotlib
import matplotlib.pyplot as plt
import numpy as np
import rustworkx as rx
from rustworkx.visualization import mpl_draw
n = 5
graph = rx.PyGraph()
graph.add_nodes_from(range(1, n + 1))
edge_list = [
(0, 1, 1.0),
(0, 2, 1.0),
(1, 2, 1.0),
(1, 3, 1.0),
(2, 4, 1.0),
(3, 4, 1.0),
]
graph.add_edges_from(edge_list)
pos = rx.spring_layout(graph, seed=2)
mpl_draw(graph, node_size=600, pos=pos, with_labels=True, labels=str)Output:

3.2 1단계. 고전적 입력을 양자 문제에 매핑하다
패턴의 첫 번째 단계는 고전적인 문제(그래프)를 양자 회로와 연산자로 매핑하는 것입니다. 이를 위해 세 가지 주요 단계를 수행해야 합니다:
- 일련의 수학적 재구성을 활용하여 이 문제를 이차 제약 없는 이항 최적화(QUBO) 문제 표기법을 사용하여 표현합니다.
- 최적화 문제를 기저 상태가 비용 함수를 최소화하는 해에 해당하는 해밀턴으로 다시 작성합니다.
- 양자 어닐링과 유사한 과정을 통해 이 해밀턴의 기저 상태를 준비할 양자 회로를 생성합니다.
참고: QAOA 방법론에서는 궁극적으로 하이브리드 알고리즘의 비용 함수를 나타내는 연산자 (해밀턴) 와 문제에 대한 후보 솔루션을 가진 양자 상태를 나타내는 매개변수화된 회로 (Ansatz )를 갖고자 합니다. 이러한 후보 상태에서 샘플링한 다음 비용 함수를 사용하여 평가할 수 있습니다.
그래프 → 최적화 문제
매핑의 첫 번째 단계는 표기법 변경이며, 다음은 이 문제를 QUBO 표기법으로 표현한 것입니다:
여기서 은 실수 행렬, 은 그래프의 노드 수, 은 위에서 소개한 이진 변수의 벡터, 은 벡터 의 전치를 나타냅니다.
Problem name: maxcut

Minimize
  2*x_1*x_2 + 2*x_1*x_3 + 2*x_2*x_3 + 2*x_2*x_4 + 2*x_3*x_5 + 2*x_4*x_5 - 2*x_1
  - 3*x_2 - 3*x_3 - 2*x_4 - 2*x_5

Subject to
  No constraints

  Binary variables (5)
    x_1 x_2 x_3 x_4 x_5
최적화 문제 → 해밀턴 문제
그런 다음 QUBO 문제를 해밀턴 행렬(여기서는 시스템의 에너지를 나타내는 행렬)로 재구성할 수 있습니다:
QAOA 문제에서 해밀턴으로 재구성하는 단계
이러한 방식으로 QAOA 문제를 다시 작성하는 방법을 보여주기 위해 먼저 다음을 통해 이진 변수 를 새 변수 집합 으로 대체합니다
여기서 가 이라면 는 여야 한다는 것을 알 수 있습니다. 최적화 문제( )에서 를 로 치환하면 동등한 공식을 얻을 수 있습니다.
이제 , 전치사를 제거하고 상수 항을 정의하면 동일한 최적화 문제에 대한 두 가지 동등한 공식에 도달합니다.
여기서 은 에 의존합니다. 을 얻기 위해 최적화에서 역할을 하지 않는 1/4 계수와 의 상수 오프셋을 제거했습니다.
이제 문제의 양자 공식을 얻으려면 변수를 다음과 같은 형식의 행렬과 같은 Pauli 행렬로 승격합니다
위의 최적화 문제에서 이러한 행렬을 대입하면 다음과 같은 해밀턴 행렬을 구할 수 있습니다
또한 행렬은 양자 컴퓨터의 계산 공간, 즉 크기의 힐버트 공간에 포함된다는 점을 기억하세요. 따라서 와 같은 용어는 힐버트 공간에 포함된 텐서 곱 으로 이해해야 합니다. 예를 들어, 5개의 의사 결정 변수가 있는 문제에서 이라는 용어는 을 의미하며 은 아이덴티티 행렬입니다.
이 해밀턴을 비용 함수 해밀턴 이라고 하며, 그 기저 상태는 비용 함수를 최소화합니다 의 해와 일치하는 속성을 가지고 있습니다. 따라서 최적화 문제를 풀려면 이제 양자 컴퓨터에서 의 기저 상태(또는 이 상태와 겹치는 부분이 많은 상태)를 준비해야 합니다. 그런 다음 이 상태에서 샘플링하면 높은 확률로 에 대한 솔루션을 얻을 수 있습니다.
def build_max_cut_operator(graph: rx.PyGraph) -> tuple[SparsePauliOp, float]:
    sp_list = []
    constant = 0
    for s, t in graph.edge_list():
        w = graph.get_edge_data(s, t)
        sp_list.append(("ZZ", [s, t], w / 2))
        constant -= 1 / 2
    return SparsePauliOp.from_sparse_list(
        sp_list, num_qubits=graph.num_nodes()
), constantcost_hamiltonian, constant = build_max_cut_operator(graph)
print("Cost Function Hamiltonian:", cost_hamiltonian)
print("Constant:", constant)Output:
Cost Function Hamiltonian: SparsePauliOp(['IIIZZ', 'IIZIZ', 'IIZZI', 'IZIZI', 'ZIZII', 'ZZIII'],
              coeffs=[0.5+0.j, 0.5+0.j, 0.5+0.j, 0.5+0.j, 0.5+0.j, 0.5+0.j])
Constant: -3.0
해밀토니안 → 양자 회로
해밀턴의 에는 문제에 대한 양자 정의가 포함되어 있습니다. 이제 양자 컴퓨터에서 좋은 솔루션을 샘플링하는 데 도움이 되는 양자 회로를 만들 수 있습니다. QAOA는 양자 어닐링에서 영감을 받아 양자 회로에 연산자 층을 번갈아 가며 적용합니다.
일반적인 아이디어는 알려진 시스템의 그라운드 상태(위의 )에서 시작한 다음 관심 있는 비용 연산자의 그라운드 상태로 시스템을 조정하는 것입니다. 이는 각도 및 와 함께 연산자 및 를 적용하여 수행됩니다.
생성하는 양자 회로는 및 으로 파라미터화되어 있으므로 및 의 다른 값을 시도하고 결과 상태에서 샘플을 얻을 수 있습니다.

이 경우 와 두 개의 매개 변수가 포함된 1개의 QAOA 계층을 사용하는 예제를 시도해 보겠습니다.
from qiskit.circuit.library import QAOAAnsatzcircuit = QAOAAnsatz(cost_operator=cost_hamiltonian, reps=1)
circuit.measure_all()
circuit.draw("mpl")Output:

circuit.decompose(reps=3).draw("mpl", fold=-1)Output:

circuit.parametersOutput:
ParameterView([ParameterVectorElement(β[0]), ParameterVectorElement(γ[0])])
3.3 2단계. 양자 하드웨어 실행을 위한 회로 최적화
위의 회로에는 양자 알고리즘을 생각하는 데는 유용하지만 하드웨어에서 실행할 수 없는 일련의 추상화가 포함되어 있습니다. QPU에서 실행하려면 패턴의 트랜실레이션 또는 회로 최적화 단계를 구성하는 일련의 작업을 거쳐야 합니다.
키스킷 라이브러리는 다양한 회로 변환을 지원하는 일련의 트랜스필레이션 패스를 제공합니다. 회로가 목적에 맞게 최적화되었는지 확인해야 합니다.
번역에는 다음과 같은 여러 단계가 포함될 수 있습니다:
- 회로의 큐비트(예: 결정 변수)를 디바이스의 물리적 큐비트에 초기 매핑합니다.
- 양자 회로의 명령어를 백엔드가 이해할 수 있는 하드웨어 네이티브 명령어로 언롤링합니다.
- 회로에서 서로 인접한 물리적 큐비트와 상호 작용하는 모든 큐비트의 라우팅.
- 동적 디커플링으로 노이즈를 억제하기 위해 단일 큐비트 게이트를 추가하여 오류를 억제합니다.
번역에 대한 자세한 내용은 문서에서 확인할 수 있습니다.
다음 코드는 추상 회로를 클라우드를 통해 액세스 가능한 장치 중 하나에서 실행할 수 있는 형식으로 변환하고 최적화하는 것으로, Qiskit IBM® 런타임 서비스를 사용합니다.
프로그램을 실제 양자 컴퓨터로 전송하기 전에 “로컬 테스트 모드”를 통해 로컬에서 테스트할 수 있다는 점에 유의하십시오. 로컬 테스트 모드에 대한 자세한 내용은 설명서를 참조하십시오.
from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# Use a quantum device
service = QiskitRuntimeService()
backend = service.least_busy(min_num_qubits=127)
# backend = service.backend("ibm_kingston")

# You can test your programs locally with a fake backend (local testing mode)
# backend = FakeBrisbane()

print(backend)

# Create pass manager for transpilation
pm = generate_preset_pass_manager(optimization_level=3, backend=backend)

candidate_circuit = pm.run(circuit)
candidate_circuit.draw("mpl", fold=False, idle_wires=False)
Output:
service = QiskitRuntimeService(channel="ibm_quantum_platform")
<IBMBackend('ibm_strasbourg')>

3.4 3단계. IBM Quantum 기본 기능을 사용하여 실행
QAOA 워크플로에서는 일련의 회로 평가를 실행하고 고전적인 최적화 도구를 사용하여 최적의 및 매개 변수를 찾는 반복 최적화 루프에서 최적의 QAOA 매개 변수를 찾습니다. 이 실행 루프는 다음 단계를 통해 실행됩니다:
- 초기 매개변수 정의
- 최적화 루프와 회로 샘플링에 사용되는 프리미티브가 포함된
Session를 새로 인스턴스화합니다 - 최적의 파라미터 집합을 찾으면 회로를 마지막으로 한 번 더 실행하여 후처리 단계에서 사용할 최종 분포를 얻습니다.
초기 매개변수를 가진 회로 정의
임의로 선택한 매개변수부터 시작합니다.
initial_gamma = np.pi
initial_beta = np.pi / 2
init_params = [initial_gamma, initial_beta]
백엔드와 실행 기본 단위를 정의하십시오
IBM Quantum 기본 요소를 사용하여 IBM® 백엔드와 연동하십시오. 두 가지 기본 구성 요소는 ‘샘플러(Sampler)’와 ‘추정기(Estimator)’이며, 어떤 기본 구성 요소를 선택할지는 양자 컴퓨터에서 어떤 유형의 측정을 수행하고자 하는지에 따라 달라집니다. 를 최소화하기 위해서는, 비용 함수의 측정값이 단순히 의 기대값이므로 Estimator를 사용하십시오.
다음을 실행하십시오.
프리미티브는 양자 디바이스에서 워크로드를 예약할 수 있는 다양한 실행 모드를 제공하며, QAOA 워크플로는 세션에서 반복적으로 실행됩니다.

샘플러 기반 비용 함수를 SciPy 최소화 루틴에 연결하여 최적의 매개 변수를 찾을 수 있습니다.
def cost_func_estimator(params, ansatz, hamiltonian, estimator):
    # transform the observable defined on virtual qubits to
    # an observable defined on all physical qubits
    isa_hamiltonian = hamiltonian.apply_layout(ansatz.layout)

    pub = (ansatz, isa_hamiltonian, params)
    job = estimator.run([pub])

    results = job.result()[0]
    cost = results.data.evs

    objective_func_vals.append(cost)

    return cost
from qiskit_ibm_runtime import Session, EstimatorV2
from scipy.optimize import minimize
objective_func_vals = [] # Global variable
with Session(backend=backend) as session:
# If using qiskit-ibm-runtime<0.24.0, change `mode=` to `session=`
estimator = EstimatorV2(mode=session)
estimator.options.default_shots = 1000
# Set simple error suppression/mitigation options
estimator.options.dynamical_decoupling.enable = True
estimator.options.dynamical_decoupling.sequence_type = "XY4"
estimator.options.twirling.enable_gates = True
estimator.options.twirling.num_randomizations = "auto"
result = minimize(
cost_func_estimator,
init_params,
args=(candidate_circuit, cost_hamiltonian, estimator),
method="COBYLA",
tol=1e-2,
)
print(result)Output:
 message: Optimization terminated successfully.
 success: True
  status: 1
     fun: -0.6557925874481715
       x: [ 2.873e+00  9.414e-01]
    nfev: 21
   maxcv: 0.0
옵티마이저는 비용을 절감하고 회로의 더 나은 파라미터를 찾을 수 있었습니다.
plt.figure(figsize=(12, 6))
plt.plot(objective_func_vals)
plt.xlabel("Iteration")
plt.ylabel("Cost")
plt.show()
Output:

회로에 대한 최적의 파라미터를 찾으면 이러한 파라미터를 할당하고 최적화된 파라미터로 얻은 최종 분포를 샘플링할 수 있습니다. 샘플러 프리미티브는 그래프의 최적 절단에 해당하는 비트 문자열 측정값의 확률 분포이므로 여기에 사용해야 합니다.
참고: 이는 컴퓨터에서 양자 상태( )를 준비한 다음 측정하는 것을 의미합니다. 측정은 상태를 단일 계산 기준 상태(예: 010101110000... )로 축소하며, 이는 초기 최적화 문제에 대한 후보 솔루션 (작업에 따라 또는 )에 해당합니다.
optimized_circuit = candidate_circuit.assign_parameters(result.x)
optimized_circuit.draw("mpl", fold=False, idle_wires=False)
Output:

from qiskit_ibm_runtime import SamplerV2

# If using qiskit-ibm-runtime<0.24.0, change `mode=` to `backend=`
sampler = SamplerV2(mode=backend)

# Set simple error suppression/mitigation options
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = "XY4"
sampler.options.twirling.enable_gates = True
sampler.options.twirling.num_randomizations = "auto"

pub = (optimized_circuit,)
job = sampler.run([pub], shots=int(1e4))
counts_int = job.result()[0].data.meas.get_int_counts()
counts_bin = job.result()[0].data.meas.get_counts()
shots = sum(counts_int.values())
final_distribution_int = {key: val / shots for key, val in counts_int.items()}
final_distribution_bin = {key: val / shots for key, val in counts_bin.items()}
print(final_distribution_int)
Output:
{12: 0.0652, 31: 0.0089, 4: 0.0085, 13: 0.0731, 26: 0.0256, 28: 0.0246, 17: 0.0405, 25: 0.0591, 20: 0.031, 15: 0.0221, 8: 0.017, 21: 0.0371, 14: 0.0461, 16: 0.0229, 19: 0.0723, 23: 0.0199, 22: 0.0478, 18: 0.0708, 24: 0.0165, 6: 0.0525, 7: 0.0155, 5: 0.0245, 3: 0.0231, 29: 0.0121, 30: 0.0062, 10: 0.0363, 1: 0.0097, 9: 0.042, 27: 0.0094, 11: 0.0349, 0: 0.0129, 2: 0.0119}
3.5 4단계. 후처리 후, 결과를 클래식 형식으로 반환
사후 처리 단계에서는 샘플링 출력을 해석하여 원래 문제에 대한 해결책을 반환합니다. 이 경우 최적의 컷을 결정하므로 확률이 가장 높은 비트 문자열에 관심이 있습니다. 문제의 대칭성으로 인해 네 가지 가능한 솔루션이 있으며, 샘플링 프로세스는 그 중 하나를 약간 더 높은 확률로 반환하지만 아래 플롯된 분포에서 네 개의 비트 문자열이 나머지보다 확률이 뚜렷하게 더 높다는 것을 알 수 있습니다.
# auxiliary functions to sample most likely bitstring
def to_bitstring(integer, num_bits):
    result = np.binary_repr(integer, width=num_bits)
    return [int(digit) for digit in result]


keys = list(final_distribution_int.keys())
values = list(final_distribution_int.values())
most_likely = keys[np.argmax(np.abs(values))]
most_likely_bitstring = to_bitstring(most_likely, len(graph))
most_likely_bitstring.reverse()

print("Result bitstring:", most_likely_bitstring)
Output:
Result bitstring: [1, 0, 1, 1, 0]
import matplotlib.pyplot as plt

matplotlib.rcParams.update({"font.size": 10})
final_bits = final_distribution_bin
values = np.abs(list(final_bits.values()))
top_4_values = sorted(values, reverse=True)[:4]
positions = []
for value in top_4_values:
    positions.append(np.where(values == value)[0])
fig = plt.figure(figsize=(11, 6))
ax = fig.add_subplot(1, 1, 1)
plt.xticks(rotation=45)
plt.title("Result Distribution")
plt.xlabel("Bitstrings (reversed)")
plt.ylabel("Probability")
ax.bar(list(final_bits.keys()), list(final_bits.values()), color="tab:grey")
for p in positions:
    ax.get_children()[p[0].item()].set_color("tab:purple")
plt.show()
Output:

최적 절단 시각화
그런 다음 최적의 비트 문자열에서 원본 그래프에서 이 컷을 시각화할 수 있습니다.
colors = ["tab:grey" if i == 0 else "tab:purple" for i in most_likely_bitstring]
mpl_draw(graph, node_size=600, pos=pos, with_labels=True, labels=str, node_color=colors)
Output:

그리고 컷의 값을 계산합니다. 노이즈로 인해 솔루션이 최적이 아닙니다(최적 솔루션의 컷값은 5입니다).
from typing import Sequence


def evaluate_sample(x: Sequence[int], graph: rx.PyGraph) -> float:
    assert len(x) == len(
        list(graph.nodes())
    ), "The length of x must coincide with the number of nodes in the graph."
    return sum(
        x[u] * (1 - x[v]) + x[v] * (1 - x[u]) for u, v in list(graph.edge_list())
    )


cut_value = evaluate_sample(most_likely_bitstring, graph)
print("The value of the cut is:", cut_value)
Output:
The value of the cut is: 5
이것으로 소규모 QAOA 튜토리얼을 마칩니다. "2부: 확장하기!"에서 유틸리티 규모에 맞게 QAOA를 적용하는 방법을 알아보세요 퀀텀 근사 최적화 알고리즘 튜토리얼을 참고하세요.
# Check Qiskit version
import qiskit

qiskit.__version__
Output:
'2.0.2'