Diagonalización cuántica de Krylov de hamiltonianos de red
Tiempo estimado de ejecución: 70 minutos en un procesador Heron o Nighthawk (NOTA: Se trata únicamente de una estimación. (El tiempo de ejecución puede variar.)
Resultados del aprendizaje
- Cómo interpretar la diagonalización cuántica de Krylov (KQD) como el aprendizaje de una función hamiltoniana finita que actúa como filtro espectral.
- Cómo construir las matrices de Hamiltoniano proyectado y de solapamiento mediante mediciones ampliadas de la prueba de intercambio.
- Cómo resolver el problema de valores propios generalizado (GEVP) resultante y obtener una estimación de la energía del estado fundamental para un hamiltoniano de red.
Requisitos previos
- Qiskit primitives
- Estimación de la energía del estado fundamental de la cadena de Heisenberg mediante VQE
- Curso de algoritmos de diagonalización cuántica
En segundo plano
Este tutorial muestra cómo implementar el algoritmo de diagonalización cuántica de Krylov (KQD) en el contexto de los patrones de Qiskit. En primer lugar, aprenderás la teoría en la que se basa el algoritmo y, a continuación, verás una demostración de su ejecución en una QPU.
La estimación de las propiedades a baja energía de los hamiltonianos de muchos cuerpos es una tarea fundamental en la simulación cuántica. Por ejemplo, las energías del estado fundamental y las excitaciones de baja energía están directamente relacionadas con la estabilidad química, el orden magnético, las transiciones de fase cuánticas y la respuesta de los materiales. En un ordenador clásico, la dimensión del espacio de Hilbert crece exponencialmente con el número de orbitales o espines, por lo que la diagonalización directa pronto resulta inviable.
Existen varios enfoques de computación cuántica para abordar este problema. Los métodos variacionales a corto plazo, como el solucionador variacional de valores propios cuánticos (VQE), utilizan circuitos parametrizados relativamente poco profundos, pero requieren un bucle de optimización clásica no lineal con numerosas evaluaciones de circuitos cuánticos. Por otro lado, la estimación de fase cuántica (QPE) ofrece una vía más directa para la estimación de valores propios con garantías rigurosas, pero la QPE estándar requiere circuitos coherentes largos y resulta adecuada principalmente para ordenadores cuánticos tolerantes a fallos. El KQD se sitúa entre estos dos enfoques: utiliza la evolución hamiltoniana en tiempo real, al igual que los algoritmos basados en la estimación de fase, pero sustituye la estimación completa de fase por un problema compacto de valores propios proyectados que puede resolverse de forma clásica.
Consideremos un hamiltoniano de qubits de tipo « » y un estado de referencia . El método KQD construye un subespacio de Krylov a partir de estados evolucionados en tiempo real,
donde es la dimensión de Krylov y es el paso de tiempo. Cualquier estado del subespacio de Krylov se representa entonces como una combinación lineal de estos estados de base,
donde el denominador normaliza el estado.
Mediante álgebra sencilla, podemos ver que la energía correspondiente se expresa como el cociente de Rayleigh,
En este caso, las matrices y ,
definir las matrices de superposición proyectada y hamiltonianas. Sus entradas se estiman mediante mediciones de circuitos cuánticos.
Nuestro objetivo es hallar el coeficiente que dé lugar al mínimo :
Según el teorema de Rayleigh-Ritz, esta minimización equivale a resolver el problema de los valores propios generalizados (GEVP),
Ten en cuenta que la dimensión puede ser lo suficientemente pequeña como para que un ordenador clásico resuelva el GEVP.
Se trata del mismo principio variacional que se utiliza en la diagonalización clásica de subespacios, pero en este caso los estados de base se generan mediante la evolución temporal cuántica. En comparación con el VQE, el KQD suele requerir circuitos más profundos, ya que se basa en la evolución en tiempo real. A cambio, KQD evita la optimización no lineal de parámetros y la ejecución iterativa en hardware cuántico, y mejora sistemáticamente a medida que se amplía el subespacio proyectado. El algoritmo se ha probado a gran escala en hardware cuántico existente [2], y su rendimiento puede analizarse con garantías demostrables [1].
Requisitos
Antes de empezar este tutorial, asegúrate de que tienes instalados los siguientes elementos:
- Qiskit SDK v2.3 o posterior, con soporte para visualización
- Qiskit Runtime v0.22 o posterior (
pip install qiskit-ibm-runtime) - SciPy (
pip install scipy) - Matplotlib (
pip install matplotlib) - Pandas (
pip install pandas)
La ejecución en el hardware requiere qiskit-ibm-runtime y acceso a una cuenta de IBM Quantum®.
Configuración
La celda de configuración importa los módulos necesarios y define funciones auxiliares para el flujo de trabajo:
- construir el hamiltoniano de Heisenberg;
- resolver el GEVP con umbral;
- evaluar el filtro de Krylov entrenado;
- convertir los valores del filtro en pesos espectrales;
- representa gráficamente las distribuciones de energía de referencia y filtrada.
from __future__ import annotations

import warnings

import numpy as np
import pandas as pd
import scipy.linalg as la
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit, transpile
from qiskit.circuit import Parameter
from qiskit.circuit.library import PauliEvolutionGate
from qiskit.primitives import StatevectorEstimator
from qiskit.quantum_info import Operator, SparsePauliOp
from qiskit.synthesis import LieTrotter, SuzukiTrotter
from qiskit.transpiler import PassManager, Layout
from qiskit.transpiler.passes import CommutativeOptimization
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Batch
from qiskit_ibm_runtime.fake_provider import FakeMarrakesh

warnings.filterwarnings("ignore")


def make_heisenberg_hamiltonian(
    num_qubits: int,
    coupling: float = 1.0,
) -> SparsePauliOp:
    """Make a Heisenberg Hamiltonian for a 1D chain of qubits with nearest-neighbor interactions."""
    terms: list[tuple[str, complex]] = []

    def append_term(q0: int, q1: int, pauli: str):
        label = ["I"] * num_qubits
        label[num_qubits - 1 - q0] = pauli[0]
        label[num_qubits - 1 - q1] = pauli[1]
        terms.append(("".join(label), coupling))

    for pauli in ("XX", "YY", "ZZ"):
        for q in range(num_qubits - 1):
            append_term(q, q + 1, pauli)
    return SparsePauliOp.from_list(terms).simplify()


def _basis_state_transition_amplitude_sparse(
    hamiltonian: SparsePauliOp,
    bra_state: int,
    ket_state: int,
) -> complex:
    """Evaluate <bra_state|H|ket_state> for computational-basis states."""
    num_qubits = hamiltonian.num_qubits
    amplitude = 0.0 + 0.0j
    for pauli, coeff in zip(hamiltonian.paulis, hamiltonian.coeffs):
        new_state = ket_state
        phase = 1.0 + 0.0j
        for q in range(num_qubits):
            x = bool(pauli.x[q])
            z = bool(pauli.z[q])
            if not x and not z:
                continue
            bit = (new_state >> q) & 1
            if x and z:
                # Y|0> = i|1>, Y|1> = -i|0>
                phase *= 1j if bit == 0 else -1j
                new_state ^= 1 << q
            elif x:
                new_state ^= 1 << q
            else:
                # Z|0> = |0>, Z|1> = -|1>
                if bit:
                    phase *= -1
        if new_state == bra_state:
            amplitude += coeff * phase
    return amplitude


def basis_state_expectation_sparse(
    hamiltonian: SparsePauliOp,
    bitstring: str,
) -> complex:
    """Evaluate <bitstring|H|bitstring>."""
    state = int(bitstring, 2)
    return _basis_state_transition_amplitude_sparse(
        hamiltonian,
        bra_state=state,
        ket_state=state,
    )


def diagonalize_single_1_subspace(
    hamiltonian: SparsePauliOp,
) -> np.ndarray:
    """Diagonalize the Hamiltonian projected onto the single-excitation subspace."""
    num_qubits = hamiltonian.num_qubits

    # Integer basis states |...010...>, with the excitation at qubit k.
    basis = [1 << k for k in range(num_qubits)]

    h_single = np.empty((num_qubits, num_qubits), dtype=complex)

    for row, bra_state in enumerate(basis):
        for col, ket_state in enumerate(basis):
            h_single[row, col] = _basis_state_transition_amplitude_sparse(
                hamiltonian,
                bra_state=bra_state,
                ket_state=ket_state,
            )
    # Remove floating-point-level asymmetry.
    h_single = 0.5 * (h_single + h_single.conj().T)
    evals, _ = np.linalg.eigh(h_single)
    return np.real(evals)


def simple_transpilation(circuit: QuantumCircuit) -> QuantumCircuit:
    """Transpilation to simplify the circuit"""
    pm = PassManager(
        [
            CommutativeOptimization(),
        ]
    )
    circuit = transpile(circuit, optimization_level=3)
    circuit = pm.run(circuit)
    return circuit


def summarize_circuit(circuit: QuantumCircuit) -> dict[str, int | str]:
    """Summarize the circuit with depth, size, and 2-qubit gate information."""
    two_qubit_total = sum(
        inst.operation.num_qubits == 2 for inst in circuit.data
    )
    two_qubit_depth = circuit.depth(lambda x: x[0].num_qubits == 2)
    return {
        "depth": circuit.depth(),
        "size": circuit.size(),
        "2q gates": two_qubit_total,
        "2q depth": two_qubit_depth,
    }


def solve_thresholded_gevp(
    h_matrix: np.ndarray,
    s_matrix: np.ndarray,
    threshold: float = 1e-10,
) -> tuple[float, np.ndarray, int]:
    """Solve H c = E S c using canonical orthogonalization of S."""
    s_vals, s_vecs = la.eigh(s_matrix)

    valid = s_vals > threshold
    if not np.any(valid):
        raise ValueError(
            "All overlap eigenvalues were removed by thresholding."
        )

    keep = valid

    orthogonalizer = s_vecs[:, keep] @ np.diag(1.0 / np.sqrt(s_vals[keep]))
    h_orth = orthogonalizer.conj().T @ h_matrix @ orthogonalizer
    h_orth = 0.5 * (h_orth + h_orth.conj().T)

    eigvals, eigvecs = la.eigh(h_orth)

    coeffs = orthogonalizer @ eigvecs[:, 0]
    normalization = np.sqrt(np.real(coeffs.conj().T @ s_matrix @ coeffs))
    coeffs /= normalization

    return float(np.real(eigvals[0])), coeffs, int(np.sum(keep))
En la primera parte de este tutorial, mostramos el método KQD utilizando un simulador de vectores de estado local. Posteriormente, utilizamos un backend cuántico real para abordar un problema a escala industrial.
También definimos un backend ficticio para mostrar la transpilación específica del backend y examinar el circuito resultante.
try:
    service = QiskitRuntimeService()
except Exception:
    QiskitRuntimeService.save_account(
        token="<api_token>", instance="<instance>", overwrite=True
    )
    service = QiskitRuntimeService()

backend = FakeMarrakesh()
Ejemplo de simulador a pequeña escala
Paso 1: Asignar entradas clásicas a un problema cuántico
Hamiltoniano y estado de referencia
En este ejemplo se utiliza una cadena de Heisenberg de 12 qubits con límites abiertos ( ),
con un estado de producto de excitación única
como estado de referencia. Dado que el hamiltoniano de Heisenberg definido anteriormente conserva el número total de excitaciones, el estado de referencia permanece en el subespacio de una sola excitación, cuya dimensión crece únicamente de forma lineal con el número de qubits. Por lo tanto, podemos calcular de forma eficiente la energía exacta del estado fundamental, diagonalizando el hamiltoniano restringido a ese subespacio, y utilizarla exclusivamente como referencia diagnóstica para la estimación de KQD. El propio flujo de trabajo KQD estima los elementos de la matriz proyectada mediante el uso de la técnica « Qiskit primitives » y resuelve el problema proyectado resultante de forma clásica.
# Problem definition for the simulator example
num_qubits = 12
hamiltonian = make_heisenberg_hamiltonian(num_qubits=num_qubits, coupling=1.0)
ref_bitstring = "000001000000"
ref_energy = basis_state_expectation_sparse(hamiltonian, ref_bitstring)

print("Hamiltonian:")
print(hamiltonian)
print(f"Reference state: |{ref_bitstring}>")
print("Reference energy: ", ref_energy)
Output:
Hamiltonian:
SparsePauliOp(['IIIIIIIIIIXX', 'IIIIIIIIIXXI', 'IIIIIIIIXXII', 'IIIIIIIXXIII', 'IIIIIIXXIIII', 'IIIIIXXIIIII', 'IIIIXXIIIIII', 'IIIXXIIIIIII', 'IIXXIIIIIIII', 'IXXIIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIIYYI', 'IIIIIIIIYYII', 'IIIIIIIYYIII', 'IIIIIIYYIIII', 'IIIIIYYIIIII', 'IIIIYYIIIIII', 'IIIYYIIIIIII', 'IIYYIIIIIIII', 'IYYIIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIIZZI', 'IIIIIIIIZZII', 'IIIIIIIZZIII', 'IIIIIIZZIIII', 'IIIIIZZIIIII', 'IIIIZZIIIIII', 'IIIZZIIIIIII', 'IIZZIIIIIIII', 'IZZIIIIIIIII', 'ZZIIIIIIIIII'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])
Reference state: |000001000000>
Reference energy:  (7+0j)
Configurar los parámetros del algoritmo
Basándonos en los límites superiores de la norma hamiltoniana, la ref. [1] sugiere de forma heurística que el paso de tiempo viene dado por . Dado que la norma espectral es difícil de calcular, utilizamos en su lugar su límite superior:
Hemos fijado la dimensión de Krylov en y el número de pasos de Trotter por paso de tiempo en : un espacio de Krylov lo suficientemente amplio como para resolver el espectro de baja energía, al tiempo que se mantiene asequible el circuito más profundo ( ), y suficientes pasos de Trotter para mantener pequeño el error de discretización en ese circuito más profundo.
dt = np.pi / (3 * (num_qubits - 1))
print("dt in Krylov basis:  ", dt)

krylov_dim = 10
num_trotter_steps = 5
Output:
dt in Krylov basis: 0.09519977738150888
Montar un circuito
Aquí construimos los circuitos para estimar los elementos de la matriz y . Dado que todas las potencias de conmutan entre sí, tenemos que
Estas matrices, cuyos elementos dependen de las diferencias de índice de esta manera, se denominan matrices de Toeplitz y pueden reconstruirse a partir de los elementos de la primera fila indexados por .
A continuación, presentamos el circuito, denominado «prueba de intercambio ampliada», que prepara
donde .
Estado de referencia
Preparamos el estado de referencia .
qc_ref = QuantumCircuit(num_qubits)
for i, b in enumerate(reversed(ref_bitstring)):
    if b == "1":
        qc_ref.x(i)
display(qc_ref.draw("mpl", scale=0.5))
Output:

Evolución temporal
Calcula el operador de evolución temporal generado por el hamiltoniano, aproximado mediante una simple «lie-trotterización».
t = Parameter("t")

evol_gate = PauliEvolutionGate(
    hamiltonian,
    time=t,
    synthesis=LieTrotter(reps=num_trotter_steps),
    label="U(t)",
)

# Synthesize U(t) first and then control the synthesized circuit.
# This makes the controlled structure visible in the circuit drawer.
evolution_circuit = QuantumCircuit(num_qubits, name="U(t)")
evolution_circuit.append(evol_gate, range(num_qubits))
evolution_circuit = simple_transpilation(evolution_circuit)

# Make a controlled version of the evolution circuit.
controlled_evolution_gate = evolution_circuit.to_gate(label="U(t)").control(
    1, label="C-U(t)"
)
display(
    evolution_circuit.assign_parameters({t: 1.5}).draw(
        "mpl", scale=0.5, fold=-1
    )
)
Output:

Circuito de prueba de intercambio ampliado [3]
El circuito prepara primero el estado de referencia en el registro del sistema mientras la ancilla permanece en « »:
A continuación, al aplicar una puerta de Hadamard a la ancilla se crea una superposición coherente de dos ramas:
Por último, se aplica la puerta de evolución temporal controlada:
solo cuando la ancilla se encuentre en la rama « ». Por tanto,
En el siguiente bloque de código, implementamos:
que se asignará como « » para « » en el paso de ejecución.
ancilla = 0
system_qubits = list(range(1, num_qubits + 1))

extended_swap_test = QuantumCircuit(num_qubits + 1)

# Append state preparation part
extended_swap_test = extended_swap_test.compose(qc_ref, system_qubits)

# Prepare the coherent branch label, (|0> + |1>) / sqrt(2).
extended_swap_test.h(ancilla)

# Apply U(t) only to the |1> branch of the ancilla.
extended_swap_test.append(
    controlled_evolution_gate, [ancilla] + system_qubits
)

# Decompose once more for visualization so that control bullets are visible.
display(extended_swap_test.draw("mpl", fold=-1))
Output:

Observables
Para cualquier sistema hermítico con observables , aquí establecemos los observables que se van a calcular:
Esto se debe a que proporciona el elemento de solapamiento , mientras que proporciona el elemento hamiltoniano .
Aplicando la regla de o, tenemos que
Del mismo modo, utilizando ,
Por lo tanto, tenemos que
Por último, para cada estado , debemos medir:
n_qubits = hamiltonian.num_qubits

observable_labels = [
    "Re S_0d",
    "Im S_0d",
    "Re H_0d",
    "Im H_0d",
]

# X ⊗ I and Y ⊗ I.
# Qiskit's Pauli-label convention places qubit 0 on the rightmost character,
# so the ancilla Pauli is appended to the right.
obs_x_identity = SparsePauliOp("I" * n_qubits + "X")
obs_y_identity = SparsePauliOp("I" * n_qubits + "Y")

# X ⊗ H and Y ⊗ H.
obs_x_hamiltonian = SparsePauliOp.from_list(
    [
        (label + "X", coeff)
        for label, coeff in zip(
            hamiltonian.paulis.to_labels(),
            hamiltonian.coeffs,
        )
    ]
)

obs_y_hamiltonian = SparsePauliOp.from_list(
    [
        (label + "Y", coeff)
        for label, coeff in zip(
            hamiltonian.paulis.to_labels(),
            hamiltonian.coeffs,
        )
    ]
)

observables = [
    obs_x_identity,
    obs_y_identity,
    obs_x_hamiltonian,
    obs_y_hamiltonian,
]

for obs, label in zip(observables, observable_labels):
    print(f"Observable: {label}")
    print(obs)
    print()
Output:
Observable: Re S_0d
SparsePauliOp(['IIIIIIIIIIIIX'],
              coeffs=[1.+0.j])

Observable: Im S_0d
SparsePauliOp(['IIIIIIIIIIIIY'],
              coeffs=[1.+0.j])

Observable: Re H_0d
SparsePauliOp(['IIIIIIIIIIXXX', 'IIIIIIIIIXXIX', 'IIIIIIIIXXIIX', 'IIIIIIIXXIIIX', 'IIIIIIXXIIIIX', 'IIIIIXXIIIIIX', 'IIIIXXIIIIIIX', 'IIIXXIIIIIIIX', 'IIXXIIIIIIIIX', 'IXXIIIIIIIIIX', 'XXIIIIIIIIIIX', 'IIIIIIIIIIYYX', 'IIIIIIIIIYYIX', 'IIIIIIIIYYIIX', 'IIIIIIIYYIIIX', 'IIIIIIYYIIIIX', 'IIIIIYYIIIIIX', 'IIIIYYIIIIIIX', 'IIIYYIIIIIIIX', 'IIYYIIIIIIIIX', 'IYYIIIIIIIIIX', 'YYIIIIIIIIIIX', 'IIIIIIIIIIZZX', 'IIIIIIIIIZZIX', 'IIIIIIIIZZIIX', 'IIIIIIIZZIIIX', 'IIIIIIZZIIIIX', 'IIIIIZZIIIIIX', 'IIIIZZIIIIIIX', 'IIIZZIIIIIIIX', 'IIZZIIIIIIIIX', 'IZZIIIIIIIIIX', 'ZZIIIIIIIIIIX'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])

Observable: Im H_0d
SparsePauliOp(['IIIIIIIIIIXXY', 'IIIIIIIIIXXIY', 'IIIIIIIIXXIIY', 'IIIIIIIXXIIIY', 'IIIIIIXXIIIIY', 'IIIIIXXIIIIIY', 'IIIIXXIIIIIIY', 'IIIXXIIIIIIIY', 'IIXXIIIIIIIIY', 'IXXIIIIIIIIIY', 'XXIIIIIIIIIIY', 'IIIIIIIIIIYYY', 'IIIIIIIIIYYIY', 'IIIIIIIIYYIIY', 'IIIIIIIYYIIIY', 'IIIIIIYYIIIIY', 'IIIIIYYIIIIIY', 'IIIIYYIIIIIIY', 'IIIYYIIIIIIIY', 'IIYYIIIIIIIIY', 'IYYIIIIIIIIIY', 'YYIIIIIIIIIIY', 'IIIIIIIIIIZZY', 'IIIIIIIIIZZIY', 'IIIIIIIIZZIIY', 'IIIIIIIZZIIIY', 'IIIIIIZZIIIIY', 'IIIIIZZIIIIIY', 'IIIIZZIIIIIIY', 'IIIZZIIIIIIIY', 'IIZZIIIIIIIIY', 'IZZIIIIIIIIIY', 'ZZIIIIIIIIIIY'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])
Para la estimación de los elementos de la matriz « », el número de términos de Pauli es mucho mayor que el de los elementos de la matriz « ».
Ahora podemos reducir el número de términos del hamiltoniano medidos utilizando una técnica de desplazamiento [4]. Descomponemos el hamiltoniano de la siguiente manera:
donde se elige de tal forma que el estado de referencia sea su estado propio,
A continuación,
Donde:
es el elemento de la matriz hamiltoniana desplazado. Por lo tanto, solo necesitamos medir y . La contribución de se reconstruye de forma clásica utilizando el elemento de la matriz de solapamiento ya medido .
En este ejemplo, una opción obvia es la parte diagonal del hamiltoniano de Heisenberg,
Dado que el estado de referencia es un estado de base computacional, es un estado propio de cada término « ».
Sin embargo, una opción más ventajosa consiste en incluir no solo los términos diagonales , sino también los términos que aniquilan el estado de referencia.
Para cada par de vecinos, el operador « » cumple que
y
Por lo tanto, el término « » solo contribuye cuando los dos qubits adyacentes presentan ocupaciones diferentes en la cadena de bits de referencia. Si los dos qubits están ambos en estado « » o ambos en estado « », el término aniquila el estado de referencia y también puede eliminarse.
Sea , donde . Por lo tanto, podemos elegir
Este operador sigue cumpliendo
porque los términos « » actúan en diagonal sobre « », mientras que los términos desplazados « » dan cero. Por lo tanto, el valor propio correspondiente viene determinado únicamente por los términos « »,
Con esta elección, el hamiltoniano desplazado queda así:
Por lo tanto, solo es necesario medir los bordes con ocupaciones diferentes en el estado de referencia. Todos los términos de y todos los términos inactivos de se reconstruyen mediante la contribución de solapamiento , o bien aportan una contribución nula por definición.
Esto da lugar a un observable menor que si solo se desplazara la parte diagonal. En concreto, para un estado de referencia de base computacional con una excitación localizada, solo los bordes adyacentes a la excitación permanecen en . Por lo tanto, el número de términos de Pauli en y puede reducirse considerablemente, mientras que el elemento de matriz reconstruido
sigue siendo exactamente igual.
def make_reduced_heisenberg_observables(
    ref_bitstring: str,
    coupling: float = 1.0,
) -> tuple[SparsePauliOp, SparsePauliOp, float]:
    """Build X⊗(H-T), Y⊗(H-T), and tau."""
    n_qubits = len(ref_bitstring)

    shifted_terms: list[tuple[str, complex]] = []
    tau = 0.0

    def bit(q: int) -> str:
        return ref_bitstring[n_qubits - 1 - q]

    def append_term(q0: int, q1: int, pauli: str):
        label = ["I"] * n_qubits
        label[n_qubits - 1 - q0] = pauli[0]
        label[n_qubits - 1 - q1] = pauli[1]
        shifted_terms.append(("".join(label), coupling))

    for q in range(n_qubits - 1):
        same_occupation = bit(q) == bit(q + 1)

        # ZZ contribution to tau
        tau += coupling * (1.0 if same_occupation else -1.0)

        # XX + YY survives only for opposite occupations.
        if not same_occupation:
            append_term(q, q + 1, "XX")
            append_term(q, q + 1, "YY")

    if shifted_terms:
        obs_x_shifted_hamiltonian = SparsePauliOp.from_list(
            [(label + "X", coeff) for label, coeff in shifted_terms]
        )
        obs_y_shifted_hamiltonian = SparsePauliOp.from_list(
            [(label + "Y", coeff) for label, coeff in shifted_terms]
        )
    else:
        obs_x_shifted_hamiltonian = SparsePauliOp(
            "I" * n_qubits + "X", coeffs=[0.0]
        )
        obs_y_shifted_hamiltonian = SparsePauliOp(
            "I" * n_qubits + "Y", coeffs=[0.0]
        )

    return obs_x_shifted_hamiltonian, obs_y_shifted_hamiltonian, tau


obs_x_shifted_hamiltonian, obs_y_shifted_hamiltonian, shift_tau = (
    make_reduced_heisenberg_observables(ref_bitstring)
)

print("Observable: Re shifted H_0d")
print(obs_x_shifted_hamiltonian)
print()

print("Observable: Im shifted H_0d")
print(obs_y_shifted_hamiltonian)
print()

print("tau =", shift_tau)

observables = [
    obs_x_identity,
    obs_y_identity,
    obs_x_shifted_hamiltonian,
    obs_y_shifted_hamiltonian,
]
observable_labels = [
    "Re S_0d",
    "Im S_0d",
    "Re shifted H_0d",
    "Im shifted H_0d",
]
Output:
Observable: Re shifted H_0d
SparsePauliOp(['IIIIIXXIIIIIX', 'IIIIIYYIIIIIX', 'IIIIXXIIIIIIX', 'IIIIYYIIIIIIX'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])

Observable: Im shifted H_0d
SparsePauliOp(['IIIIIXXIIIIIY', 'IIIIIYYIIIIIY', 'IIIIXXIIIIIIY', 'IIIIYYIIIIIIY'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])

tau = 7.0
Paso 2: Optimizar el problema para la ejecución en hardware cuántico
Ahora convertimos el circuito abstracto de la prueba de intercambio ampliada en una plantilla orientada al hardware. Antes de eso, optimizamos aún más el circuito, en primer lugar a nivel abstracto.
Comparación del orden de los términos del hamiltoniano
En primer lugar, comparamos diferentes ordenaciones de los términos de Pauli en el hamiltoniano de Heisenberg para la simulación hamiltoniana. El hamiltoniano en sí no sufre cambios, pero el orden influye en cómo se genera el circuito de fórmula de producto y en qué medida se puede paralelizar la estructura en el circuito. Por ejemplo, el orden ingenuo enumera primero todos los términos de «vecino más cercano» ( ), luego todos los términos de «enlace de tipo» ( ) y, por último, todos los términos de «enlace de tipo» ( ). Esto hace que los bordes adyacentes, como y , queden uno al lado del otro, por lo que no pueden ejecutarse en paralelo. El orden «par-impar» visita primero los bordes pares disjuntos y, a continuación, los bordes impares, lo que deja al descubierto capas paralelas de dos qubits. El orden por grupos de aristas pares e impares va un paso más allá: para cada arista, mantiene juntos los términos locales , y , sin dejar de visitar las aristas pares antes que las impares. Esperamos que las ordenaciones «par-impar» y «par-impar» agrupadas por aristas reduzcan la profundidad del circuito al exponer capas paralelas de dos qubits, y que la ordenación agrupada por aristas reduzca además el error de Trotter, ya que la interacción local de dos qubits en una misma arista se trata como un bloque compacto.

El orden del hamiltoniano también influye en el error de Trotter. Si colocamos términos no conmutativos uno al lado del otro, las transiciones de base se producen con mayor frecuencia, lo que da lugar a un mayor error de Trotter. Al agrupar los términos que requieren la misma transformación de la base de Pauli, se pueden evitar los cambios de base redundantes.
En este caso, la comparación utiliza el tiempo de evolución más largo que aparece en las estimaciones de Krylov de la primera fila, utilizando la misma condición de transpilación.
Para medir el error de Trotter, utilizamos la infidelidad del proceso entre el circuito «trotterizado» y la evolución hamiltoniana exacta,
donde es la dimensión del espacio de Hilbert.
Este diagnóstico utiliza matrices densas, por lo que resulta adecuado para este pequeño ejemplo de 12 qubits, pero no está pensado como una subrutina escalable.
# The comparison uses the largest time that appears in the first-row Krylov estimates.
# Circuit depth does not depend on this numeric value, but the Trotter error does.
comparison_time = (krylov_dim - 1) * dt


def make_heisenberg_hamiltonian_ordered(
    num_qubits: int,
    ordering: str,
    coupling: float = 1.0,
) -> SparsePauliOp:
    """Return the same Heisenberg Hamiltonian with a specified term ordering."""
    terms: list[tuple[str, complex]] = []
    even_edges = [(q, q + 1) for q in range(0, num_qubits - 1, 2)]
    odd_edges = [(q, q + 1) for q in range(1, num_qubits - 1, 2)]

    def append_term(q0: int, q1: int, pauli: str):
        label = ["I"] * num_qubits
        label[num_qubits - 1 - q0] = pauli[0]
        label[num_qubits - 1 - q1] = pauli[1]
        terms.append(("".join(label), coupling))

    if ordering == "naive":
        for pauli in ("XX", "YY", "ZZ"):
            for q in range(num_qubits - 1):
                append_term(q, q + 1, pauli)
    elif ordering == "even-then-odd":
        for pauli in ("XX", "YY", "ZZ"):
            for q0, q1 in even_edges + odd_edges:
                append_term(q0, q1, pauli)
    elif ordering == "even-odd edge-grouped":
        for q0, q1 in even_edges + odd_edges:
            for pauli in ("XX", "YY", "ZZ"):
                append_term(q0, q1, pauli)
    else:
        raise ValueError(f"Unknown ordering: {ordering}")

    return SparsePauliOp.from_list(terms).simplify()


def build_numeric_evolution_circuit(
    hamiltonian: SparsePauliOp,
    synthesis,
    time_value: float,
    **synthesis_kwargs,
) -> QuantumCircuit:
    """Build a numeric circuit for exp(-i H t) with a chosen synthesis rule."""
    evolution_gate = PauliEvolutionGate(
        hamiltonian,
        time=time_value,
        synthesis=synthesis(**synthesis_kwargs),
    )
    circuit = QuantumCircuit(hamiltonian.num_qubits)
    circuit.append(evolution_gate, range(hamiltonian.num_qubits))
    return circuit


def process_infidelity(
    circuit: QuantumCircuit,
    exact_matrix: np.ndarray,
) -> float:
    """Return 1 - |Tr(U_circuit† U_exact) / d|²."""
    circuit_matrix = np.asarray(Operator(circuit).data)
    dim = circuit_matrix.shape[0]
    normalized_trace = np.vdot(circuit_matrix, exact_matrix) / dim
    fidelity = np.abs(normalized_trace) ** 2
    return float(np.clip(1.0 - fidelity, 0.0, 1.0))


hamiltonians_by_ordering = {
    ordering: make_heisenberg_hamiltonian_ordered(
        num_qubits, ordering, coupling=1.0
    )
    for ordering in ["naive", "even-then-odd", "even-odd edge-grouped"]
}

print(f"Comparison time: {comparison_time}\n")

for order_name, ham_ordered in hamiltonians_by_ordering.items():
    print(f"{order_name}:")
    print([op for op, _ in ham_ordered.to_list()])
    print()

print("Precomputing the exact evolution operator... ", end="")
exact_matrix = la.expm(-1j * comparison_time * hamiltonian.to_matrix())
print("Done")
Output:
Comparison time: 0.8567979964335799

naive:
['IIIIIIIIIIXX', 'IIIIIIIIIXXI', 'IIIIIIIIXXII', 'IIIIIIIXXIII', 'IIIIIIXXIIII', 'IIIIIXXIIIII', 'IIIIXXIIIIII', 'IIIXXIIIIIII', 'IIXXIIIIIIII', 'IXXIIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIIYYI', 'IIIIIIIIYYII', 'IIIIIIIYYIII', 'IIIIIIYYIIII', 'IIIIIYYIIIII', 'IIIIYYIIIIII', 'IIIYYIIIIIII', 'IIYYIIIIIIII', 'IYYIIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIIZZI', 'IIIIIIIIZZII', 'IIIIIIIZZIII', 'IIIIIIZZIIII', 'IIIIIZZIIIII', 'IIIIZZIIIIII', 'IIIZZIIIIIII', 'IIZZIIIIIIII', 'IZZIIIIIIIII', 'ZZIIIIIIIIII']

even-then-odd:
['IIIIIIIIIIXX', 'IIIIIIIIXXII', 'IIIIIIXXIIII', 'IIIIXXIIIIII', 'IIXXIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIXXI', 'IIIIIIIXXIII', 'IIIIIXXIIIII', 'IIIXXIIIIIII', 'IXXIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIYYII', 'IIIIIIYYIIII', 'IIIIYYIIIIII', 'IIYYIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIYYI', 'IIIIIIIYYIII', 'IIIIIYYIIIII', 'IIIYYIIIIIII', 'IYYIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIZZII', 'IIIIIIZZIIII', 'IIIIZZIIIIII', 'IIZZIIIIIIII', 'ZZIIIIIIIIII', 'IIIIIIIIIZZI', 'IIIIIIIZZIII', 'IIIIIZZIIIII', 'IIIZZIIIIIII', 'IZZIIIIIIIII']

even-odd edge-grouped:
['IIIIIIIIIIXX', 'IIIIIIIIIIYY', 'IIIIIIIIIIZZ', 'IIIIIIIIXXII', 'IIIIIIIIYYII', 'IIIIIIIIZZII', 'IIIIIIXXIIII', 'IIIIIIYYIIII', 'IIIIIIZZIIII', 'IIIIXXIIIIII', 'IIIIYYIIIIII', 'IIIIZZIIIIII', 'IIXXIIIIIIII', 'IIYYIIIIIIII', 'IIZZIIIIIIII', 'XXIIIIIIIIII', 'YYIIIIIIIIII', 'ZZIIIIIIIIII', 'IIIIIIIIIXXI', 'IIIIIIIIIYYI', 'IIIIIIIIIZZI', 'IIIIIIIXXIII', 'IIIIIIIYYIII', 'IIIIIIIZZIII', 'IIIIIXXIIIII', 'IIIIIYYIIIII', 'IIIIIZZIIIII', 'IIIXXIIIIIII', 'IIIYYIIIIIII', 'IIIZZIIIIIII', 'IXXIIIIIIIII', 'IYYIIIIIIIII', 'IZZIIIIIIIII']

Precomputing the exact evolution operator... Done
En primer lugar, mantenemos la regla de síntesis fija en un paso de Trotter de primer orden y variamos únicamente el orden de los términos de Pauli. El objetivo principal de esta comparación es comprobar en qué medida se pueden reducir la profundidad del circuito y el coste por dos qubits al exponer al transpiler los bordes disjuntos de vecinos más cercanos.
ordering_comparison_rows = []
infidelity_reps = [1, 2, 4, 8]

for ordering, ham_ordered in hamiltonians_by_ordering.items():
    for reps in infidelity_reps:
        circuit = build_numeric_evolution_circuit(
            ham_ordered,
            LieTrotter,
            comparison_time,
            reps=reps,
        )
        decomposed_circuit = simple_transpilation(circuit)
        infidelity = process_infidelity(decomposed_circuit, exact_matrix)
        ordering_comparison_rows.append(
            {
                "ordering": ordering,
                "synthesis": f"LieTrotter(reps={reps})",
                "infidelity": infidelity,
                **summarize_circuit(decomposed_circuit),
            }
        )
        if reps == 1:
            print(f"Circuit for {ordering} ordering:")
            print([op for op, _ in ham_ordered.to_list()])
            display(decomposed_circuit.draw("mpl", fold=-1, scale=0.6))

ordering_comparison_df = pd.DataFrame(ordering_comparison_rows)
display(ordering_comparison_df)

hamiltonian_for_synthesis = hamiltonians_by_ordering["even-odd edge-grouped"]
Output:
Circuit for naive ordering:
['IIIIIIIIIIXX', 'IIIIIIIIIXXI', 'IIIIIIIIXXII', 'IIIIIIIXXIII', 'IIIIIIXXIIII', 'IIIIIXXIIIII', 'IIIIXXIIIIII', 'IIIXXIIIIIII', 'IIXXIIIIIIII', 'IXXIIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIIYYI', 'IIIIIIIIYYII', 'IIIIIIIYYIII', 'IIIIIIYYIIII', 'IIIIIYYIIIII', 'IIIIYYIIIIII', 'IIIYYIIIIIII', 'IIYYIIIIIIII', 'IYYIIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIIZZI', 'IIIIIIIIZZII', 'IIIIIIIZZIII', 'IIIIIIZZIIII', 'IIIIIZZIIIII', 'IIIIZZIIIIII', 'IIIZZIIIIIII', 'IIZZIIIIIIII', 'IZZIIIIIIIII', 'ZZIIIIIIIIII']

Circuit for even-then-odd ordering:
['IIIIIIIIIIXX', 'IIIIIIIIXXII', 'IIIIIIXXIIII', 'IIIIXXIIIIII', 'IIXXIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIXXI', 'IIIIIIIXXIII', 'IIIIIXXIIIII', 'IIIXXIIIIIII', 'IXXIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIYYII', 'IIIIIIYYIIII', 'IIIIYYIIIIII', 'IIYYIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIYYI', 'IIIIIIIYYIII', 'IIIIIYYIIIII', 'IIIYYIIIIIII', 'IYYIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIZZII', 'IIIIIIZZIIII', 'IIIIZZIIIIII', 'IIZZIIIIIIII', 'ZZIIIIIIIIII', 'IIIIIIIIIZZI', 'IIIIIIIZZIII', 'IIIIIZZIIIII', 'IIIZZIIIIIII', 'IZZIIIIIIIII']

Circuit for even-odd edge-grouped ordering:
['IIIIIIIIIIXX', 'IIIIIIIIIIYY', 'IIIIIIIIIIZZ', 'IIIIIIIIXXII', 'IIIIIIIIYYII', 'IIIIIIIIZZII', 'IIIIIIXXIIII', 'IIIIIIYYIIII', 'IIIIIIZZIIII', 'IIIIXXIIIIII', 'IIIIYYIIIIII', 'IIIIZZIIIIII', 'IIXXIIIIIIII', 'IIYYIIIIIIII', 'IIZZIIIIIIII', 'XXIIIIIIIIII', 'YYIIIIIIIIII', 'ZZIIIIIIIIII', 'IIIIIIIIIXXI', 'IIIIIIIIIYYI', 'IIIIIIIIIZZI', 'IIIIIIIXXIII', 'IIIIIIIYYIII', 'IIIIIIIZZIII', 'IIIIIXXIIIII', 'IIIIIYYIIIII', 'IIIIIZZIIIII', 'IIIXXIIIIIII', 'IIIYYIIIIIII', 'IIIZZIIIIIII', 'IXXIIIIIIIII', 'IYYIIIIIIIII', 'IZZIIIIIIIII']

En reps=1, observamos que tanto las ordenaciones «par-impar» como las «par-impar» agrupadas por aristas reducen la profundidad de 15 a 6 al dejar al descubierto capas paralelas de dos qubits, mientras que el número de puertas de dos qubits se mantiene igual en las tres ordenaciones.
Sin embargo, las tres ordenaciones tienen una infidelidad cercana a 1, por lo que variamos el número de repeticiones de Trotter para diferenciar las ordenaciones con mayor claridad.
A medida que aumenta el número de repeticiones, la «infidelidad» del orden even-odd edge-grouped disminuye más rápidamente que las otras dos, alcanzando un valor de 0.045 en reps=8 frente a 0.075 en el caso del orden «naïve» y del orden «par-impar», respectivamente.
Comparación de la síntesis de fórmulas de productos
A continuación, analizamos diferentes parámetros avanzados de la «trotterización», pasando del ordenamiento hamiltoniano fijo al ordenamiento por grupos de aristas pares-impares. Consideramos el modelo de Lie-Trotter de primer orden, el de Suzuki-Trotter de segundo orden y el de Suzuki-Trotter de cuarto orden.
synthesis_comparison_rows = []

for num_trotter_steps in [1, 2, 3, 4, 5]:
    synthesis_cases = [
        ("LieTrotter", LieTrotter, {"reps": num_trotter_steps}),
        (
            "SuzukiTrotter(order=2)",
            SuzukiTrotter,
            {"order": 2, "reps": num_trotter_steps},
        ),
        (
            "SuzukiTrotter(order=4)",
            SuzukiTrotter,
            {"order": 4, "reps": num_trotter_steps},
        ),
    ]
    for label, synthesis, kwargs in synthesis_cases:
        circuit = build_numeric_evolution_circuit(
            hamiltonian_for_synthesis,
            synthesis,
            comparison_time,
            **kwargs,
        )
        decomposed_circuit = simple_transpilation(circuit)
        synthesis_comparison_rows.append(
            {
                "synthesis": label,
                "reps": kwargs["reps"],
                "infidelity": process_infidelity(
                    decomposed_circuit, exact_matrix
                ),
                **summarize_circuit(decomposed_circuit),
            }
        )

synthesis_comparison_df = pd.DataFrame(synthesis_comparison_rows)
display(synthesis_comparison_df.sort_values(["2q gates", "2q depth"]))

# For memory free
exact_matrix = None
Output:
El método de Lie-Trotter ofrece el circuito menos profundo, pero presenta el mayor error, mientras que el método de Suzuki-Trotter de cuarto orden es más preciso, aunque aumenta la profundidad del circuito. Para el resto del tutorial, elegimos el método de Suzuki-Trotter de segundo orden, ya que ofrece un circuito de poca profundidad y, al mismo tiempo, reduce considerablemente el error de Trotter en comparación con la fórmula de primer orden.
Eliminar la puerta de evolución temporal controlada
En la prueba de intercambio ampliada, controlar la evolución temporal con un único qubit auxiliar requiere que este controle numerosas puertas en todo el sistema. Esto puede generar una sobrecarga considerable en el enrutamiento y, en el peor de los casos, exige, en la práctica, una conectividad «todos a uno». Para evitarlo, es posible llevar a cabo una optimización adicional sustituyendo la puerta de evolución temporal controlada por una versión sin control, aprovechando la simetría del hamiltoniano. Observemos el siguiente circuito.

Aquí, prepara el estado de referencia, .
En lugar de preparar primero y, a continuación, aplicar únicamente a la rama , el circuito prepara directamente las dos ramas de la siguiente manera:
donde
El circuito aplica primero una puerta de Hadamard al sistema auxiliar y prepara el estado de referencia únicamente en la rama « »:
A continuación, se aplica el operador de evolución temporal no controlado a ambas ramas:
Dado que el hamiltoniano conserva el número de excitación, podemos observar que es su estado propio y, por lo tanto, el operador de evolución solo acumula una fase bajo el hamiltoniano:
Por tanto,
A continuación, se aplica « » únicamente en la rama « ».
En este punto, las dos ramas presentan una fase relativa adicional. Para eliminarlo, aplicamos la puerta de fase ancilla
Esto transforma el estado de la siguiente manera:
Así pues, hasta una fase global irrelevante, finalmente preparamos
En el siguiente bloque de código, implementamos este circuito sin controles.
controlled_extended_swap_test = extended_swap_test

# Reuse the ordering and synthesis rule selected by the comparison above.
evol_gate_optimized = PauliEvolutionGate(
    hamiltonian_for_synthesis,
    time=t,
    synthesis=SuzukiTrotter(order=2, reps=num_trotter_steps),
)

uncontrolled_evolution = QuantumCircuit(num_qubits, name="U_ST2(t)")
uncontrolled_evolution.append(evol_gate_optimized, range(num_qubits))

controlled_state_prep = QuantumCircuit(num_qubits + 1, name="C-Prep")
for q, bit in enumerate(reversed(ref_bitstring)):
    if bit == "1":
        controlled_state_prep.cx(ancilla, system_qubits[q])

vacuum_bitstring = "0" * num_qubits
vacuum_energy = basis_state_expectation_sparse(hamiltonian, "0" * num_qubits)

optimized_extended_swap_test = QuantumCircuit(num_qubits + 1)
optimized_extended_swap_test.h(ancilla)

# Prepare |psi_ref> only on the |1> branch.
optimized_extended_swap_test.compose(controlled_state_prep, inplace=True)
optimized_extended_swap_test.barrier()

# Apply the Trotterized time evolution without control.
optimized_extended_swap_test.compose(
    uncontrolled_evolution,
    qubits=system_qubits,
    inplace=True,
)
optimized_extended_swap_test.barrier()

# Map |0>|0...0> to |0>|psi_ref>, leaving the |1> branch unchanged.
optimized_extended_swap_test.x(ancilla)
optimized_extended_swap_test.compose(controlled_state_prep, inplace=True)
optimized_extended_swap_test.x(ancilla)

# Cancel the known vacuum phase so that the same X/Y observables can be used.
optimized_extended_swap_test.p(-vacuum_energy * t, ancilla)
optimized_extended_swap_test = simple_transpilation(
    optimized_extended_swap_test
)

print(f"Vacuum energy E_vac = {vacuum_energy:.1f}")
display(
    optimized_extended_swap_test.assign_parameters({t: 1.0}).draw(
        "mpl", scale=0.5, fold=26
    )
)
Output:
Vacuum energy E_vac = 11.0+0.0j

Transpilación
Ahora, compilamos los circuitos controlados y los no controlados para que puedan ejecutarse en el hardware. Comparemos el resultado de los circuitos transpilados.
pass_manager = generate_preset_pass_manager(
    backend=backend,
    optimization_level=3,
)

isa_controlled_extended_swap_test = pass_manager.run(
    controlled_extended_swap_test
)

pass_manager = generate_preset_pass_manager(
    backend=backend, optimization_level=3, routing_method="none"
)
isa_optimized_extended_swap_test = pass_manager.run(
    optimized_extended_swap_test
)

transpilation_result = [
    {
        "label": "abstract controlled U(t)",
        **summarize_circuit(isa_controlled_extended_swap_test),
    },
    {
        "label": "optimized non-controlled U(t)",
        **summarize_circuit(isa_optimized_extended_swap_test),
    },
]

display(pd.DataFrame(transpilation_result))


def filter_qubits_from_layout(layout):
    q_layout = Layout(
        {
            physical: virtual
            for physical, virtual in layout.get_physical_bits().items()
            if virtual._register.name == "q"
        }
    )
    return q_layout


print(
    filter_qubits_from_layout(
        isa_optimized_extended_swap_test.layout.initial_layout
    )
)

isa_observables = [
    op.apply_layout(isa_optimized_extended_swap_test.layout)
    for op in observables
]
Output:
Layout({
18: <Qubit register=(13, "q"), index=0>,
5: <Qubit register=(13, "q"), index=1>,
6: <Qubit register=(13, "q"), index=2>,
7: <Qubit register=(13, "q"), index=3>,
8: <Qubit register=(13, "q"), index=4>,
9: <Qubit register=(13, "q"), index=5>,
10: <Qubit register=(13, "q"), index=6>,
11: <Qubit register=(13, "q"), index=7>,
12: <Qubit register=(13, "q"), index=8>,
13: <Qubit register=(13, "q"), index=9>,
14: <Qubit register=(13, "q"), index=10>,
15: <Qubit register=(13, "q"), index=11>,
19: <Qubit register=(13, "q"), index=12>
})
Paso 3: Ejecutar utilizando Qiskit primitives
El siguiente paso consiste en aplicar el mismo circuito parametrizado a varios valores de . Para cada , estimamos cuatro valores esperados: , , y . A continuación, estos cuatro números se combinan para formar los elementos complejos de la primera fila: y .
En este caso, y pueden calcularse de forma clásica, ya que es una matriz dispersa, por lo que omitimos el caso .
pub_list = []
d_values = list(range(1, krylov_dim))

# Exact local statevector estimator.
estimator = StatevectorEstimator()

# We use the circuit before the transpilation for the local simulator,
# but we will use the transpiled circuit for the real backend.
for d in d_values:
    parameter_values = [d * dt]

    for ob in observables:
        pub_list.append(
            (
                optimized_extended_swap_test,
                ob,
                parameter_values,
            )
        )

job = estimator.run(pub_list)

# Local PrimitiveJob does not provide Runtime-style job inputs,
# so preserve the inputs directly.
inputs = pub_list
result = job.result()

print(f"Number of Krylov basis states: r = {len(d_values)}")
print(f"Number of PUBs: {len(pub_list)}")
print(f"Each d uses observables: {observable_labels}")
Output:
Number of Krylov basis states: r = 9
Number of PUBs: 36
Each d uses observables: ['Re S_0d', 'Im S_0d', 'Re shifted H_0d', 'Im shifted H_0d']
Paso 4: Procesamiento posterior y devolución del resultado en el formato clásico deseado
Tras estimar las matrices proyectadas, regularizamos y resolvemos el GEVP
El valor propio generalizado más pequeño proporciona la estimación KQD de la energía del estado fundamental.
h_shifted_row_est = np.zeros(krylov_dim, dtype=complex)
s_row_est = np.zeros(krylov_dim, dtype=complex)

h_shifted_row_est[0] = ref_energy - shift_tau
s_row_est[0] = 1.0

for idx, (pub_input, pub_result) in enumerate(zip(inputs, result)):
    d_index, obs_index = divmod(idx, len(observables))
    ev = np.asarray(pub_result.data.evs).reshape(-1)[0]
    std = np.asarray(pub_result.data.stds).reshape(-1)[0]

    if obs_index == 0:
        s_row_est[d_index + 1] = ev
    elif obs_index == 1:
        s_row_est[d_index + 1] += 1j * ev
    elif obs_index == 2:
        h_shifted_row_est[d_index + 1] = ev
    elif obs_index == 3:
        h_shifted_row_est[d_index + 1] += 1j * ev

# H_0d = shifted_H_0d + tau * S_0d.
h_row_est = h_shifted_row_est + shift_tau * s_row_est

h_matrix_est = la.toeplitz(h_row_est.conj(), h_row_est)
s_matrix_est = la.toeplitz(s_row_est.conj(), s_row_est)

s_eigvals = la.eigvalsh(0.5 * (s_matrix_est + s_matrix_est.conj().T))
positive_s_eigvals = s_eigvals[s_eigvals > 1e-12]
s_condition_number = (
    positive_s_eigvals[-1] / positive_s_eigvals[0]
    if len(positive_s_eigvals) > 0
    else np.inf
)


with np.printoptions(precision=3, suppress=True):
    print("Estimated first row of S:")
    print(s_row_est)
    print()
    print("Estimated first row of H:")
    print(h_row_est)
    print()
    print("Eigenvalues of the estimated overlap matrix S:")
    print(s_eigvals)
    print(f"Condition number above 1e-12: {s_condition_number:.3e}")
    print()
Output:
Estimated first row of S:
[ 1.   +0.j     0.758-0.596j  0.203-0.836j -0.291-0.636j -0.444-0.229j
 -0.276+0.053j -0.044+0.051j  0.006-0.121j -0.155-0.218j -0.345-0.101j]

Estimated first row of H:
[ 7.   +0.j     4.842-4.76j   0.044-6.185j -3.791-3.653j -4.137+0.39j
 -1.495+2.654j  1.331+1.777j  1.85 -0.763j -0.032-2.278j -2.222-1.372j]

Eigenvalues of the estimated overlap matrix S:
[-0.     0.     0.     0.     0.     0.     0.01   0.355  3.526  6.109]
Condition number above 1e-12: 1.904e+12
Ahora resolvemos el problema de los valores propios generalizados utilizando las matrices reconstruidas a partir de las estimaciones del circuito. En un cálculo ideal del vector de estado con evolución exacta en tiempo real, esto debería reproducir el resultado proyectado exacto. En la práctica, las desviaciones pueden deberse a la «trotterización», al error de muestreo y a la inestabilidad numérica de la matriz de solapamiento.
Observamos cómo la energía converge a medida que aumentamos la dimensión del subespacio de Krylov.
exact_evals = diagonalize_single_1_subspace(hamiltonian)
exact_ground = min(exact_evals)
print("exact ground state energy:  ", exact_ground)

threshold = 1e-12
energy_convergence = []

for r in range(1, krylov_dim + 1):
    energy_est_kqd, coeffs_est, retained_est = solve_thresholded_gevp(
        h_matrix_est[:r, :r],
        s_matrix_est[:r, :r],
        threshold=threshold,
    )
    energy_convergence.append(energy_est_kqd)
    print(
        f"Krylov ground state energy (dim={r}, retained={retained_est}): ",
        energy_est_kqd,
    )
Output:
exact ground state energy:   3.136296694843727
Krylov ground state energy (dim=1, retained=1):  7.0
Krylov ground state energy (dim=2, retained=2):  4.184510657551266
Krylov ground state energy (dim=3, retained=3):  3.5539074630394136
Krylov ground state energy (dim=4, retained=4):  3.3366270761341044
Krylov ground state energy (dim=5, retained=5):  3.252017453225087
Krylov ground state energy (dim=6, retained=6):  3.2300275138879186
Krylov ground state energy (dim=7, retained=7):  3.2299154099085685
Krylov ground state energy (dim=8, retained=7):  3.2298063744216776
Krylov ground state energy (dim=9, retained=7):  3.2296778282872456
Krylov ground state energy (dim=10, retained=8):  3.223647515867734
def plot_energy_convergence(energy_convergence, exact_ground, krylov_dim):
    fig, ax = plt.subplots(figsize=(7, 4.5))

    ax.plot(
        range(1, krylov_dim + 1),
        energy_convergence,
        marker="o",
        label="KQD estimate",
    )

    ax.axhline(
        exact_ground,
        linestyle="--",
        label=f"Exact ground energy = {exact_ground:.6f}",
    )

    ax.set_xlabel("Krylov dimension")
    ax.set_ylabel("Ground-state energy")
    ax.grid(True, alpha=0.3)
    ax.legend()
    plt.tight_layout()
    plt.show()


plot_energy_convergence(energy_convergence, exact_ground, krylov_dim)
Output:

Ejemplo de hardware a gran escala
En la sección anterior se utilizó un modelo de 12 qubits para que la simulación del vector de estado pudiera servir como diagnóstico. Ahora ampliamos el mismo flujo de trabajo KQD a una cadena de Heisenberg de 30 qubits y preparamos la carga de trabajo para su ejecución en un hardwar IBM Quantum.
Pasos 1 a 4 comprimidos en un único bloque de código
Aquí reunimos ahora todos estos detalles en un único flujo de trabajo a mayor escala, que luego se ejecuta en nuestro hardware cuántico real. En esta sección, aplicamos ajustes realistas para la mitigación de errores con el fin de mejorar la fiabilidad de los resultados. Dado que los elementos de la matriz correspondientes a diferentes valores de pueden calcularse en paralelo, utilizamos el modo Batch para ejecutarlos de forma eficiente.
# -------------------------Step 1-------------------------

# Map the classical problem to quantum circuits and observables.
# Problem and KQD parameters.
large_num_qubits = 30
large_krylov_dim = 7
large_num_trotter_steps = 3
large_dt = np.pi / (3 * (large_num_qubits - 1))
large_t = Parameter("t_large")

# Use a single excitation near the center of the chain.
large_excitation_qubit = large_num_qubits // 2
large_ref_label = ["0"] * large_num_qubits
large_ref_label[large_num_qubits - 1 - large_excitation_qubit] = "1"
large_ref_bitstring = "".join(large_ref_label)

# Use the ordering and product formula selected in the preceding section.
large_hamiltonian = make_heisenberg_hamiltonian_ordered(
    large_num_qubits,
    ordering="even-odd edge-grouped",
    coupling=1.0,
)
large_ref_energy = float(
    np.real(
        basis_state_expectation_sparse(large_hamiltonian, large_ref_bitstring)
    )
)
large_vacuum_energy = float(
    np.real(
        basis_state_expectation_sparse(
            large_hamiltonian, "0" * large_num_qubits
        )
    )
)

large_evolution_gate = PauliEvolutionGate(
    large_hamiltonian,
    time=large_t,
    synthesis=SuzukiTrotter(order=2, reps=large_num_trotter_steps),
)
large_uncontrolled_evolution = QuantumCircuit(
    large_num_qubits,
    name="U_ST2_large(t)",
)
large_uncontrolled_evolution.append(
    large_evolution_gate,
    range(large_num_qubits),
)

# Build the control-free extended-swap-test circuit.
large_ancilla = 0
large_system_qubits = list(range(1, large_num_qubits + 1))

large_controlled_state_prep = QuantumCircuit(
    large_num_qubits + 1,
    name="C-Prep-large",
)
large_controlled_state_prep.cx(
    large_ancilla,
    large_system_qubits[large_excitation_qubit],
)

large_extended_swap_test = QuantumCircuit(large_num_qubits + 1)
large_extended_swap_test.h(large_ancilla)
large_extended_swap_test.compose(large_controlled_state_prep, inplace=True)
large_extended_swap_test.compose(
    large_uncontrolled_evolution,
    qubits=large_system_qubits,
    inplace=True,
)
large_extended_swap_test.x(large_ancilla)
large_extended_swap_test.compose(
    large_controlled_state_prep.inverse(),
    inplace=True,
)
large_extended_swap_test.x(large_ancilla)
large_extended_swap_test.p(
    -large_vacuum_energy * large_t,
    large_ancilla,
)

# Reuse the Hamiltonian-shifting construction from the preceding section.
(
    large_obs_x_shifted_hamiltonian,
    large_obs_y_shifted_hamiltonian,
    large_shift_tau,
) = make_reduced_heisenberg_observables(large_ref_bitstring)

large_observables = [
    SparsePauliOp("I" * large_num_qubits + "X"),
    SparsePauliOp("I" * large_num_qubits + "Y"),
    large_obs_x_shifted_hamiltonian,
    large_obs_y_shifted_hamiltonian,
]
large_observable_labels = [
    "Re S_0d",
    "Im S_0d",
    "Re shifted H_0d",
    "Im shifted H_0d",
]

# -------------------------Step 2-------------------------

# Optimize the problem for quantum execution.
# Select a real backend and transpile the parameterized circuit to ISA form.
large_backend = service.backend("ibm_boston")
large_pass_manager = generate_preset_pass_manager(
    backend=large_backend, optimization_level=3, routing_method="none"
)
large_isa_circuit = large_pass_manager.run(large_extended_swap_test)
large_isa_observables = [
    observable.apply_layout(large_isa_circuit.layout)
    for observable in large_observables
]

large_two_qubit_gate_count = sum(
    instruction.operation.num_qubits == 2
    for instruction in large_isa_circuit.data
)

print(f"Backend: {large_backend.name}")
print(f"System qubits: {large_num_qubits}")
print(f"Total circuit qubits: {large_isa_circuit.num_qubits}")
print(f"Krylov dimension: {large_krylov_dim}")
print(f"Time step: {large_dt:.6f}")
print(f"Shift tau: {large_shift_tau}")
print(f"ISA circuit depth: {large_isa_circuit.depth()}")
print(f"ISA two-qubit gates: {large_two_qubit_gate_count}")
print(
    f"ISA two-qubit depth: {large_isa_circuit.depth(lambda x: x[0].num_qubits == 2)}"
)

# -------------------------Step 3-------------------------

# Execute on quantum hardware with Qiskit Runtime primitives.
# Submit one job per d, with all four observables in that job.
large_d_values = list(range(1, large_krylov_dim))
retrieve_batch_id = None
large_jobs = []

if retrieve_batch_id is None:
    large_estimator_options = {
        "default_shots": 8192,
        "dynamical_decoupling": {
            "enable": True,
            "sequence_type": "XpXm",
        },
        "resilience": {
            "measure_mitigation": True,
            "measure_noise_learning": {
                "num_randomizations": 32,
                "shots_per_randomization": 256,
            },
            "layer_noise_learning": {
                "max_layers_to_learn": 4,
                "layer_pair_depths": [0, 1, 2, 4, 16, 32],
                "num_randomizations": 32,
                "shots_per_randomization": 128,
            },
            "zne_mitigation": True,
            "zne": {
                "amplifier": "pea",
                "noise_factors": [1.0, 1.5, 2.0],
                "extrapolator": ("exponential", "linear"),
            },
        },
        "twirling": {
            "enable_gates": True,
            "enable_measure": True,
            "num_randomizations": 32,
            "shots_per_randomization": 256,
            "strategy": "active-accum",
        },
    }

    with Batch(backend=large_backend) as large_batch:
        large_batch_id = large_batch.session_id
        large_estimator = EstimatorV2(
            mode=large_batch,
            options=large_estimator_options,
        )
        # Krylov quantum diagonalization of lattice Hamiltonians -> TUT_KQDOLH.
        large_estimator.options.environment.job_tags = ["TUT_KQDOLH"]

        for d in large_d_values:
            parameter_values = [d * large_dt]
            pubs_for_d = [
                (large_isa_circuit, observable, parameter_values)
                for observable in large_isa_observables
            ]
            job = large_estimator.run(pubs_for_d)
            large_jobs.append(job)
            print(
                f"Submitted d={d}: job_id={job.job_id()}, "
                f"PUBs={len(pubs_for_d)}"
            )

    print(f"Batch ID: {large_batch_id}")
else:
    large_batch_id = retrieve_batch_id
    large_jobs = service.jobs(
        session_id=large_batch_id,
        limit=None,
        descending=False,
    )

large_job_ids_by_d = {
    d: job.job_id() for d, job in zip(large_d_values, large_jobs)
}
print(f"Job IDs by d: {large_job_ids_by_d}")

# -------------------------Step 4-------------------------

# Post-process the quantum results and solve the classical GEVP.
# Reconstruct the first rows of S and the shifted Hamiltonian matrix.
large_s_row_est = np.zeros(large_krylov_dim, dtype=complex)
large_h_shifted_row_est = np.zeros(large_krylov_dim, dtype=complex)
large_s_row_est[0] = 1.0
large_h_shifted_row_est[0] = large_ref_energy - large_shift_tau

for d, job in zip(large_d_values, large_jobs):
    job_result = job.result()

    if len(job_result) != len(large_observables):
        raise RuntimeError(
            f"Expected {len(large_observables)} PUB results for d={d}, "
            f"but received {len(job_result)}."
        )

    expectation_values = [
        np.asarray(pub_result.data.evs).reshape(-1)[0]
        for pub_result in job_result
    ]

    large_s_row_est[d] = expectation_values[0] + 1j * expectation_values[1]
    large_h_shifted_row_est[d] = (
        expectation_values[2] + 1j * expectation_values[3]
    )

# H_0d = shifted_H_0d + tau * S_0d.
large_h_row_est = large_h_shifted_row_est + large_shift_tau * large_s_row_est

large_s_matrix_est = la.toeplitz(
    large_s_row_est.conj(),
    large_s_row_est,
)
large_h_matrix_est = la.toeplitz(
    large_h_row_est.conj(),
    large_h_row_est,
)

large_exact_gnd = min(diagonalize_single_1_subspace(large_hamiltonian))

large_energy_convergence = []

with np.printoptions(precision=5, suppress=True):
    print("Estimated first row of S:")
    print(large_s_row_est)
    print("Estimated first row of H:")
    print(large_h_row_est)
    print("exact ground state energy:  ", large_exact_gnd)

    for r in range(1, large_krylov_dim + 1):
        energy_est_kqd, coeffs_est, retained_est = solve_thresholded_gevp(
            large_h_matrix_est[:r, :r],
            large_s_matrix_est[:r, :r],
            threshold=5e-2,
        )
        large_energy_convergence.append(energy_est_kqd)
        print(
            f"Krylov ground state energy (dim={r}, retained={retained_est}): ",
            energy_est_kqd,
        )

plot_energy_convergence(
    large_energy_convergence, large_exact_gnd, large_krylov_dim
)
Output:
Backend: ibm_boston
System qubits: 30
Total circuit qubits: 156
Krylov dimension: 7
Time step: 0.036110
Shift tau: 25.0
ISA circuit depth: 219
ISA two-qubit gates: 728
ISA two-qubit depth: 52
Job IDs by d: {1: 'd9fl4p4jeosc73fk4dg0', 2: 'd9fl4pineu4c739poecg', 3: 'd9fl4q2neu4c739poedg', 4: 'd9fl4qhhtsac739fjgn0', 5: 'd9fl4r4jeosc73fk4dhg', 6: 'd9fl4rkjeosc73fk4dj0'}
Estimated first row of S:
[ 1.     +0.j       0.42055-0.65466j -0.17883-0.73125j -0.64523-0.31601j
 -0.70781+0.55574j -0.02467+0.70525j  0.59301+0.55602j]
Estimated first row of H:
[ 25.      +0.j       10.3419 -16.5586j   -5.017  -18.03933j
 -16.44797 -6.98173j -17.17081+14.84502j   0.62722+17.81196j
  15.68886+12.74875j]
exact ground state energy:   21.021912418526902
Krylov ground state energy (dim=1, retained=1):  25.0
Krylov ground state energy (dim=2, retained=2):  24.432409110686205
Krylov ground state energy (dim=3, retained=3):  24.256856893278556
Krylov ground state energy (dim=4, retained=4):  23.727409826799715
Krylov ground state energy (dim=5, retained=4):  23.324720470780864
Krylov ground state energy (dim=6, retained=5):  21.91957579005085
Krylov ground state energy (dim=7, retained=5):  21.548331214122644

Apéndice: El enfoque de la función hamiltoniana (filtro espectral)
El flujo de trabajo principal presentaba el método KQD desde un punto de vista operativo: construir una base de Krylov a partir de estados evolucionados en tiempo real, estimar las matrices proyectadas y , y resolver el GEVP. En este apéndice se vuelve a analizar el mismo cálculo desde un punto de vista complementario que explica por qué funciona la KQD: el punto de vista de la función hamiltoniana, o filtro espectral [3], [5]. Reutiliza el modelo de 12 qubits, el paso de tiempo y la solución de Krylov ya obtenida anteriormente; no es necesaria ninguna nueva ejecución del circuito.
El estado de referencia como distribución de energía
Supongamos que el hamiltoniano tiene la descomposición en valores propios
con estados propios de energía . Cualquier estado de referencia puede desarrollarse en esta base propia,
por lo que tiene un peso espectral en cada energía . La energía de referencia es la media de esta distribución, .
La descomposición en eigenvalores de un hamiltoniano general de -qubits tiene un coste exponencial, por lo que esta representación es meramente diagnóstica y no forma parte del algoritmo. En este caso, sin embargo, podemos calcularlo de forma sencilla para el mismo problema de « »: el hamiltoniano de Heisenberg conserva el número total de excitaciones, y la referencia tiene una sola excitación, por lo que todo su contenido espectral se encuentra en el subespacio de una sola excitación, cuya dimensión crece solo linealmente con . Por lo tanto, reutilizamos el bloque exacto de una sola excitación (ya utilizado anteriormente como referencia) y leemos la distribución de referencia dentro de ese subespacio.
# Exact single-excitation-subspace decomposition of the reference state.
# This reuses make_heisenberg_hamiltonian / _basis_state_transition_amplitude_sparse
# and the n=12 `hamiltonian` and `ref_bitstring` defined in the small-scale example.
single_excitation_states = [1 << k for k in range(num_qubits)]

h_single = np.array(
    [
        [
            _basis_state_transition_amplitude_sparse(hamiltonian, bra, ket)
            for ket in single_excitation_states
        ]
        for bra in single_excitation_states
    ]
)
h_single = 0.5 * (h_single + h_single.conj().T)

subspace_evals, subspace_evecs = la.eigh(h_single)
subspace_evals = np.real(subspace_evals)

# Reference-state coordinates inside the single-excitation subspace.
ref_position = single_excitation_states.index(int(ref_bitstring, 2))
ref_in_subspace = np.zeros(num_qubits, dtype=complex)
ref_in_subspace[ref_position] = 1.0

# Amplitudes and spectral weights of the reference in the energy eigenbasis.
ref_eigen_amplitudes = subspace_evecs.conj().T @ ref_in_subspace
ref_spectral_weights = np.abs(ref_eigen_amplitudes) ** 2

print(f"Single-excitation subspace dimension: {num_qubits}")
print(f"Subspace ground-state energy:         {subspace_evals[0]:.6f}")
print(
    f"Reference energy (sum p_m E_m):       {np.sum(ref_spectral_weights * subspace_evals):.6f}"
)
print(f"Reference weight on subspace ground:  {ref_spectral_weights[0]:.6f}")
Output:
Single-excitation subspace dimension: 12
Subspace ground-state energy:         3.136297
Reference energy (sum p_m E_m):       7.000000
Reference weight on subspace ground:  0.163827
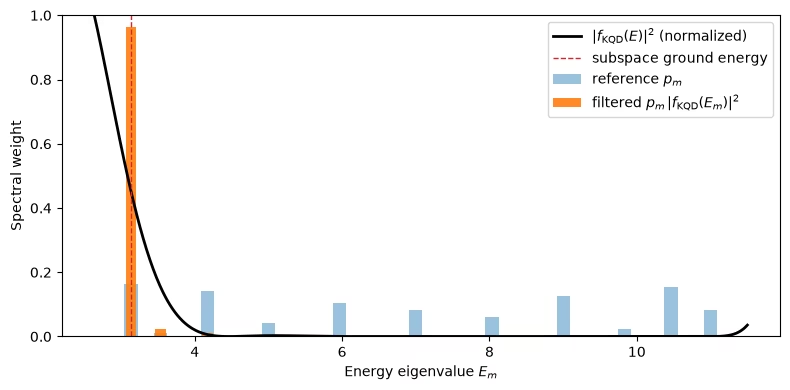
KQD aprende un filtro que modifica esta distribución
Una función hamiltoniana se define mediante el cálculo espectral,
o, dicho de otro modo, una suma ponderada de proyectores propios. Al aplicarlo a la referencia, se modifica la forma de cada amplitud espectral, :
Si presentara un pico pronunciado en la energía más baja (en caso contrario, y ), entonces actuaría como un proyector del estado fundamental, y el resultado normalizado sería (casi) el estado fundamental. Por lo tanto, lo que necesitamos es precisamente un buen filtro espectral de paso bajo en energía.
La KQD no establece de antemano un « ». En cambio, expande el filtro en la base de evolución en tiempo real,
una función trigonométrica de la energía cuyos coeficientes son precisamente el vector propio de GEVP resuelto anteriormente. Por lo tanto, minimizar el cociente de Rayleigh equivale a aprender el filtro que mejor suprime el peso del estado excitado de la referencia. Una dimensión de Krylov mayor proporciona al filtro más grados de libertad y un pico más pronunciado en la energía del estado fundamental.
La función auxiliar que se muestra a continuación evalúa este filtro aprendido en un eje de energía; a continuación, lo aplicamos a la distribución de referencia obtenida anteriormente.
def trigonometric_krylov_filter(
    coeffs: np.ndarray,
    energies: np.ndarray,
    time_step: float,
) -> np.ndarray:
    """Evaluate the learned Krylov filter f(E) = sum_l c_l exp(-i l dt E)."""
    values = np.zeros_like(energies, dtype=complex)
    for ell, coeff in enumerate(coeffs):
        values += coeff * np.exp(-1j * ell * time_step * energies)
    return values


def filtered_spectral_weights(
    weights: np.ndarray,
    filter_values: np.ndarray,
) -> np.ndarray:
    """Reshape spectral weights by |f(E)|^2 and renormalize."""
    reshaped = weights * np.abs(filter_values) ** 2
    return reshaped / np.sum(reshaped)


# Recover the KQD coefficients from the already-estimated projected matrices.
# The shift only moves H by tau * S, so it does not change the GEVP eigenvector;
# we solve at the full Krylov dimension used in the small-scale example.
_, kqd_coeffs, _ = solve_thresholded_gevp(
    h_matrix_est,
    s_matrix_est,
    threshold=1e-12,
)

filter_on_spectrum = trigonometric_krylov_filter(
    kqd_coeffs, subspace_evals, dt
)
filtered_weights = filtered_spectral_weights(
    ref_spectral_weights, filter_on_spectrum
)

print(f"Ground-state overlap  (reference): {ref_spectral_weights[0]:.4f}")
print(f"Ground-state overlap  (filtered):  {filtered_weights[0]:.4f}")
print(
    f"Mean energy           (reference): {np.sum(ref_spectral_weights * subspace_evals):.6f}"
)
print(
    f"Mean energy           (filtered):  {np.sum(filtered_weights * subspace_evals):.6f}"
)
Output:
Ground-state overlap  (reference): 0.1638
Ground-state overlap  (filtered):  0.9638
Mean energy           (reference): 7.000000
Mean energy           (filtered):  3.164503
Visualiza el filtro y su flexibilidad
En primer lugar, mostramos el filtro aprendido en la dimensión completa de Krylov utilizada anteriormente; a continuación, observamos cómo se vuelve más preciso a medida que aumenta la dimensión .
Las barras muestran los pesos espectrales de referencia (antes) y los pesos filtrados (después), junto con la intensidad del filtro aprendido en un eje de energía continuo. El filtro concentra el peso en la energía más baja del subespacio de excitación única —la misma energía a la que convergió la estimación de KQD en el ejemplo a pequeña escala—. Hay que tener en cuenta que se trata del estado fundamental dentro del sector de excitación única, que es el objetivo relevante para este estado de referencia que conserva la excitación, y no del estado fundamental global.
fig, ax = plt.subplots(figsize=(8, 4))

visible = (ref_spectral_weights > 1e-4) | (filtered_weights > 1e-4)
ax.bar(
    subspace_evals[visible],
    ref_spectral_weights[visible],
    width=0.18,
    alpha=0.45,
    label="reference $p_m$",
)
ax.bar(
    subspace_evals[visible],
    filtered_weights[visible],
    width=0.14,
    alpha=0.9,
    label=r"filtered $p_m\,|f_{\rm KQD}(E_m)|^2$",
)

energy_grid = np.linspace(
    subspace_evals.min() - 0.5, subspace_evals.max() + 0.5, 800
)
filter_intensity = (
    np.abs(trigonometric_krylov_filter(kqd_coeffs, energy_grid, dt)) ** 2
)
filter_intensity /= filter_intensity.max()
ax.plot(
    energy_grid,
    filter_intensity,
    color="k",
    linewidth=2,
    label=r"$|f_{\rm KQD}(E)|^2$ (normalized)",
)

ax.axvline(
    subspace_evals[0],
    color="C3",
    linestyle="--",
    linewidth=1,
    label="subspace ground energy",
)
ax.set_xlabel("Energy eigenvalue $E_m$")
ax.set_ylabel("Spectral weight")
ax.set_ylim(0, 1)
ax.legend(loc="upper right")
plt.tight_layout()
plt.show()
Output:
Aumento de la dimensión de Krylov: flexibilidad de la función aprendida
Recordemos que el filtro aprendido es un polinomio trigonométrico en la energía con coeficientes de tipo « »,
La dimensión de Krylov es exactamente el número de coeficientes libres, por lo que determina la flexibilidad de la función. Un « » pequeño solo puede producir un filtro amplio y con variaciones suaves que deja pasar peso hacia los estados excitados de menor energía; cuando aumenta el « », el filtro puede formar un pico más estrecho en la energía objetivo y suprimir el peso restante de los estados excitados de forma más agresiva. Esta es la contrapartida, en términos de filtro espectral, de la convergencia energética observada en el ejemplo a pequeña escala: a medida que crece , la distribución filtrada se reduce al estado fundamental del subespacio y la energía estimada disminuye hasta alcanzar dicho estado.
Reutilizamos las matrices proyectadas que ya se han estimado anteriormente y nos limitamos a resolver el GEVP en cada bloque principal ; a continuación, evaluamos y representamos gráficamente el filtro correspondiente.
# Sweep the Krylov dimension using the leading r x r blocks of the estimated matrices.
sweep_dims = [r for r in (2, 4, 6, 8, krylov_dim) if r <= krylov_dim]
sweep_dims = sorted(set(sweep_dims))

energy_grid = np.linspace(
    subspace_evals.min() - 0.5, subspace_evals.max() + 0.5, 800
)

sweep_cases = []
print(" r    retained    ground overlap    filtered energy")
print("--    --------    --------------    ---------------")
for r in sweep_dims:
    _, coeffs_r, retained_r = solve_thresholded_gevp(
        h_matrix_est[:r, :r],
        s_matrix_est[:r, :r],
        threshold=1e-12,
    )
    filter_on_spectrum_r = trigonometric_krylov_filter(
        coeffs_r, subspace_evals, dt
    )
    filtered_weights_r = filtered_spectral_weights(
        ref_spectral_weights, filter_on_spectrum_r
    )
    filtered_energy_r = float(np.sum(filtered_weights_r * subspace_evals))

    sweep_cases.append((r, coeffs_r, filtered_weights_r))
    print(
        f"{r:2d}    {retained_r:8d}    {filtered_weights_r[0]:14.4f}    {filtered_energy_r:15.6f}"
    )

print(f"\nSubspace ground-state energy (target): {subspace_evals[0]:.6f}")

# One panel per Krylov dimension: filtered spectrum (bars) + filter intensity (curve).
fig, axes = plt.subplots(
    len(sweep_cases),
    1,
    figsize=(8, 2.1 * len(sweep_cases)),
    sharex=True,
)
axes = np.atleast_1d(axes)

for idx, (ax, (r, coeffs_r, filtered_weights_r)) in enumerate(
    zip(axes, sweep_cases)
):
    visible = (ref_spectral_weights > 1e-4) | (filtered_weights_r > 1e-4)
    ax.bar(
        subspace_evals[visible],
        ref_spectral_weights[visible],
        width=0.18,
        alpha=0.35,
        color="C0",
        label="reference $p_m$" if idx == 0 else None,
    )
    ax.bar(
        subspace_evals[visible],
        filtered_weights_r[visible],
        width=0.14,
        alpha=0.9,
        color="C1",
        label="filtered weights" if idx == 0 else None,
    )

    filter_intensity_r = (
        np.abs(trigonometric_krylov_filter(coeffs_r, energy_grid, dt)) ** 2
    )
    filter_intensity_r /= filter_intensity_r.max()
    ax.plot(energy_grid, filter_intensity_r, color="k", linewidth=2)

    ax.axvline(subspace_evals[0], color="C3", linestyle="--", linewidth=1)
    ax.set_ylim(0, 1)
    ax.set_ylabel("weight")
    ax.legend(loc="upper right", title=f"$r={r}$")

axes[-1].set_xlabel("Energy eigenvalue $E_m$")
fig.suptitle(
    r"KQD-learned filter $|f_{\rm KQD}(E)|^2$ sharpening with Krylov dimension $r$",
    y=1.0,
)
fig.tight_layout()
plt.show()
Output:
 r    retained    ground overlap    filtered energy
--    --------    --------------    ---------------
 2           2            0.4549           4.184510
 4           4            0.8373           3.310168
 6           6            0.9706           3.158100
 8           7            0.9701           3.158725
10           8            0.9638           3.164503

Subspace ground-state energy (target): 3.136297

Próximos pasos
Si este trabajo te ha parecido interesante, quizá te interese el siguiente material:
Referencias
[1] E. N. Epperly, L. Lin y Y. Nakatsukasa, «Una teoría de la diagonalización de subespacios cuánticos», SIAM Journal on Matrix Analysis and Applications 43, 1263-1290 (2022).
[2] N. Yoshioka, M., Amico, W., Kirby, et al., Diagonalización de hamiltonianos de muchos cuerpos de gran tamaño en un procesador cuántico, arXiv:2407.14431 (2024).
[3] R. M. Parrish y P. L. McMahon, «Diagonalización de filtros cuánticos: descomposición en valores propios cuánticos sin estimación completa de la fase cuántica», Physical Review Letters 122, 230401 (2019).
[4] G. Lee, S. Choi, J. Huh y AF Izmaylov, Estrategias eficientes para reducir el error de muestreo en la diagonalización del subespacio de Krylov cuántico, Digital Discovery 4, 954-969 (2025).
[5] G. Lee, M. Kang, J. Hong, S. Fomichev y J. Vaya, «Estimación de fase cuántica filtrada», arXiv:2510.04294 (2025).