Algoritmo cuántico de optimización aproximada
Estimación de uso: 22 minutos en un procesador Heron r3 (NOTA: Esto es sólo una estimación. Su tiempo de ejecución puede variar)
Resultados del aprendizaje
- Cómo mapear un problema clásico de optimización combinatoria (corte máximo) a un hamiltoniano cuántico
- Cómo implementar y ejecutar el algoritmo de optimización cuántica aproximada (QAOA) mediante sesiones del servicio de cómputo « IBM Quantum »
- Cómo ampliar un flujo de trabajo QAOA desde un ejemplo de simulador a pequeña escala hasta la ejecución en hardware a escala industrial
Requisitos previos
- Conceptos básicos de los circuitos cuánticos
- Algoritmos variacionales
- QAOA en profundidad : un análisis exhaustivo del algoritmo QAOA y su aplicación a gran escala
En segundo plano
El algoritmo de optimización cuántica aproximada (QAOA) es un método iterativo híbrido cuántico-clásico para resolver problemas de optimización combinatoria. En este tutorial, utilizarás QAOA para resolver el problema del corte máximo (max-cut), un problema de optimización NP-difícil con aplicaciones en la agrupación de datos, la ciencia de redes y la física estadística. Dado un grafo formado por nodos conectados por aristas, el objetivo es dividir los nodos en dos conjuntos de tal manera que se maximice el número de aristas que cruzan la división.
La optimización combinatoria también se aplica a retos relacionados con la sostenibilidad, como la planificación de rutas de reparto para reducir el consumo de combustible y la asignación de recursos para limitar el desperdicio de materiales. El ejemplo «max-cut» presenta el proceso de expresar un objetivo como un hamiltoniano de coste y explorar posibles soluciones con QAOA. Aplicar este enfoque a un problema de sostenibilidad requiere un objetivo y unas restricciones que reflejen la aplicación prevista.

De la optimización clásica a los circuitos cuánticos
Max-cut puede plantearse como un problema clásico de optimización binaria. A cada nodo se le asigna una variable binaria que indica a qué conjunto pertenece. El objetivo es maximizar el número de aristas cuyos extremos pertenezcan a conjuntos diferentes:
Esto equivale a un problema de optimización binaria cuadrática sin restricciones (QUBO) de la forma . Mediante una sustitución de variables estándar ( ), el QUBO puede reescribirse como un hamiltoniano de coste cuyo estado fundamental codifica la solución óptima. En general, este hamiltoniano contiene tanto términos cuadráticos como lineales:
En este tutorial, no realizarás esta sustitución a mano. El complemento Optimization Mapper de Qiskit (qiskit-addon-opt-mapper) proporciona una clase de aplicación Maxcut que modela el problema directamente a partir de un grafo, un convertidor que transforma el modelo en un QUBO y un traductor que mapea el QUBO a . Para el problema del corte máximo no ponderado que se considera aquí, los coeficientes lineales se anulan ( ) y cada arista aporta un término , junto con un desplazamiento constante que relaciona con el valor del corte. El mismo proceso gestiona grafos ponderados y otros problemas expresables mediante QUBO sin modificar el resto del flujo de trabajo.
Cómo funciona QAOA
QAOA prepara soluciones candidatas aplicando capas alternas de dos operadores a un estado de superposición inicial : el operador de coste y un operador mezclador . Los ángulos y se optimizan en un bucle de retroalimentación clásico; el ordenador cuántico evalúa la función de coste y un optimizador clásico actualiza los parámetros hasta alcanzar la convergencia. Este bucle iterativo se ejecuta dentro de una sesión de Quantum Compute, lo que mantiene el dispositivo cuántico reservado durante todas las iteraciones para reducir la latencia.

Para un análisis más detallado de la teoría de la QAOA, incluida la derivación completa del QUBO al hamiltoniano, consulte el módulo del curso sobre QAOA.
En este tutorial, primero resolverás el problema del corte máximo en un pequeño grafo de cinco nodos y, a continuación, ampliarás ese mismo flujo de trabajo a un problema a escala industrial de 100 nodos en hardware real. Nota sobre el acceso al plan: Este tutorial utiliza sesiones de Quantum Compute, que solo están disponibles en el plan Premium. Si estás en el plan Open, no podrás ejecutar este tutorial tal y como está escrito; en su lugar, tendrás que cambiar Session a modo de trabajo (es decir, enviar cada iteración como un trabajo independiente en lugar de envolver el bucle de optimización con Session(...)). El flujo de trabajo sigue ejecutándose, pero en cada iteración se incurre en toda la latencia de la cola, en lugar de reutilizar un dispositivo reservado. Consulta la «Descripción general de los planes disponibles» para obtener más información.
Requisitos
Antes de empezar este tutorial, asegúrate de tener instalado lo siguiente:
- Qiskit SDK v2.0 o posterior, con soporte para visualización
- Qiskit Runtime v0.22 o posterior (
pip install qiskit-ibm-runtime) - Complemento «Optimization Mapper» para Qiskit (
pip install qiskit-addon-opt-mapper)
Además, necesitarás tener acceso a una instancia en IBM Quantum® Platform.
Configuración
import matplotlib.pyplot as plt
import rustworkx as rx
from rustworkx.visualization import mpl_draw as draw_graph
import numpy as np
from scipy.optimize import minimize
from collections import defaultdict


from qiskit.quantum_info import SparsePauliOp
from qiskit.circuit.library import QAOAAnsatz
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import Session, EstimatorV2 as Estimator
from qiskit_ibm_runtime import SamplerV2 as Sampler

from qiskit_addon_opt_mapper.applications import Maxcut
from qiskit_addon_opt_mapper.converters import OptimizationProblemToQubo
from qiskit_addon_opt_mapper.translators import to_ising
Ejemplo a pequeña escala
En esta sección se describe paso a paso el flujo de trabajo de QAOA utilizando una pequeña instancia de max-cut de cinco nodos. A pesar de la etiqueta de «pequeña escala», este ejemplo se ejecuta en un hardware real de IBM Quantum : el código selecciona un backend con 127 o más qubits y ejecuta el circuito en él.
Inicialice su problema creando un grafo con nodos.
n_small = 5

graph = rx.PyGraph()
graph.add_nodes_from(np.arange(0, n_small, 1))
edge_list = [
    (0, 1, 1.0),
    (0, 2, 1.0),
    (0, 4, 1.0),
    (1, 2, 1.0),
    (2, 3, 1.0),
    (3, 4, 1.0),
]
graph.add_edges_from(edge_list)
draw_graph(graph, node_size=600, with_labels=True)
Output:

Paso 1: Asignar entradas clásicas a un problema cuántico
Representa el grafo clásico en circuitos y operadores cuánticos. Tal y como se describe en la sección «Antecedentes», el problema «max-cut» es un problema QUBO cuyo hamiltoniano de coste tiene un estado fundamental que codifica el corte óptimo, y el método QAOA utiliza un circuito de ansatz parametrizado para preparar estados fundamentales candidatos de . Utiliza el complemento «Optimization Mapper» para pasar del grafo a en tres pasos: modelar el problema, convertirlo en un QUBO y traducir el QUBO a un hamiltoniano de Ising.
Plantear el problema
La clase de aplicación Maxcut acepta directamente el grafo de rustworkx y devuelve un objeto OptimizationProblem cuyo objetivo es el valor del corte que se debe maximizar. Cada arista aporta al objetivo, exactamente igual que en la sección «Antecedentes ».
maxcut = Maxcut(graph)
maxcut_problem = maxcut.to_optimization_problem()
print(maxcut_problem.prettyprint())
Output:
Problem name: Max-cut

Maximize
  -2*x_0*x_1 - 2*x_0*x_2 - 2*x_0*x_4 - 2*x_1*x_2 - 2*x_2*x_3 - 2*x_3*x_4 + 3*x_0
  + 2*x_1 + 3*x_2 + 2*x_3 + 2*x_4

Subject to
  No constraints

  Binary variables (5)
    x_0 x_1 x_2 x_3 x_4
Calcular el hamiltoniano de costes
Convierte el problema en un QUBO con OptimizationProblemToQubo, y a continuación transforma el QUBO en un hamiltoniano de Ising con to_ising. El convertidor transforma la maximización en una minimización del valor de corte negado, y el traductor aplica la sustitución . Devuelve como un SparsePauliOp junto con un escalar tal offset que . Dado que el QUBO minimiza el valor de corte negado, el valor de corte de cualquier cadena de bits es .
qubo = OptimizationProblemToQubo().convert(maxcut_problem)
cost_hamiltonian, offset = to_ising(qubo)
print("Cost Function Hamiltonian:", cost_hamiltonian)
print("Offset:", offset)
Output:
Cost Function Hamiltonian: SparsePauliOp(['IIIZZ', 'IIZIZ', 'ZIIIZ', 'IIZZI', 'IZZII', 'ZZIII'],
              coeffs=[0.5+0.j, 0.5+0.j, 0.5+0.j, 0.5+0.j, 0.5+0.j, 0.5+0.j])
Offset: -3.0
Construir el circuito del modelo QAOA
Utiliza QAOAAnsatz para construir el circuito QAOA parametrizado a partir del hamiltoniano de coste. Aquí utilizamos reps=2 (dos capas QAOA, cuatro parámetros: ).
circuit = QAOAAnsatz(cost_operator=cost_hamiltonian, reps=2)
circuit.measure_all()

circuit.draw("mpl")
Output:

circuit.parametersOutput:
ParameterView([ParameterVectorElement(β[0]), ParameterVectorElement(β[1]), ParameterVectorElement(γ[0]), ParameterVectorElement(γ[1])])
Paso 2: Optimizar el problema para la ejecución en hardware cuántico
Convertir el circuito abstracto en instrucciones nativas del hardware. Este paso se encarga de la asignación de qubits, la descomposición de puertas, el enrutamiento y la supresión de errores. Consulta la documentación sobre la transpilación para obtener más información.
service = QiskitRuntimeService()
backend = service.least_busy(
    operational=True, simulator=False, min_num_qubits=127
)
print(backend)

# Create pass manager for transpilation. Level 3 is the most aggressive
# preset: slower to transpile, but produces shorter circuits that are
# more robust to hardware noise.
pm = generate_preset_pass_manager(optimization_level=3, backend=backend)

candidate_circuit = pm.run(circuit)
candidate_circuit.draw("mpl", fold=False, idle_wires=False)
Output:
<IBMBackend('ibm_pittsburgh')>

Paso 3: Ejecutar utilizando Qiskit primitives
El bucle de optimización de QAOA se ejecuta dentro de una sesión de Quantum Compute para mantener el dispositivo reservado a lo largo de todas las iteraciones. Un estimador evalúa en cada paso, y un optimizador clásico (COBYLA) actualiza los parámetros hasta alcanzar la convergencia.
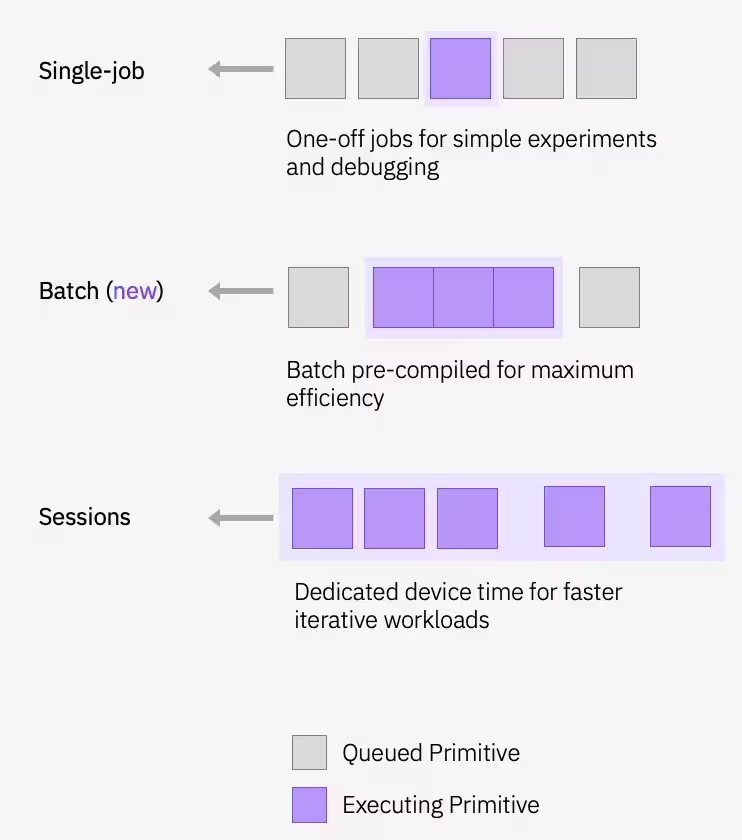
Define los parámetros iniciales y ejecuta el ciclo de optimización:
# QAOA doesn't prescribe principled default angles — any bounded choice
# works as a warm start for problems this small. beta and gamma are
# periodic (beta in [0, pi] and gamma in [0, 2*pi] modulo the underlying
# Pauli-rotation periods), and pi/2 and pi are just midpoints of those
# ranges. For harder problems you would typically warm start from known
# good angles or transfer parameters from smaller instances.
initial_gamma = np.pi
initial_beta = np.pi / 2
init_params = [initial_beta, initial_beta, initial_gamma, initial_gamma]
def cost_func_estimator(params, ansatz, hamiltonian, estimator):
# transform the observable defined on virtual qubits to
# an observable defined on all physical qubits
isa_hamiltonian = hamiltonian.apply_layout(ansatz.layout)
pub = (ansatz, isa_hamiltonian, params)
job = estimator.run([pub])
results = job.result()[0]
cost = results.data.evs
objective_func_vals.append(cost)
return costobjective_func_vals = [] # Global variable
with Session(backend=backend) as session:
# If using qiskit-ibm-runtime<0.24.0, change `mode=` to `session=`
estimator = Estimator(mode=session)
estimator.options.default_shots = 1000
# Set simple error suppression/mitigation options
estimator.options.dynamical_decoupling.enable = True
estimator.options.dynamical_decoupling.sequence_type = "XY4"
estimator.options.twirling.enable_gates = True
estimator.options.twirling.num_randomizations = "auto"
estimator.options.environment.job_tags = ["TUT_QAOA"]
result = minimize(
cost_func_estimator,
init_params,
args=(candidate_circuit, cost_hamiltonian, estimator),
method="COBYLA",
tol=1e-2,
)
print(result)Output:
 message: Return from COBYLA because the trust region radius reaches its lower bound.
 success: True
  status: 0
     fun: -1.0164225323839062
       x: [ 1.404e+00  1.174e+00  4.036e+00  2.969e+00]
    nfev: 30
   maxcv: 0.0
El optimizador consiguió reducir el coste y encontrar mejores parámetros para el circuito.
Una curva que desciende suavemente y luego se estabiliza es el indicio de la convergencia. Una curva ruidosa y no monótona suele indicar que hay algún problema en las etapas anteriores que requiere atención; las causas más comunes son un número insuficiente de iteraciones por evaluación (alta varianza del estimador), parámetros iniciales inadecuados o un circuito cuya profundidad está dominada por el ruido del hardware. COBYLA no utiliza derivadas y es bastante resistente al ruido moderado, pero cuando el ruido supera las mejoras reales en el coste por paso, su modelo de aproximación lineal ya no puede distinguir el descenso real de las fluctuaciones aleatorias y el optimizador se desvía.
plt.figure(figsize=(12, 6))
plt.plot(objective_func_vals)
plt.xlabel("Iteration")
plt.ylabel("Cost")
plt.show()
Output:

Asigna los parámetros optimizados y genera una muestra de la distribución final utilizando la primitiva «Sampler».
optimized_circuit = candidate_circuit.assign_parameters(result.x)
optimized_circuit.draw("mpl", fold=False, idle_wires=False)
Output:

# If using qiskit-ibm-runtime<0.24.0, change `mode=` to `backend=`
sampler = Sampler(mode=backend)
sampler.options.default_shots = 10000

# Set simple error suppression/mitigation options
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = "XY4"
sampler.options.twirling.enable_gates = True
sampler.options.twirling.num_randomizations = "auto"

sampler.options.environment.job_tags = ["TUT_QAOA"]

pub = (optimized_circuit,)
job = sampler.run([pub], shots=int(1e4))
counts_int = job.result()[0].data.meas.get_int_counts()
counts_bin = job.result()[0].data.meas.get_counts()
shots = sum(counts_int.values())
final_distribution_int = {key: val / shots for key, val in counts_int.items()}
final_distribution_bin = {key: val / shots for key, val in counts_bin.items()}
print(final_distribution_int)
Output:
{22: 0.1003, 15: 0.008, 9: 0.0934, 4: 0.02, 31: 0.004, 17: 0.0288, 18: 0.0327, 14: 0.0305, 10: 0.0358, 28: 0.0128, 5: 0.0868, 20: 0.09, 11: 0.0908, 13: 0.0321, 19: 0.0298, 27: 0.0186, 8: 0.0077, 30: 0.0211, 23: 0.0098, 26: 0.0839, 12: 0.0254, 21: 0.0315, 16: 0.0082, 25: 0.01, 6: 0.0131, 1: 0.0205, 2: 0.0145, 29: 0.0137, 7: 0.0059, 3: 0.0101, 24: 0.0078, 0: 0.0024}
Paso 4: Procesamiento posterior y devolución del resultado en el formato clásico deseado
Extrae la cadena de bits más probable de la distribución muestreada. Este es el mejor corte encontrado por la QAOA. El interpret método de la clase Maxcut descodifica la cadena de bits en los dos conjuntos de nodos de la partición.
# auxiliary functions to sample most likely bitstring
def to_bitstring(integer, num_bits):
    result = np.binary_repr(integer, width=num_bits)
    return [int(digit) for digit in result]


keys = list(final_distribution_int.keys())
values = list(final_distribution_int.values())
most_likely = keys[np.argmax(np.abs(values))]
most_likely_bitstring = to_bitstring(most_likely, len(graph))
most_likely_bitstring.reverse()

print("Result bitstring:", most_likely_bitstring)

partition = maxcut.interpret(np.array(most_likely_bitstring))
print("Partition:", partition)
Output:
Result bitstring: [0, 1, 1, 0, 1]
Partition: [[0, 3], [1, 2, 4]]
plt.rcParams.update({"font.size": 10})
final_bits = final_distribution_bin
values = np.abs(list(final_bits.values()))
top_4_values = sorted(values, reverse=True)[:4]
positions = []
for value in top_4_values:
    positions.append(np.where(values == value)[0])
fig = plt.figure(figsize=(11, 6))
ax = fig.add_subplot(1, 1, 1)
plt.xticks(rotation=45)
plt.title("Result Distribution")
plt.xlabel("Bitstrings (reversed)")
plt.ylabel("Probability")
ax.bar(list(final_bits.keys()), list(final_bits.values()), color="tab:grey")
for p in positions:
    ax.get_children()[int(p[0])].set_color("tab:purple")
plt.show()
Output:

Visualizar el mejor corte
A partir de la cadena de bits óptima, puedes visualizar este corte en el gráfico original.
# auxiliary function to plot graphs
def plot_result(G, x):
    colors = ["tab:grey" if i == 0 else "tab:purple" for i in x]
    pos, _default_axes = rx.spring_layout(G), plt.axes(frameon=True)
    rx.visualization.mpl_draw(
        G, node_color=colors, node_size=100, alpha=0.8, pos=pos
    )


plot_result(graph, most_likely_bitstring)
Output:

Ahora, calcula el valor del corte. El objetivo de la función es OptimizationProblem el propio valor de corte, por lo que hay que evaluarlo directamente sobre la cadena de bits. También puedes compararlo con el valor de corte que se deduce del coste final del optimizador, , que es una media calculada sobre toda la distribución muestreada, en lugar del valor de una sola cadena de bits.
cut_value = maxcut_problem.objective.evaluate(np.array(most_likely_bitstring))
print("The value of the cut is:", cut_value)
print("Cut value implied by the optimized cost:", -(result.fun + offset))
Output:
The value of the cut is: 5.0
Cut value implied by the optimized cost: 4.016422532383906
En un grafo tan pequeño, es fácil hallar el óptimo verdadero mediante un método de fuerza bruta, por lo que puedes verificar los resultados comparando el resultado del algoritmo QAOA con la respuesta exacta.
# Classical baseline: enumerate all 2**n_small bitstrings and take the best cut.
def brute_force_max_cut(problem) -> tuple[int, list[int]]:
    n = problem.get_num_vars()
    best_cut = -1
    best_x: list[int] = []
    for i in range(2**n):
        x = np.array([(i >> k) & 1 for k in range(n)])
        cut = problem.objective.evaluate(x)
        if cut > best_cut:
            best_cut = int(cut)
            best_x = x.tolist()
    return best_cut, best_x


classical_best, classical_x = brute_force_max_cut(maxcut_problem)
print(f"Classical optimum (brute force): {classical_best}")
print(f"QAOA cut value:                  {cut_value}")
Output:
Classical optimum (brute force): 5
QAOA cut value:                  5.0
Ejemplo de hardware a gran escala
En IBM Quantum Platform tienes acceso a numerosos dispositivos con más de 100 qubits. Elige uno en el que resolver el problema del corte máximo en un grafo ponderado de 100 nodos. Se trata de un problema a «escala industrial». El flujo de trabajo sigue los mismos pasos que los anteriores, pero aplicados a un gráfico mucho más grande.
Flujo de trabajo integral a escala industrial
A continuación se muestran los cuatro pasos, aplicados al gráfico de 100 nodos. La estructura es la misma que la del ejemplo a pequeña escala: mapa, transpilación, ejecución y posprocesamiento, pero con un problema más complejo y dividido entre las cuatro celdas siguientes para mayor claridad.
# Precomputed parity lookup table: _PARITY[b] = +1 if popcount(b) is even, else -1.
# We use this to vectorize expectation-value evaluation across all Pauli terms.
_PARITY = np.array(
    [-1 if bin(i).count("1") % 2 else 1 for i in range(256)],
    dtype=np.complex128,
)


def evaluate_sparse_pauli(state: int, observable: SparsePauliOp) -> complex:
    """Expectation value of a SparsePauliOp on a single computational-basis state.

    For a Z-only observable (which QAOA cost Hamiltonians are, after the
    QUBO-to-Hamiltonian mapping), the eigenvalue of each Pauli term on a
    computational-basis state is simply (-1)**popcount(z_mask AND state),
    i.e., the parity of the bitwise-AND of the term's Z-support and the
    measured bitstring.

    This routine packs the Z-support of every Pauli term into bytes, ANDs
    them against the measured state in a single vectorized op, and looks up
    the parity in _PARITY. For a 100-qubit / ~hundreds-of-terms Hamiltonian
    over 10_000 samples, this is dramatically faster than calling
    SparsePauliOp.expectation_value per sample.
    """
    packed_uint8 = np.packbits(observable.paulis.z, axis=1, bitorder="little")
    state_bytes = np.frombuffer(
        state.to_bytes(packed_uint8.shape[1], "little"), dtype=np.uint8
    )
    reduced = np.bitwise_xor.reduce(packed_uint8 & state_bytes, axis=1)
    return np.sum(observable.coeffs * _PARITY[reduced])


def best_solution(samples, hamiltonian):
    """Return the sampled bitstring (as int) with the lowest Hamiltonian cost."""
    min_cost = float("inf")
    min_sol = None
    for bit_str in samples.keys():
        candidate_sol = int(bit_str)
        fval = evaluate_sparse_pauli(candidate_sol, hamiltonian).real
        if fval <= min_cost:
            min_cost = fval
            min_sol = candidate_sol
    return min_sol


def _plot_cdf(objective_values: dict, ax, color):
    x_vals = sorted(objective_values.keys(), reverse=True)
    y_vals = np.cumsum([objective_values[x] for x in x_vals])
    ax.plot(x_vals, y_vals, color=color)


def plot_cdf(dist, ax, title):
    _plot_cdf(dist, ax, "C1")
    ax.vlines(min(list(dist.keys())), 0, 1, "C1", linestyle="--")
    ax.set_title(title)
    ax.set_xlabel("Objective function value")
    ax.set_ylabel("Cumulative distribution function")
    ax.grid(alpha=0.3)


def samples_to_objective_values(samples, hamiltonian):
    """Convert the samples to values of the objective function."""
    objective_values = defaultdict(float)
    for bit_str, prob in samples.items():
        candidate_sol = int(bit_str)
        fval = evaluate_sparse_pauli(candidate_sol, hamiltonian).real
        objective_values[fval] += prob
    return objective_values
Paso 1 : Genera el gráfico a partir del mapa de acoplamiento del backend; a continuación, asócialo al hamiltoniano de coste con el complemento «Optimization Mapper» y genera el ansatz.
# Step 1: build the 100-node graph, cost Hamiltonian, and QAOA ansatz.
n_large = 100
graph_100 = rx.PyGraph()
graph_100.add_nodes_from(np.arange(0, n_large, 1))
elist = set()
for u, v in backend.coupling_map:
    # The coupling map lists both directions of each coupler, so sort
    # the endpoints to avoid adding the same edge twice.
    if u < n_large and v < n_large:
        elist.add((min(u, v), max(u, v), 1.0))
graph_100.add_edges_from(sorted(elist))

maxcut_100 = Maxcut(graph_100)
maxcut_problem_100 = maxcut_100.to_optimization_problem()
qubo_100 = OptimizationProblemToQubo().convert(maxcut_problem_100)
cost_hamiltonian_100, offset_100 = to_ising(qubo_100)

circuit_100 = QAOAAnsatz(cost_operator=cost_hamiltonian_100, reps=1)
circuit_100.measure_all()
Paso 2 : Compilar para el backend de hardware seleccionado.
# Step 2: transpile for hardware.
pm = generate_preset_pass_manager(optimization_level=3, backend=backend)
candidate_circuit_100 = pm.run(circuit_100)
Paso 3 : Ejecuta el bucle de optimización de QAOA dentro de una sesión y, a continuación, toma una muestra.
# Step 3: run the QAOA optimization loop on the device, then sample the
# final distribution with the optimized parameters.
initial_gamma = np.pi
initial_beta = np.pi / 2
init_params = [initial_beta, initial_gamma]

objective_func_vals = []  # Global variable
with Session(backend=backend) as session:
    estimator = Estimator(mode=session)
    estimator.options.default_shots = 1000

    # Set simple error suppression/mitigation options
    estimator.options.dynamical_decoupling.enable = True
    estimator.options.dynamical_decoupling.sequence_type = "XY4"
    estimator.options.twirling.enable_gates = True
    estimator.options.twirling.num_randomizations = "auto"
    estimator.options.environment.job_tags = ["TUT_QAOA"]

    result = minimize(
        cost_func_estimator,
        init_params,
        args=(candidate_circuit_100, cost_hamiltonian_100, estimator),
        method="COBYLA",
    )
    print(result)

# Assign optimal parameters and sample the final distribution.
optimized_circuit_100 = candidate_circuit_100.assign_parameters(result.x)

sampler = Sampler(mode=backend)
sampler.options.default_shots = 10000

# Set simple error suppression/mitigation options
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = "XY4"
sampler.options.twirling.enable_gates = True
sampler.options.twirling.num_randomizations = "auto"

# Add a unique tag to the job execution
sampler.options.environment.job_tags = ["TUT_QAOA"]

pub = (optimized_circuit_100,)
job = sampler.run([pub], shots=int(1e4))

counts_int = job.result()[0].data.meas.get_int_counts()
shots = sum(counts_int.values())
final_distribution_100_int = {
    key: val / shots for key, val in counts_int.items()
}
Output:
 message: Return from COBYLA because the trust region radius reaches its lower bound.
 success: True
  status: 0
     fun: -4.214640355142735
       x: [ 2.586e+00  4.161e+00]
    nfev: 26
   maxcv: 0.0
Paso 4 : Procesar posteriormente la distribución muestreada para extraer el mejor corte.
# Step 4: find the best-cost sample and evaluate its cut value.
best_sol_100 = best_solution(final_distribution_100_int, cost_hamiltonian_100)
best_sol_bitstring_100 = to_bitstring(int(best_sol_100), len(graph_100))
best_sol_bitstring_100.reverse()

print("Result bitstring:", best_sol_bitstring_100)

cut_value_100 = maxcut_problem_100.objective.evaluate(
    np.array(best_sol_bitstring_100)
)
print("The value of the cut is:", cut_value_100)
Output:
Result bitstring: [1, 0, 0, 1, 1, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 1, 0, 0, 0, 1, 0, 1, 1, 0, 1, 0, 1, 1, 1, 0, 1, 0, 0, 0, 1, 0, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 1, 0, 0, 0, 1, 0, 0, 1, 0, 0, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 0, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 1, 1, 0, 1]
The value of the cut is: 78.0
Comprueba que el coste minimizado en el bucle de optimización haya convergido y visualiza los resultados.
# Plot convergence
plt.figure(figsize=(12, 6))
plt.plot(objective_func_vals)
plt.xlabel("Iteration")
plt.ylabel("Cost")
plt.show()

# Visualize the cut
plot_result(graph_100, best_sol_bitstring_100)

# Plot cumulative distribution function
result_dist = samples_to_objective_values(
    final_distribution_100_int, cost_hamiltonian_100
)
fig, ax = plt.subplots(1, 1, figsize=(8, 6))
plot_cdf(result_dist, ax, backend.name)
Output:


Próximos pasos
Si te ha parecido interesante este trabajo, quizá te interese el siguiente material:
- Técnicas avanzadas para QAOA : análisis de estrategias avanzadas para mejorar el rendimiento de QAOA
- Reto de optimización multiobjetivo : pon a prueba tus habilidades con este reto comunitario sobre optimización cuántica multiobjetivo
- Documentación sobre la transpilación para el ajuste fino de la optimización de circuitos
- Supresión y mitigación de errores para mejorar los resultados del hardware