Algoritmo di ottimizzazione approssimata quantistica
Stima dell'utilizzo: 22 minuti su un processore Heron r3 (NOTA: questa è solo una stima. Il tempo di esecuzione potrebbe variare)
Risultati di apprendimento
- Come mappare un problema classico di ottimizzazione combinatoria (max-cut) su un hamiltoniano quantistico
- Come implementare ed eseguire l'algoritmo di ottimizzazione approssimativa quantistica (QAOA) utilizzando le sessioni del servizio di elaborazion IBM Quantum
- Come scalare un flusso di lavoro QAOA da un piccolo esempio di simulazione all'esecuzione su hardware su scala industriale
Prerequisiti
- Nozioni di base sui circuiti quantistici
- Algoritmi variazionali
- QAOA approfondito — per una trattazione completa dell'algoritmo QAOA e della sua applicazione su scala industriale
Sfondo
L 'algoritmo di ottimizzazione approssimativa quantistica (QAOA) è un metodo iterativo ibrido quantistico-classico per la risoluzione di problemi di ottimizzazione combinatoria. In questo tutorial utilizzerai QAOA per risolvere il problema del taglio massimo (max-cut), un problema di ottimizzazione NP-difficile con applicazioni nel clustering, nella scienza delle reti e nella fisica statistica. Dato un grafo composto da nodi collegati da archi, l'obiettivo è quello di suddividere i nodi in due insiemi in modo tale da massimizzare il numero di archi che attraversano la partizione.
L'ottimizzazione combinatoria trova applicazione anche nelle sfide legate alla sostenibilità, come la pianificazione dei percorsi di consegna per ridurre il consumo di carburante e l'allocazione delle risorse per limitare lo spreco di materiali. L'esempio relativo al max-cut illustra il processo che consiste nell'esprimere un obiettivo sotto forma di hamiltoniano di costo e nell'esplorare le soluzioni candidate con il QAOA. L'applicazione di questo approccio a un problema di sostenibilità richiede un obiettivo e dei vincoli che rispecchino l'applicazione prevista.
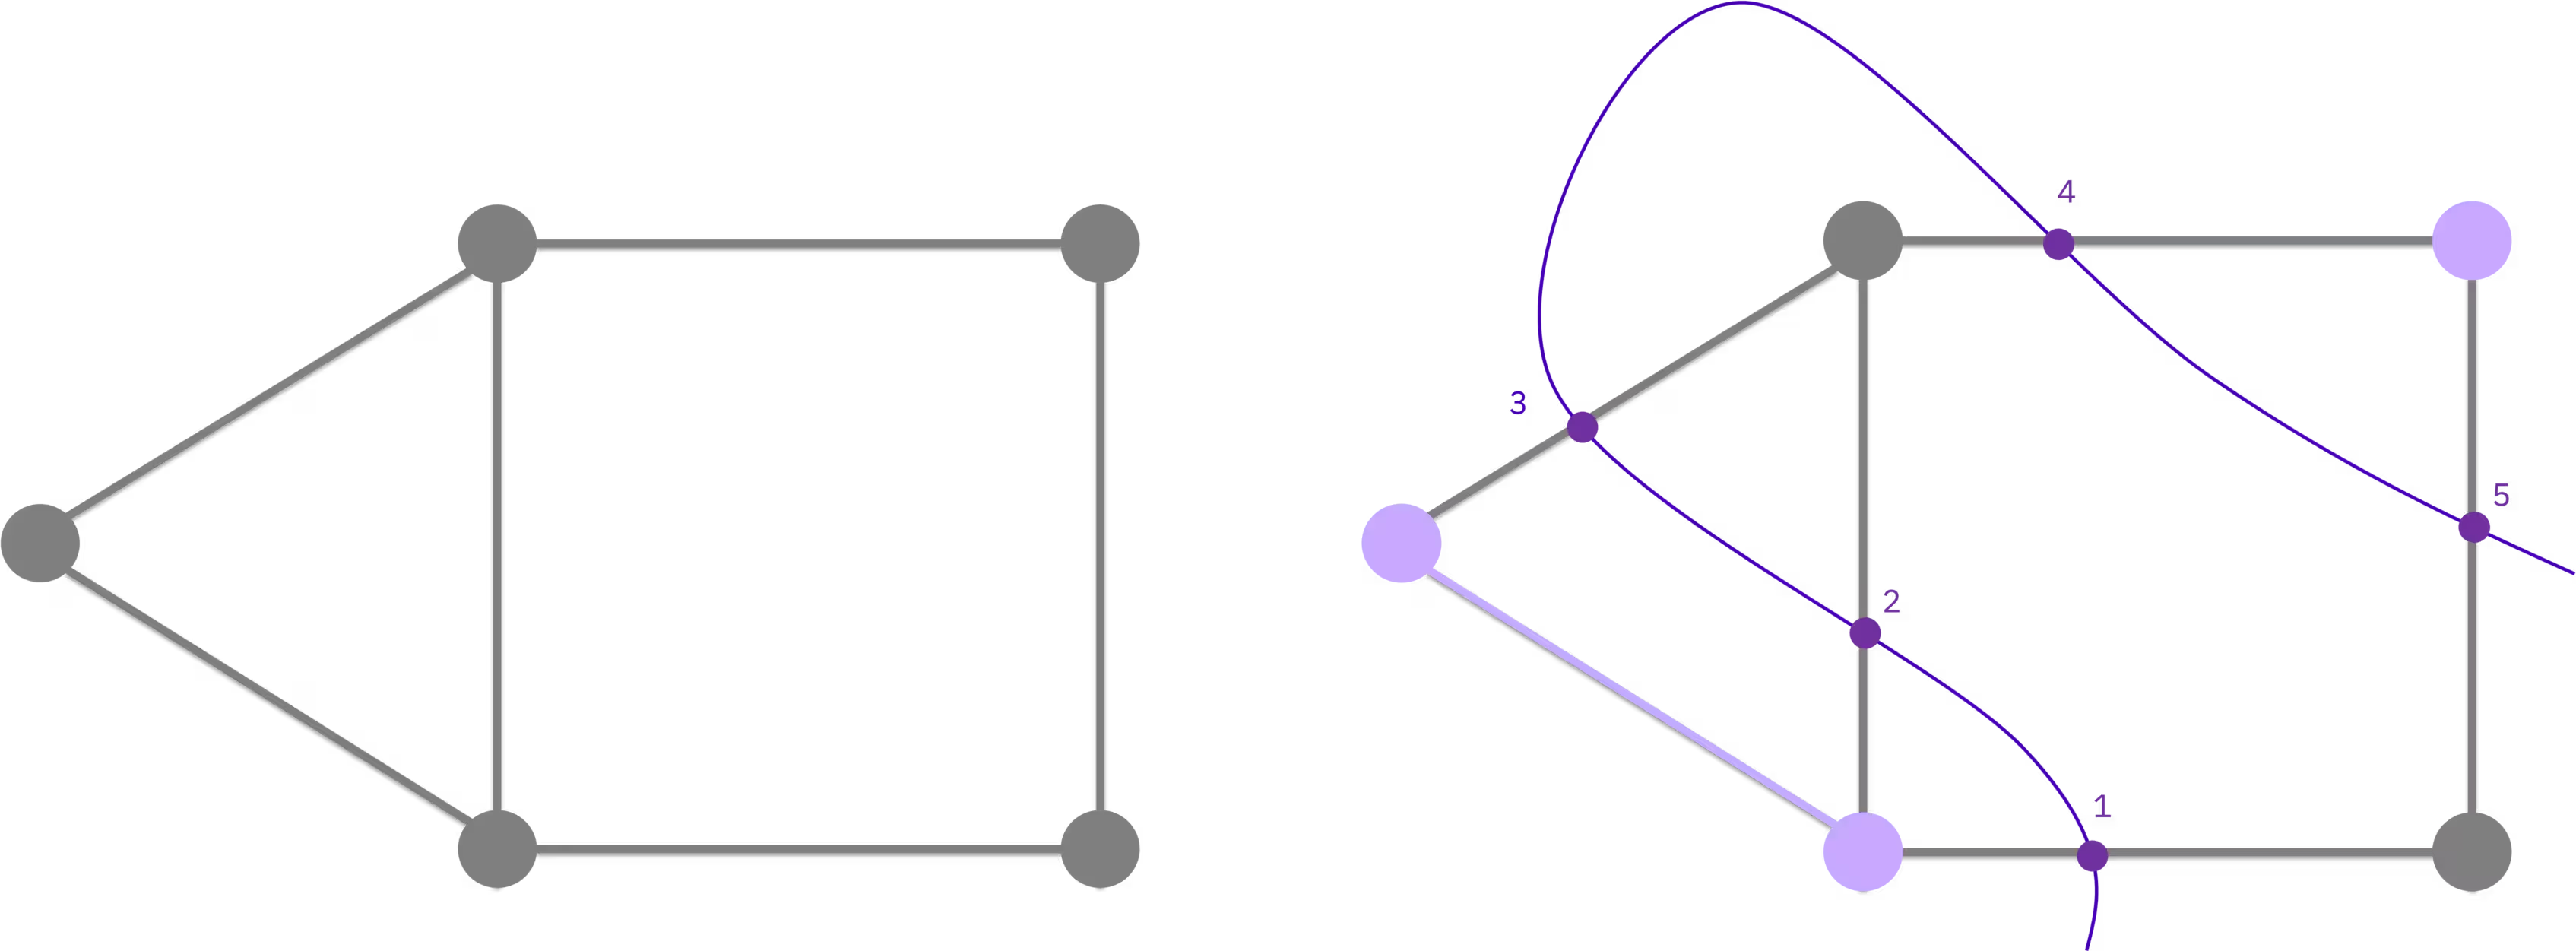
Dall'ottimizzazione classica ai circuiti quantistici
Il problema del max-cut può essere formulato come un classico problema di ottimizzazione binaria. A ogni nodo viene assegnata una variabile binaria che indica a quale insieme appartiene. L'obiettivo è quello di massimizzare il numero di spigoli i cui estremi appartengono a insiemi diversi:
Si tratta, in sostanza, di un problema di ottimizzazione binaria quadratica senza vincoli (QUBO) della forma . Attraverso una sostituzione standard delle variabili ( ), il QUBO può essere riscritto come un hamiltoniano di costo il cui stato fondamentale codifica la soluzione ottimale. In generale, questo hamiltoniano contiene sia termini quadratici che lineari:
In questo tutorial non si esegue questa sostituzione a mano. L'add-on Optimization Mapper per Qiskit (qiskit-addon-opt-mapper) fornisce una classe di applicazione Maxcut che modella il problema direttamente a partire da un grafo, un convertitore che trasforma il modello in un QUBO e un traduttore che mappa il QUBO in . Per il problema del taglio massimo non ponderato qui considerato, i coefficienti lineari sono pari a zero ( ) e ogni arco contribuisce con un termine , insieme a un offset costante che mette in relazione con il valore del taglio. La stessa pipeline gestisce grafi ponderati e altri problemi esprimibili in QUBO senza modificare il resto del flusso di lavoro.
Come funziona QAOA
QAOA prepara soluzioni candidate applicando strati alternati di due operatori a uno stato di sovrapposizione iniziale : l’ operatore di costo e un operatore di miscelazione . Gli angoli e vengono ottimizzati in un ciclo di retroazione classico; il computer quantistico valuta la funzione di costo e un ottimizzatore classico aggiorna i parametri fino alla convergenza. Questo ciclo iterativo viene eseguito all'interno di una sessione di Quantum Compute, che mantiene il dispositivo quantistico riservato per tutte le iterazioni, garantendo così una minore latenza.

Per un approfondimento della teoria QAOA, compresa la derivazione completa dal QUBO all'Hamiltoniano, si veda il modulo del corso dedicato alla QAOA.
In questo tutorial risolverai innanzitutto il problema del max-cut su un piccolo grafo a cinque nodi, per poi estendere lo stesso flusso di lavoro a un problema su scala industriale con 100 nodi, utilizzando hardware reale. Nota sull'accesso al piano: questo tutorial utilizza le sessioni Quantum Compute, disponibili esclusivamente con il piano Premium. Se stai utilizzando il piano Open, non puoi eseguire questo tutorial così com'è; dovrai invece passare alla Session modalità job (ovvero, inviare ogni iterazione come job indipendente anziché racchiudere il ciclo di ottimizzazione all'interno di Session(...)). Il flusso di lavoro continua a funzionare, ma ogni iterazione comporta la latenza completa della coda, anziché riutilizzare un dispositivo riservato. Per ulteriori informazioni, consulta la panoramica dei piani disponibili.
Requisiti
Prima di iniziare questa esercitazione, assicuratevi di aver installato quanto segue:
- Qiskit SDK v2.0 o versioni successive, con supporto alla visualizzazione
- Qiskit Runtime v0.22 o successivamente (
pip install qiskit-ibm-runtime) - Componente aggiuntivo "Optimization Mapper" per Qiskit (
pip install qiskit-addon-opt-mapper)
Inoltre, dovrai avere accesso a un'istanza su IBM Quantum® Platform.
Configura
import matplotlib.pyplot as plt
import rustworkx as rx
from rustworkx.visualization import mpl_draw as draw_graph
import numpy as np
from scipy.optimize import minimize
from collections import defaultdict


from qiskit.quantum_info import SparsePauliOp
from qiskit.circuit.library import QAOAAnsatz
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import Session, EstimatorV2 as Estimator
from qiskit_ibm_runtime import SamplerV2 as Sampler

from qiskit_addon_opt_mapper.applications import Maxcut
from qiskit_addon_opt_mapper.converters import OptimizationProblemToQubo
from qiskit_addon_opt_mapper.translators import to_ising
Esempio su piccola scala
Questa sezione illustra passo dopo passo il flusso di lavoro QAOA su una piccola istanza max-cut a cinque nodi. Nonostante sia definito "su piccola scala", questo esempio viene comunque eseguito su un vero hardware IBM Quantum : il codice seleziona un backend con almeno 127 qubit ed esegue il circuito su di esso.
Inizializzare il problema creando un grafo con nodi.
n_small = 5

graph = rx.PyGraph()
graph.add_nodes_from(np.arange(0, n_small, 1))
edge_list = [
    (0, 1, 1.0),
    (0, 2, 1.0),
    (0, 4, 1.0),
    (1, 2, 1.0),
    (2, 3, 1.0),
    (3, 4, 1.0),
]
graph.add_edges_from(edge_list)
draw_graph(graph, node_size=600, with_labels=True)
Output:

Fase 1: mappare gli input classici su un problema quantistico
Rappresentare graficamente il grafo classico in circuiti e operatori quantistici. Come descritto nella sezione " Contesto ", il max-cut è un problema QUBO il cui hamiltoniano di costo ha uno stato fondamentale che codifica il taglio ottimale, mentre il QAOA utilizza un circuito ansatz parametrizzato per preparare stati fondamentali candidati di . Utilizza l'add-on Optimization Mapper per passare dal grafo a in tre passaggi: modellare il problema, convertirlo in un QUBO e tradurre il QUBO in un hamiltoniano di Ising.
Formulare il problema
La classe dell'applicazione Maxcut accetta direttamente il grafo rustworkx e restituisce un oggetto il cui OptimizationProblem obiettivo è il valore del taglio da massimizzare. Ogni arco contribuisce con all'obiettivo, esattamente come descritto nella sezione " Contesto".
maxcut = Maxcut(graph)
maxcut_problem = maxcut.to_optimization_problem()
print(maxcut_problem.prettyprint())
Output:
Problem name: Max-cut

Maximize
  -2*x_0*x_1 - 2*x_0*x_2 - 2*x_0*x_4 - 2*x_1*x_2 - 2*x_2*x_3 - 2*x_3*x_4 + 3*x_0
  + 2*x_1 + 3*x_2 + 2*x_3 + 2*x_4

Subject to
  No constraints

  Binary variables (5)
    x_0 x_1 x_2 x_3 x_4
Calcolare l'hamiltoniano dei costi
Convertire il problema in un QUBO con OptimizationProblemToQubo, quindi tradurre il QUBO in un hamiltoniano di Ising con to_ising. Il convertitore trasforma la massimizzazione in una minimizzazione del valore di taglio negato, mentre il traduttore applica la sostituzione . Restituisce come insieme SparsePauliOp a uno scalare offset tale che . Poiché il QUBO minimizza il valore di cut negato, il valore di cut di qualsiasi stringa di bit è .
qubo = OptimizationProblemToQubo().convert(maxcut_problem)
cost_hamiltonian, offset = to_ising(qubo)
print("Cost Function Hamiltonian:", cost_hamiltonian)
print("Offset:", offset)
Output:
Cost Function Hamiltonian: SparsePauliOp(['IIIZZ', 'IIZIZ', 'ZIIIZ', 'IIZZI', 'IZZII', 'ZZIII'],
              coeffs=[0.5+0.j, 0.5+0.j, 0.5+0.j, 0.5+0.j, 0.5+0.j, 0.5+0.j])
Offset: -3.0
Costruire il circuito di riferimento QAOA
Utilizzare QAOAAnsatz per costruire il circuito QAOA parametrizzato a partire dall'Hamiltoniano di costo. In questo caso utilizziamo reps=2 (due livelli QAOA, quattro parametri: ).
circuit = QAOAAnsatz(cost_operator=cost_hamiltonian, reps=2)
circuit.measure_all()

circuit.draw("mpl")
Output:

circuit.parametersOutput:
ParameterView([ParameterVectorElement(β[0]), ParameterVectorElement(β[1]), ParameterVectorElement(γ[0]), ParameterVectorElement(γ[1])])
Fase 2: Ottimizzazione del problema per l'esecuzione su hardware quantistico
Trasformare il circuito astratto in istruzioni native dell'hardware. Questa fase gestisce la mappatura dei qubit, la scomposizione dei gate, l'instradamento e la correzione degli errori. Per ulteriori informazioni, consultare la documentazione sulla transpilazione.
service = QiskitRuntimeService()
backend = service.least_busy(
    operational=True, simulator=False, min_num_qubits=127
)
print(backend)

# Create pass manager for transpilation. Level 3 is the most aggressive
# preset: slower to transpile, but produces shorter circuits that are
# more robust to hardware noise.
pm = generate_preset_pass_manager(optimization_level=3, backend=backend)

candidate_circuit = pm.run(circuit)
candidate_circuit.draw("mpl", fold=False, idle_wires=False)
Output:
<IBMBackend('ibm_pittsburgh')>

Passaggio 3: eseguire utilizzando Qiskit primitives
Il ciclo di ottimizzazione QAOA viene eseguito all'interno di una sessione di Quantum Compute per garantire che il dispositivo rimanga riservato durante tutte le iterazioni. Un estimatore valuta l' e in ogni fase, mentre un ottimizzatore classico (COBYLA) aggiorna i parametri fino alla convergenza.
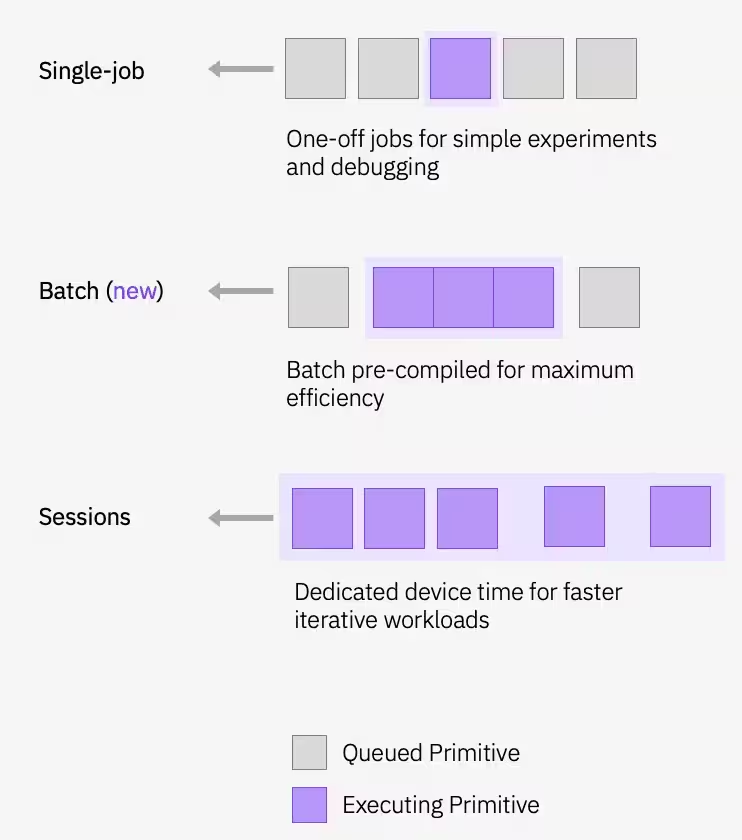
Definire i parametri iniziali ed eseguire il ciclo di ottimizzazione:
# QAOA doesn't prescribe principled default angles — any bounded choice
# works as a warm start for problems this small. beta and gamma are
# periodic (beta in [0, pi] and gamma in [0, 2*pi] modulo the underlying
# Pauli-rotation periods), and pi/2 and pi are just midpoints of those
# ranges. For harder problems you would typically warm start from known
# good angles or transfer parameters from smaller instances.
initial_gamma = np.pi
initial_beta = np.pi / 2
init_params = [initial_beta, initial_beta, initial_gamma, initial_gamma]
def cost_func_estimator(params, ansatz, hamiltonian, estimator):
# transform the observable defined on virtual qubits to
# an observable defined on all physical qubits
isa_hamiltonian = hamiltonian.apply_layout(ansatz.layout)
pub = (ansatz, isa_hamiltonian, params)
job = estimator.run([pub])
results = job.result()[0]
cost = results.data.evs
objective_func_vals.append(cost)
return costobjective_func_vals = [] # Global variable
with Session(backend=backend) as session:
# If using qiskit-ibm-runtime<0.24.0, change `mode=` to `session=`
estimator = Estimator(mode=session)
estimator.options.default_shots = 1000
# Set simple error suppression/mitigation options
estimator.options.dynamical_decoupling.enable = True
estimator.options.dynamical_decoupling.sequence_type = "XY4"
estimator.options.twirling.enable_gates = True
estimator.options.twirling.num_randomizations = "auto"
estimator.options.environment.job_tags = ["TUT_QAOA"]
result = minimize(
cost_func_estimator,
init_params,
args=(candidate_circuit, cost_hamiltonian, estimator),
method="COBYLA",
tol=1e-2,
)
print(result)Output:
 message: Return from COBYLA because the trust region radius reaches its lower bound.
 success: True
  status: 0
     fun: -1.0164225323839062
       x: [ 1.404e+00  1.174e+00  4.036e+00  2.969e+00]
    nfev: 30
   maxcv: 0.0
L'ottimizzatore è riuscito a ridurre i costi e a trovare parametri migliori per il circuito.
Una curva che scende gradualmente fino a stabilizzarsi è il segno distintivo della convergenza. Una curva irregolare e rumorosa indica solitamente che è necessario prestare attenzione a qualche fase precedente; le cause più comuni sono un numero insufficiente di iterazioni per valutazione (elevata varianza dello stimatore), parametri iniziali inadeguati o un circuito la cui profondità è dominata dal rumore hardware. COBYLA non utilizza derivate ed è abbastanza resistente al rumore moderato, ma quando il rumore supera i miglioramenti effettivi del costo per ogni passo, il suo modello di approssimazione lineare non è più in grado di distinguere la discesa reale dal jitter casuale e l'ottimizzatore si smarrisce.
plt.figure(figsize=(12, 6))
plt.plot(objective_func_vals)
plt.xlabel("Iteration")
plt.ylabel("Cost")
plt.show()
Output:

Assegnare i parametri ottimizzati e campionare la distribuzione finale utilizzando la primitiva Sampler.
optimized_circuit = candidate_circuit.assign_parameters(result.x)
optimized_circuit.draw("mpl", fold=False, idle_wires=False)
Output:

# If using qiskit-ibm-runtime<0.24.0, change `mode=` to `backend=`
sampler = Sampler(mode=backend)
sampler.options.default_shots = 10000

# Set simple error suppression/mitigation options
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = "XY4"
sampler.options.twirling.enable_gates = True
sampler.options.twirling.num_randomizations = "auto"

sampler.options.environment.job_tags = ["TUT_QAOA"]

pub = (optimized_circuit,)
job = sampler.run([pub], shots=int(1e4))
counts_int = job.result()[0].data.meas.get_int_counts()
counts_bin = job.result()[0].data.meas.get_counts()
shots = sum(counts_int.values())
final_distribution_int = {key: val / shots for key, val in counts_int.items()}
final_distribution_bin = {key: val / shots for key, val in counts_bin.items()}
print(final_distribution_int)
Output:
{22: 0.1003, 15: 0.008, 9: 0.0934, 4: 0.02, 31: 0.004, 17: 0.0288, 18: 0.0327, 14: 0.0305, 10: 0.0358, 28: 0.0128, 5: 0.0868, 20: 0.09, 11: 0.0908, 13: 0.0321, 19: 0.0298, 27: 0.0186, 8: 0.0077, 30: 0.0211, 23: 0.0098, 26: 0.0839, 12: 0.0254, 21: 0.0315, 16: 0.0082, 25: 0.01, 6: 0.0131, 1: 0.0205, 2: 0.0145, 29: 0.0137, 7: 0.0059, 3: 0.0101, 24: 0.0078, 0: 0.0024}
Fase 4: Post-elaborazione e restituzione del risultato nel formato classico desiderato
Estrarre la stringa di bit più probabile dalla distribuzione campionata. Questo rappresenta il miglior taglio individuato da QAOA. Il interpret metodo della classe Maxcut decodifica la stringa di bit nei due insiemi di nodi della partizione.
# auxiliary functions to sample most likely bitstring
def to_bitstring(integer, num_bits):
    result = np.binary_repr(integer, width=num_bits)
    return [int(digit) for digit in result]


keys = list(final_distribution_int.keys())
values = list(final_distribution_int.values())
most_likely = keys[np.argmax(np.abs(values))]
most_likely_bitstring = to_bitstring(most_likely, len(graph))
most_likely_bitstring.reverse()

print("Result bitstring:", most_likely_bitstring)

partition = maxcut.interpret(np.array(most_likely_bitstring))
print("Partition:", partition)
Output:
Result bitstring: [0, 1, 1, 0, 1]
Partition: [[0, 3], [1, 2, 4]]
plt.rcParams.update({"font.size": 10})
final_bits = final_distribution_bin
values = np.abs(list(final_bits.values()))
top_4_values = sorted(values, reverse=True)[:4]
positions = []
for value in top_4_values:
    positions.append(np.where(values == value)[0])
fig = plt.figure(figsize=(11, 6))
ax = fig.add_subplot(1, 1, 1)
plt.xticks(rotation=45)
plt.title("Result Distribution")
plt.xlabel("Bitstrings (reversed)")
plt.ylabel("Probability")
ax.bar(list(final_bits.keys()), list(final_bits.values()), color="tab:grey")
for p in positions:
    ax.get_children()[int(p[0])].set_color("tab:purple")
plt.show()
Output:

Visualizza il taglio migliore
A partire dalla stringa di bit ottimale, è quindi possibile visualizzare questo taglio sul grafico originale.
# auxiliary function to plot graphs
def plot_result(G, x):
    colors = ["tab:grey" if i == 0 else "tab:purple" for i in x]
    pos, _default_axes = rx.spring_layout(G), plt.axes(frameon=True)
    rx.visualization.mpl_draw(
        G, node_color=colors, node_size=100, alpha=0.8, pos=pos
    )


plot_result(graph, most_likely_bitstring)
Output:

Ora, calcola il valore del taglio. L'obiettivo è OptimizationProblem il valore di cut stesso, quindi valutalo direttamente sulla stringa di bit. È inoltre possibile confrontarlo con il valore di taglio implicito nel costo finale dell'ottimizzatore, , che rappresenta una media sull'intera distribuzione campionata piuttosto che il valore di una singola stringa di bit.
cut_value = maxcut_problem.objective.evaluate(np.array(most_likely_bitstring))
print("The value of the cut is:", cut_value)
print("Cut value implied by the optimized cost:", -(result.fun + offset))
Output:
The value of the cut is: 5.0
Cut value implied by the optimized cost: 4.016422532383906
Per un grafico così piccolo, è facile trovare il vero optimum con un calcolo a forza bruta, quindi è possibile verificare i risultati confrontando il risultato ottenuto con il metodo QAOA con la risposta esatta.
# Classical baseline: enumerate all 2**n_small bitstrings and take the best cut.
def brute_force_max_cut(problem) -> tuple[int, list[int]]:
    n = problem.get_num_vars()
    best_cut = -1
    best_x: list[int] = []
    for i in range(2**n):
        x = np.array([(i >> k) & 1 for k in range(n)])
        cut = problem.objective.evaluate(x)
        if cut > best_cut:
            best_cut = int(cut)
            best_x = x.tolist()
    return best_cut, best_x


classical_best, classical_x = brute_force_max_cut(maxcut_problem)
print(f"Classical optimum (brute force): {classical_best}")
print(f"QAOA cut value:                  {cut_value}")
Output:
Classical optimum (brute force): 5
QAOA cut value:                  5.0
Esempio di hardware su larga scala
Su IBM Quantum Platform puoi trovare numerosi dispositivi con oltre 100 qubit. Scegli uno su cui risolvere il problema del taglio massimo su un grafo ponderato a 100 nodi. Si tratta di un problema su "scala industriale". Il flusso di lavoro segue gli stessi passaggi descritti sopra, applicati a un grafico di dimensioni molto maggiori.
Flusso di lavoro end-to-end su scala industriale
Di seguito sono illustrate tutte e quattro le fasi, applicate al grafico a 100 nodi. La struttura è la stessa della guida in scala ridotta: mappa, transpilazione, esecuzione, post-elaborazione — ma con un problema più complesso e suddiviso tra le quattro celle sottostanti per maggiore chiarezza.
# Precomputed parity lookup table: _PARITY[b] = +1 if popcount(b) is even, else -1.
# We use this to vectorize expectation-value evaluation across all Pauli terms.
_PARITY = np.array(
    [-1 if bin(i).count("1") % 2 else 1 for i in range(256)],
    dtype=np.complex128,
)


def evaluate_sparse_pauli(state: int, observable: SparsePauliOp) -> complex:
    """Expectation value of a SparsePauliOp on a single computational-basis state.

    For a Z-only observable (which QAOA cost Hamiltonians are, after the
    QUBO-to-Hamiltonian mapping), the eigenvalue of each Pauli term on a
    computational-basis state is simply (-1)**popcount(z_mask AND state),
    i.e., the parity of the bitwise-AND of the term's Z-support and the
    measured bitstring.

    This routine packs the Z-support of every Pauli term into bytes, ANDs
    them against the measured state in a single vectorized op, and looks up
    the parity in _PARITY. For a 100-qubit / ~hundreds-of-terms Hamiltonian
    over 10_000 samples, this is dramatically faster than calling
    SparsePauliOp.expectation_value per sample.
    """
    packed_uint8 = np.packbits(observable.paulis.z, axis=1, bitorder="little")
    state_bytes = np.frombuffer(
        state.to_bytes(packed_uint8.shape[1], "little"), dtype=np.uint8
    )
    reduced = np.bitwise_xor.reduce(packed_uint8 & state_bytes, axis=1)
    return np.sum(observable.coeffs * _PARITY[reduced])


def best_solution(samples, hamiltonian):
    """Return the sampled bitstring (as int) with the lowest Hamiltonian cost."""
    min_cost = float("inf")
    min_sol = None
    for bit_str in samples.keys():
        candidate_sol = int(bit_str)
        fval = evaluate_sparse_pauli(candidate_sol, hamiltonian).real
        if fval <= min_cost:
            min_cost = fval
            min_sol = candidate_sol
    return min_sol


def _plot_cdf(objective_values: dict, ax, color):
    x_vals = sorted(objective_values.keys(), reverse=True)
    y_vals = np.cumsum([objective_values[x] for x in x_vals])
    ax.plot(x_vals, y_vals, color=color)


def plot_cdf(dist, ax, title):
    _plot_cdf(dist, ax, "C1")
    ax.vlines(min(list(dist.keys())), 0, 1, "C1", linestyle="--")
    ax.set_title(title)
    ax.set_xlabel("Objective function value")
    ax.set_ylabel("Cumulative distribution function")
    ax.grid(alpha=0.3)


def samples_to_objective_values(samples, hamiltonian):
    """Convert the samples to values of the objective function."""
    objective_values = defaultdict(float)
    for bit_str, prob in samples.items():
        candidate_sol = int(bit_str)
        fval = evaluate_sparse_pauli(candidate_sol, hamiltonian).real
        objective_values[fval] += prob
    return objective_values
Passaggio 1 : Costruire il grafico a partire dalla mappa di accoppiamento del backend, quindi mapparlo sull'Hamiltoniano dei costi utilizzando l'add-on Optimization Mapper e costruire l'ansatz.
# Step 1: build the 100-node graph, cost Hamiltonian, and QAOA ansatz.
n_large = 100
graph_100 = rx.PyGraph()
graph_100.add_nodes_from(np.arange(0, n_large, 1))
elist = set()
for u, v in backend.coupling_map:
    # The coupling map lists both directions of each coupler, so sort
    # the endpoints to avoid adding the same edge twice.
    if u < n_large and v < n_large:
        elist.add((min(u, v), max(u, v), 1.0))
graph_100.add_edges_from(sorted(elist))

maxcut_100 = Maxcut(graph_100)
maxcut_problem_100 = maxcut_100.to_optimization_problem()
qubo_100 = OptimizationProblemToQubo().convert(maxcut_problem_100)
cost_hamiltonian_100, offset_100 = to_ising(qubo_100)

circuit_100 = QAOAAnsatz(cost_operator=cost_hamiltonian_100, reps=1)
circuit_100.measure_all()
Passaggio 2 : Compilazione per il backend hardware selezionato.
# Step 2: transpile for hardware.
pm = generate_preset_pass_manager(optimization_level=3, backend=backend)
candidate_circuit_100 = pm.run(circuit_100)
Passaggio 3 : eseguire il ciclo di ottimizzazione QAOA all'interno di una sessione, quindi effettuare il campionamento.
# Step 3: run the QAOA optimization loop on the device, then sample the
# final distribution with the optimized parameters.
initial_gamma = np.pi
initial_beta = np.pi / 2
init_params = [initial_beta, initial_gamma]

objective_func_vals = []  # Global variable
with Session(backend=backend) as session:
    estimator = Estimator(mode=session)
    estimator.options.default_shots = 1000

    # Set simple error suppression/mitigation options
    estimator.options.dynamical_decoupling.enable = True
    estimator.options.dynamical_decoupling.sequence_type = "XY4"
    estimator.options.twirling.enable_gates = True
    estimator.options.twirling.num_randomizations = "auto"
    estimator.options.environment.job_tags = ["TUT_QAOA"]

    result = minimize(
        cost_func_estimator,
        init_params,
        args=(candidate_circuit_100, cost_hamiltonian_100, estimator),
        method="COBYLA",
    )
    print(result)

# Assign optimal parameters and sample the final distribution.
optimized_circuit_100 = candidate_circuit_100.assign_parameters(result.x)

sampler = Sampler(mode=backend)
sampler.options.default_shots = 10000

# Set simple error suppression/mitigation options
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = "XY4"
sampler.options.twirling.enable_gates = True
sampler.options.twirling.num_randomizations = "auto"

# Add a unique tag to the job execution
sampler.options.environment.job_tags = ["TUT_QAOA"]

pub = (optimized_circuit_100,)
job = sampler.run([pub], shots=int(1e4))

counts_int = job.result()[0].data.meas.get_int_counts()
shots = sum(counts_int.values())
final_distribution_100_int = {
    key: val / shots for key, val in counts_int.items()
}
Output:
 message: Return from COBYLA because the trust region radius reaches its lower bound.
 success: True
  status: 0
     fun: -4.214640355142735
       x: [ 2.586e+00  4.161e+00]
    nfev: 26
   maxcv: 0.0
Fase 4 : Elaborare la distribuzione campionaria per individuare il taglio ottimale.
# Step 4: find the best-cost sample and evaluate its cut value.
best_sol_100 = best_solution(final_distribution_100_int, cost_hamiltonian_100)
best_sol_bitstring_100 = to_bitstring(int(best_sol_100), len(graph_100))
best_sol_bitstring_100.reverse()

print("Result bitstring:", best_sol_bitstring_100)

cut_value_100 = maxcut_problem_100.objective.evaluate(
    np.array(best_sol_bitstring_100)
)
print("The value of the cut is:", cut_value_100)
Output:
Result bitstring: [1, 0, 0, 1, 1, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 1, 0, 0, 0, 1, 0, 1, 1, 0, 1, 0, 1, 1, 1, 0, 1, 0, 0, 0, 1, 0, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 1, 0, 0, 0, 1, 0, 0, 1, 0, 0, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 0, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 1, 1, 0, 1]
The value of the cut is: 78.0
Verificare che il costo minimizzato nel ciclo di ottimizzazione abbia raggiunto la convergenza e visualizzare i risultati.
# Plot convergence
plt.figure(figsize=(12, 6))
plt.plot(objective_func_vals)
plt.xlabel("Iteration")
plt.ylabel("Cost")
plt.show()

# Visualize the cut
plot_result(graph_100, best_sol_bitstring_100)

# Plot cumulative distribution function
result_dist = samples_to_objective_values(
    final_distribution_100_int, cost_hamiltonian_100
)
fig, ax = plt.subplots(1, 1, figsize=(8, 6))
plot_cdf(result_dist, ax, backend.name)
Output:


Passi successivi
Se questo lavoro ti è sembrato interessante, potrebbero interessarti anche i seguenti contenuti:
- Tecniche avanzate per il QAOA — analizza strategie avanzate per migliorare le prestazioni del QAOA
- Sfida di ottimizzazione multi-obiettivo : metti alla prova le tue competenze con questa sfida della community sull'ottimizzazione quantistica multi-obiettivo
- Documentazione sulla transpilazione per la messa a punto dell'ottimizzazione dei circuiti
- Soppressione e mitigazione degli errori per migliorare i risultati hardware