퀀텀 포트폴리오 최적화기: Global Data Quantum의 Qiskit 함수
API 참조 보기
키스킷 기능은 IBM 퀀텀 프리미엄 요금제, 플렉스 요금제 및 온프레미스( IBM 퀀텀 플랫폼 API를 통해) 요금제 사용자에게만 제공되는 실험적 기능입니다. 프리뷰 릴리스 상태이며 변경될 수 있습니다.
개요
퀀텀 포트폴리오 옵티마이저는 수익을 극대화하고 위험을 최소화하기 위해 자산 집합에 대한 주기적인 투자 재조정을 목표로 하는 금융의 표준 문제인 동적 포트폴리오 최적화 문제를 해결하는 키스킷 함수입니다. 이 기능은 최첨단 양자 최적화 기술을 적용하여 프로세스를 간소화하므로 양자 컴퓨팅에 대한 전문 지식이 없는 사용자도 최적의 투자 궤도를 찾는 데 있어 이점을 활용할 수 있습니다. 포트폴리오 매니저, 퀀트 금융 연구원, 개인 투자자에게 적합한 이 도구는 포트폴리오 최적화를 위한 트레이딩 전략의 백테스팅을 가능하게 합니다.
기능 설명
퀀텀 포트폴리오 옵티마이저 기능은 변동 양자 아이겐솔버(VQE) 알고리즘을 사용해 이차 비제약 이진 최적화(QUBO) 문제를 해결하여 동적 포트폴리오 최적화 문제를 해결합니다. 사용자는 자산 가격 데이터를 제공하고 투자 제약 조건을 정의하기만 하면 함수가 양자 최적화 프로세스를 실행하여 최적화된 투자 궤적 집합을 반환합니다.
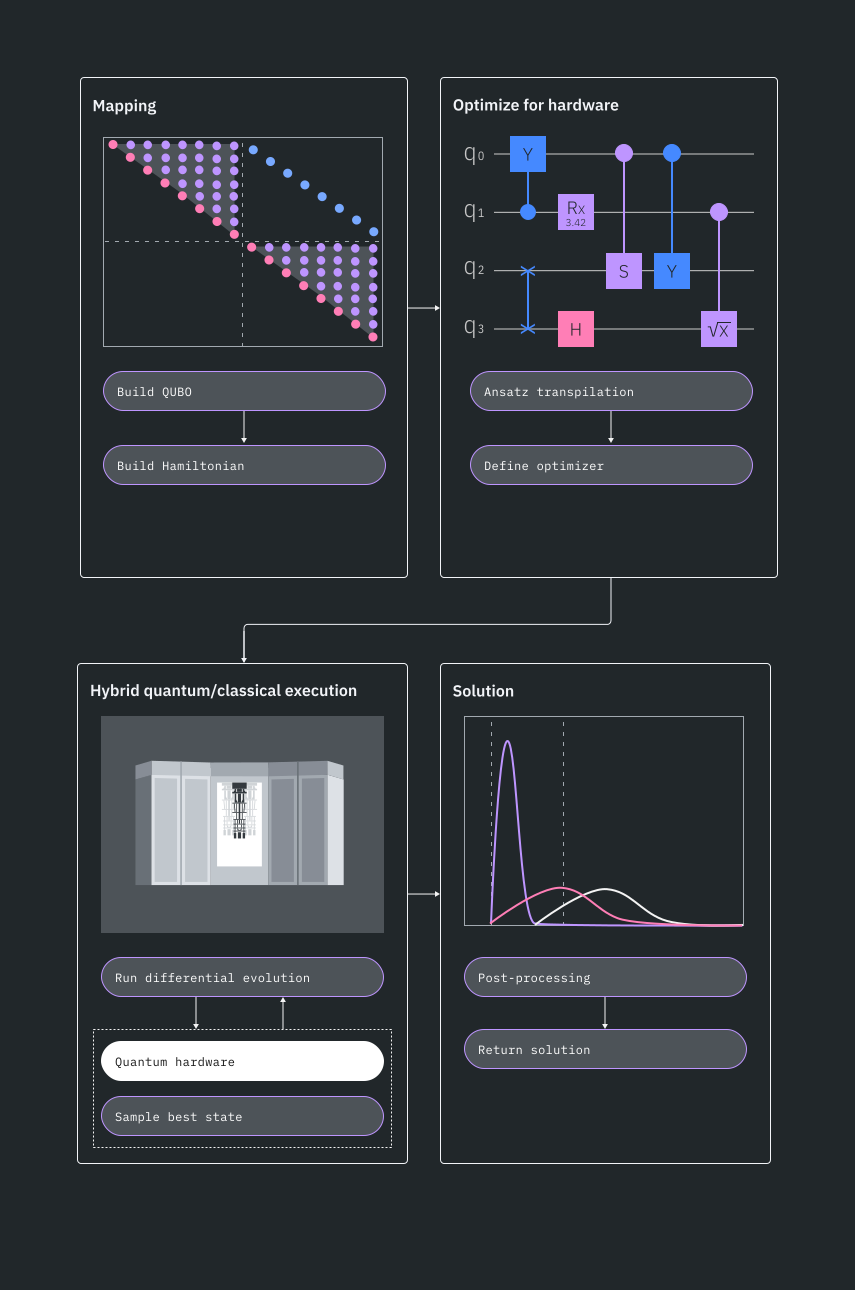
이 과정은 네 가지 주요 단계로 구성됩니다. 먼저, 입력 데이터를 양자 호환 가능한 문제로 매핑하여 동적 포트폴리오 최적화 문제의 QUBO를 구성하고, 이를 양자 연산자(이징 해밀토니안)로 변환합니다. 다음으로, 입력 문제와 VQE 알고리즘을 양자 하드웨어에서 실행할 수 있도록 조정합니다. 그런 다음 양자 하드웨어에서 VQE 알고리즘을 실행하고, 마지막으로 결과를 후처리하여 최적의 투자 궤적을 도출합니다. 또한 이 시스템에는 출력 품질을 극대화하기 위한 노이즈 감지( SQD 기반) 후처리 기능이 포함되어 있습니다.
이 키스킷 함수는 글로벌 데이터 퀀텀에서 발표한 원고를 기반으로 합니다.

시작하기
API 키를 사용하여 인증한 후, 다음과 같이 Qiskit 함수를 선택하세요. (이 코드 조각은 이미 계정을 로컬 환경에 저장해 두었다고 가정합니다.)
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
Output:
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access function
dpo_solver = catalog.load("global-data-quantum/quantum-portfolio-optimizer")
예시: 7개 자산으로 동적 포트폴리오 최적화
이 예에서는 동적 포트폴리오 최적화(DPO) 기능을 실행하고 최적의 성능을 위해 설정을 조정하는 방법을 설명합니다. 여기에는 원하는 결과를 얻기 위해 매개변수를 미세 조정하는 자세한 단계가 포함되어 있습니다.
이 사례에는 7개의 자산, 4개의 시간 단계, 4개의 해상도 큐비트가 필요하므로 총 112개의 큐비트가 필요합니다.
1. 포트폴리오에 포함된 자산을 확인하십시오
포트폴리오의 모든 자산이 특정 경로의 폴더에 저장되어 있는 경우 다음 함수를 사용하여 pandas.DataFrame 에 로드하고 dict 형식의 개체로 변환할 수 있습니다.
import os
import glob
import pandas as pd


def read_and_join_csv(file_pattern):
    """
    Reads multiple CSV files matching the file pattern and combines them
    into a single DataFrame.

    Parameters:
    file_pattern (str): The pattern to match CSV files.

    Returns:
    pd.DataFrame: Combined DataFrame with data from all CSV files.
    """
    # Find all files matching the pattern
    csv_files = glob.glob(file_pattern)
    # Get the base file names without the .csv extension
    file_names = [os.path.basename(f).replace(".csv", "") for f in csv_files]
    # Read each CSV file into a DataFrame and set the first column as the index
    df_list = [pd.read_csv(f).set_index("Unnamed: 0") for f in csv_files]

    # Rename columns in each DataFrame to the base file names
    for df, name in zip(df_list, file_names):
        df.columns = [name]

    # Combine all DataFrames into one by merging them side by side
    combined_df = pd.concat(df_list, axis=1)
    return combined_df


file_pattern = "route/to/folder/with/assets/data/*.csv"
assets = read_and_join_csv(file_pattern).to_dict()
이 예제에서는 자산 8801.T, CLF, GBPJPY, ITX.MC, META, TMBMKDE-10Y 및 XS2239553048. 다음 그림은 2023년 1월 1일부터 9월 1일까지 자산의 일일 종가 변화를 보여주는 이 예제에서 사용된 데이터를 보여줍니다.
이 예시에서는 날짜 간 일관성을 유지하기 위해 거래가 없는 날을 이전 거래 가능 날짜의 종가로 채웠습니다. 이 단계를 적용하는 이유는 선택한 자산이 다양한 거래일을 가진 여러 시장에서 제공되므로 일관성을 위해 데이터 세트를 표준화하는 것이 필수적이기 때문입니다.

2. 문제 정의
qubo_settings 사전에서 매개 변수를 구성하여 문제의 사양을 정의합니다.
qubo_settings = {
    "nt": 4,
    "nq": 4,
    "dt": 30,
    "max_investment": 25,
    "risk_aversion": 1000.0,
    "transaction_fee": 0.01,
    "restriction_coeff": 1.0,
}
3. 최적화기 및 초기 설정 정의 (선택 사항)
선택적으로 최적화 도구 및 매개변수 선택, 프리미티브 사양 및 구성 등 최적화 프로세스에 대한 특정 요구 사항을 정의할 수 있습니다.
맞춤형 안사츠의 경우, 이 값이 안정적이고 효율적인 최적화를 가져온다는 이전 실험 결과를 바탕으로 모집단 크기를 선택했습니다.
실제 진폭 안사츠의 경우, population_size 와 회로의 큐비트 수 사이의 선형 관계를 따를 수 있습니다. 대략적인 경험 법칙으로 real_amplitudes 안사츠의 경우 최소 population_size ~ 0.8 * n_qubits 를 사용하는 것이 좋습니다.
최적화된 실제 진폭은 실제 진폭 안사츠보다 최적화 성능이 더 우수할 것으로 예상됩니다. 그러나 이 분석에서는 최적화해야 할 변수의 수가 실제 진폭의 경우보다 훨씬 빠르게 증가합니다( 원고 참조). 따라서 큰 문제의 경우 최적화된 실제 진폭을 사용하려면 더 많은 회로 실행이 필요합니다. 최적화된 실제 진폭은 최대 100큐비트가 필요한 문제에 유용할 수 있지만 population_size 매개변수를 설정할 때 주의하는 것이 좋습니다. 이전 표( population_size)에서 이 스케일업의 예로 84-큐비트 문제의 경우 실제 진폭 최적화에는 120 population_size 이 필요하지만 56-큐비트 문제의 경우 40의 population_size 으로 충분하다는 것을 알 수 있습니다.
optimizer_settings = {
    "de_optimizer_settings": {
        "num_generations": 20,
        "population_size": 90,
        "recombination": 0.4,
        "max_parallel_jobs": 5,
        "max_batchsize": 4,
        "mutation_range": [0.0, 0.25],
    },
    "optimizer": "differential_evolution",
    "primitive_settings": {
        "estimator_shots": 25_000,
        "estimator_precision": None,
        "sampler_shots": 100_000,
    },
}
특정 답안을 선택할 수도 있습니다. 다음은 'Tailored' 안사츠를 사용합니다.
ansatz_settings = {
    "ansatz": "tailored",
    "multiple_passmanager": False,
}
4. 문제를 실행합니다
dpo_job = dpo_solver.run(
    assets=assets,
    qubo_settings=qubo_settings,
    optimizer_settings=optimizer_settings,
    ansatz_settings=ansatz_settings,
    backend_name="<backend name>",
    previous_session_id=[],
    apply_postprocess=True,
)
5. 결과 가져오기
이 함수는 목적 함수 값에 따라 투자 궤적을 낮은 순서부터 높은 순서로 정렬한 사전(dictionary)을 반환합니다(API 참조 문서의 ‘출력’ 섹션 참조). 이러한 일련의 결과를 통해 비용이 가장 낮은 경로를 파악하고, 이에 상응하는 투자 타당성을 평가할 수 있습니다. 또한, 이 도구는 다양한 경로를 분석할 수 있도록 하여, 특정 요구 사항이나 목표에 가장 부합하는 경로를 쉽게 선택할 수 있게 해줍니다. 이러한 유연성 덕분에 다양한 선호도나 상황에 맞춰 선택지를 조정할 수 있습니다.
프로세스 중에 발견된 가장 낮은 객관적 비용을 달성한 결과 전략을 제시하는 것으로 시작하세요.
# Get the results of the job
dpo_result = dpo_job.result()

# Show the solution strategy
dpo_result["result"]
Output:
{'time_step_0': {'8801.T': 0.11764705882352941,
  'ITX.MC': 0.20588235294117646,
  'META': 0.38235294117647056,
  'GBPJPY=X': 0.058823529411764705,
  'TMBMKDE-10Y': 0.0,
  'CLF': 0.058823529411764705,
  'XS2239553048': 0.17647058823529413},
 'time_step_1': {'8801.T': 0.11428571428571428,
  'ITX.MC': 0.14285714285714285,
  'META': 0.2,
  'GBPJPY=X': 0.02857142857142857,
  'TMBMKDE-10Y': 0.42857142857142855,
  'CLF': 0.0,
  'XS2239553048': 0.08571428571428572},
 'time_step_2': {'8801.T': 0.0,
  'ITX.MC': 0.09375,
  'META': 0.3125,
  'GBPJPY=X': 0.34375,
  'TMBMKDE-10Y': 0.0,
  'CLF': 0.0,
  'XS2239553048': 0.25},
 'time_step_3': {'8801.T': 0.3939393939393939,
  'ITX.MC': 0.09090909090909091,
  'META': 0.12121212121212122,
  'GBPJPY=X': 0.18181818181818182,
  'TMBMKDE-10Y': 0.0,
  'CLF': 0.0,
  'XS2239553048': 0.21212121212121213}}
그 후 메타데이터를 사용하여 샘플링된 모든 전략의 결과에 액세스할 수 있습니다. 따라서 옵티마이저가 반환한 대체 궤적을 추가로 분석할 수 있습니다. 이렇게 하려면 dpo_result['metadata']['all_samples_metrics'] 에 저장된 사전을 읽어보세요. 여기에는 최적 전략에 대한 추가 정보뿐만 아니라 최적화 중에 평가된 다른 후보 전략에 대한 세부 정보도 포함되어 있습니다.
다음 예는 pandas 을 사용하여 이 정보를 읽고 최적의 전략과 관련된 주요 지표를 추출하는 방법을 보여 줍니다. 여기에는 제한 편차, 샤프 비율 및 해당 투자 수익률이 포함됩니다.
# Convert metadata to a DataFrame
df = pd.DataFrame(dpo_result["metadata"]["all_samples_metrics"])

# Find the minimum objective cost
min_cost = df["objective_costs"].min()
print(f"Minimum Objective Cost Found: {min_cost:.2f}")

# Extract the row with the lowest cost
best_row = df[df["objective_costs"] == min_cost].iloc[0]

# Display the results associated with the best solution
print("Best Solution:")
print(f"  - Restriction Deviation: {best_row['rest_breaches']}%")
print(f"  - Sharpe Ratio: {best_row['sharpe_ratios']:.2f}")
print(f"  - Return: {best_row['returns']}")
Output:
Minimum Objective Cost Found: -3.78
Best Solution:
  - Restriction Deviation: 40.0
  - Sharpe Ratio: 24.82
  - Return: 0.46
6. 성능 분석
마지막으로 최적화 애플리케이션의 성능을 분석합니다. 특히 이전 예제에서 얻은 결과를 무작위 기준선과 비교하여 접근 방식의 효과를 평가합니다. 양자 알고리즘이 입증 가능하고 일관되게 더 낮은 비용 값으로 결과를 생성한다면 효과적인 최적화 프로세스를 의미합니다.
그림은 객관적 비용의 확률 분포를 나타냅니다. 이러한 분포를 생성하려면 함수 결과에서 객관적 비용 목록을 가져와 각 비용 값의 발생 횟수(소수점 둘째 자리에서 반올림한 값)를 계산합니다. 그런 다음 동일한 반올림된 값의 카운트를 조인하여 카운트 열을 적절히 업데이트합니다. 시각적 비교를 위해 발생 횟수를 정규화하여 각 분포가 0과 1 사이로 표시되도록 했습니다.

그림(파란색 실선)에서 볼 수 있듯이, 변동 양자 아이겐솔버(SQD로 후처리) 접근법의 비용 분포는 낮은 객관적 비용 값에 급격히 집중되어 있어 최적화 성능이 우수함을 나타냅니다. 반면 노이즈가 있는 기준선은 더 높은 비용 값을 중심으로 더 넓은 분포를 보입니다. 회색 점선 세로선은 무작위 분포의 평균값을 나타내며, 최적화된 투자 전략을 반환하는 함수의 일관성을 더욱 강조합니다. 추가 비교를 위해 그림의 검은색 점선은 Gurobi 최적화 도구(무료 버전)로 얻은 솔루션에 해당합니다. 이러한 모든 결과는 '맞춤형' 답변으로 평가한 '혼합 자산' 예제에 대한 아래 벤치마크에서 자세히 살펴볼 수 있습니다.
벤치마크
이 기능은 다양한 해상도 큐비트, 안사츠 회로, 다양한 섹터의 자산 그룹(세트 1), 석유 파생상품(세트 2), IBEX35 (세트 3) 등 다양한 구성에서 테스트되었습니다. 자세한 내용은 다음 표를 참조하세요.
설정 | 날짜 | 자산 |
|---|---|---|
| 세트 1 | 01/01/2023 | 8801.T cL=F, GBPJPY=X, ITX.MC, 메타, TMBMKDE-10Y, XS2239553048 |
| 세트 2 | 01/06/2023 | CL=F, BZ=F, HO=F, NG=F, XOM, RB=F, 2222.SR |
| 세트 3 | 01/11/2022 | ACS.MC, ITX.MC, FER.MC, ELE.MC, SCYR.MC, AENA.MC, AMS.MC |
솔루션 품질을 평가하기 위해 두 가지 주요 지표를 사용했습니다.
- 객관적 비용은 각 실험의 비용 함수 값과 구로비(무료 버전)의 결과를 비교하여 최적화 효율성을 측정하는 값입니다.
- 샤프 비율은 각 포트폴리오의 위험 조정 수익률을 파악하여 솔루션의 재무 성과에 대한 인사이트를 제공합니다.
이러한 지표는 양자 생성 포트폴리오의 계산적 측면과 재무적 측면을 함께 벤치마킹합니다.
예 | 큐비트 | 답변 | 깊이 | 런타임 사용량(초) | 총 사용량(개) | 객관적 비용 | Sharpe | 구로비 객관적 비용 | 구로비 샤프 |
|---|---|---|---|---|---|---|---|---|---|
| 혼합 자산(1세트, 4시간 단계, 4비트) | 112 | 맞춤형 | 83 | 12735 | 13095 | -3.78 | 24.82 | -4.25 | 24.71 |
| 혼합 자산(1,4 타임스텝, 4 타임스텝, 4비트 설정) | 112 | 실제 진폭 | 359 | 11739 | 11903 | -3.39 | 23.64 | -4.25 | 24.71 |
| 오일 파생상품(2세트, 4단계, 3비트) | 84 | 최적화된 실제 진폭 | 78 | 6180 | 6350 | -3.73 | 19.13 | -4.19 | 21.71 |
| IBEX35 (설정 3, 4 시간 단계, 2비트) | 56 | 최적화된 실제 진폭 | 96 | 3314 | 3523 | -3.67 | 14.48 | -4.11 | 16.44 |
결과에 따르면 퀀텀 옵티마이저는 문제별 해법을 통해 다양한 포트폴리오 유형에서 효율적인 투자 전략을 효과적으로 식별하는 것으로 나타났습니다.
아래에서는 optimizer_options 사전에 지정된 인구 규모와 세대 수에 대해 자세히 설명합니다. 다른 모든 매개변수는 기본값으로 설정되었습니다.
예제 | population_size | num_generations |
|---|---|---|
| 혼합 자산 포트폴리오 | 90 | 20 |
| 혼합 자산 포트폴리오 | 92 | 20 |
| 석유 파생상품 포트폴리오 | 120 | 20 |
| IBEX35 포트폴리오 | 40 | 20 |
이 값은 수렴에 도달하기에 충분한 것으로 확인되었으므로 세대 수를 20으로 설정했습니다. 또한 최적화 도구의 내부 매개변수에 대한 기본값은 일관되게 우수한 성능을 제공하고 일반적으로 문헌 및 구현 가이드라인에서 권장하는 값이므로 변경하지 않았습니다.
지원 받기
도움이 필요하면 globaldataquantum.com qpo.support 이메일을 보내주세요. 메시지에서 함수 작업 ID를 입력합니다.
다음 단계
- 관련 연구 논문을 읽어보세요.
-
- 이 Qiskit 함수에 대한 API 참조 를 확인해 보세요.
- 이 양식을 작성하여 해당 기능에 대한 접근 권한을 요청하십시오.
- 동적 Portfolio Optimization 튜토리얼을 사용해 보세요.