Leistungsmanagement: Eine Qiskit-Funktion von Q-CTRL Fire Opal
Siehe API-Referenz
Qiskit-Funktionen sind eine experimentelle Funktion, die nur für Benutzer des IBM Quantum® Premium Plan, Flex Plan und On-Prem (über IBM Quantum Platform API) Plan verfügbar ist. Sie befinden sich im Status einer Vorabversion und können sich noch ändern.
Der Code auf dieser Seite wurde unter Berücksichtigung der folgenden Anforderungen entwickelt. Wir empfehlen die Verwendung dieser oder neuerer Versionen.
qiskit[all]~=2.3.1
qiskit-ibm-runtime~=0.45.1
Übersicht
Mit Fire Opal Performance Management kann jeder auf einfache Weise aussagekräftige Ergebnisse mit Quantencomputern im großen Maßstab erzielen, ohne Quantenhardware-Experte sein zu müssen. Bei der Ausführung von Schaltkreisen mit Fire Opal Performance Management werden automatisch KI-gesteuerte Fehlerunterdrückungstechniken angewendet, die die Skalierung größerer Probleme mit mehr Gattern und Qubits ermöglichen. Dieser Ansatz reduziert die Anzahl der für die richtige Antwort erforderlichen Schüsse ohne zusätzlichen Aufwand, was zu erheblichen Einsparungen bei Rechenzeit und Kosten führt.
Performance Management unterdrückt Fehler und erhöht die Wahrscheinlichkeit, dass die richtige Antwort auf verrauschter Hardware gefunden wird. Mit anderen Worten: Das Signal-Rausch-Verhältnis wird erhöht. Die folgende Abbildung zeigt, wie die durch das Leistungsmanagement ermöglichte erhöhte Genauigkeit im Falle eines 10-Qubit-Quanten-Fourier-Transformations-Algorithmus den Bedarf an zusätzlichen Aufnahmen verringern kann. Mit nur 30 Schüssen erreicht Q-CTRL die 99% Konfidenzschwelle, während die Standardeinstellung (QiskitRuntime Sampler, optimization_level=3 und resilience_level=1, ibm_sherbrooke) 170.000 Schüsse benötigt. Indem Sie schneller die richtige Antwort erhalten, sparen Sie erhebliche Rechenlaufzeit.


Die Funktion „Performance Management“ kann mit jedem beliebigen Algorithmus verwendet werden, und Sie können sie problemlos anstelle der Standardprimitive „ IBM Quantum “ einsetzen. Hinter den Kulissen arbeiten mehrere Techniken zur Fehlerunterdrückung zusammen, um Fehler während der Laufzeit zu verhindern. Alle Fire-Opal-Pipeline-Methoden sind vorkonfiguriert und algorithmunabhängig, sodass Sie von Anfang an stets die beste Leistung erzielen.
Um Zugang zum Leistungsmanagement zu erhalten, wenden Sie sich an Q-CTRL.
Beschreibung
Fire Opal Performance Management bietet zwei Ausführungsoptionen, die den Primitiven von „ IBM Quantum “ ähneln, sodass Sie den Q-CTRL-Sampler und den Estimator problemlos einbinden können. Der allgemeine Arbeitsablauf bei der Nutzung der Performance-Management-Funktion sieht wie folgt aus:
- Definieren Sie Ihre Schaltung (und Operatoren im Falle des Estimators).
- Betreiben Sie den Stromkreis.
- Rufen Sie die Ergebnisse ab.
Um das Hardware-Rauschen zu reduzieren, setzt Fire Opal eine Reihe von KI-gesteuerten Fehlerunterdrückungstechniken ein, die in der folgenden Abbildung dargestellt sind. Mit Fire Opal ist die gesamte Pipeline vollständig automatisiert und muss nicht konfiguriert werden.
Die Pipeline von Fire Opal macht zusätzlichen Overhead überflüssig, wie z. B. eine erhöhte Quantenlaufzeit oder zusätzliche physische Qubits. Beachten Sie, dass die klassische Verarbeitungszeit ein Faktor bleibt (Schätzungen finden Sie im Abschnitt " Benchmarks", wo die "Gesamtzeit" sowohl die klassische als auch die Quantenverarbeitung berücksichtigt). Im Gegensatz zur Fehlerbegrenzung, die einen Overhead in Form von Abtastung erfordert, arbeitet die Fehlerunterdrückung von Fire Opal sowohl auf der Gatter- als auch auf der Impulsebene, um verschiedene Rauschquellen zu beseitigen und die Wahrscheinlichkeit des Auftretens eines Fehlers zu verhindern. Durch die Vermeidung von Fehlern entfällt die Notwendigkeit einer teuren Nachbearbeitung.
Die folgende Abbildung zeigt die von Fire Opal Performance Management automatisierten Fehlerunterdrückungsmethoden.

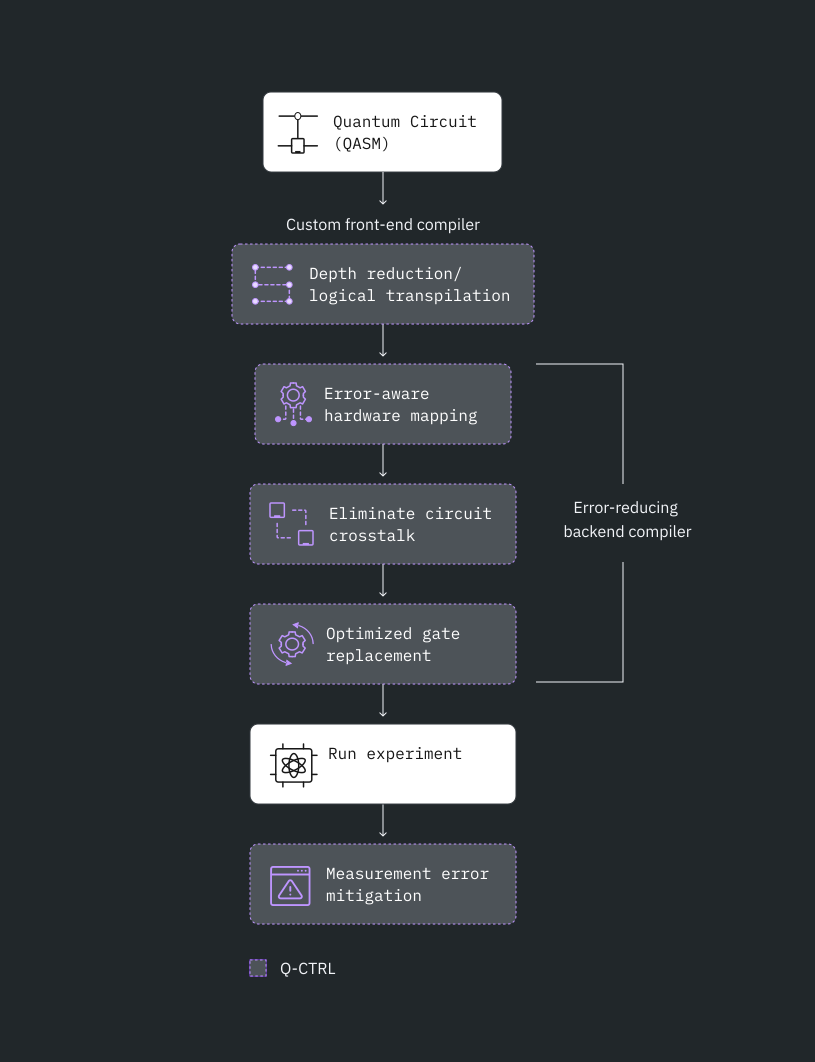
Die Funktion bietet zwei Primitive, „Sampler“ und „Estimator“, und die Ein- und Ausgänge beider Primitive erweitern die implementierte Spezifikation für die Primitive „ IBM Quantum “ V2.
Benchmarks
Veröffentlichte algorithmische Benchmarking-Ergebnisse zeigen eine signifikante Leistungsverbesserung bei verschiedenen Algorithmen, einschließlich Bernstein-Vazirani, Quanten-Fourier-Transformation, Grovers Suche, Quantenapproximations-Optimierungsalgorithmus und Variations-Quanten-Eigensolver. Im weiteren Verlauf dieses Abschnitts finden Sie weitere Einzelheiten über die Arten von Algorithmen, die Sie ausführen können, sowie über die erwartete Leistung und die Laufzeiten.
Die folgenden unabhängigen Studien zeigen, wie das Performance Management von Q-CTRL algorithmische Forschung in rekordverdächtigem Umfang ermöglicht:
- Parametrisierte energieeffiziente Quantenkernel für die Fehlerdiagnose bei Netzwerkdiensten - Lernen von Quantenkerneln mit bis zu 50 Qubits
- Tensor-basierte Quanten-Phasendifferenzschätzung für groß angelegte Demonstrationen - bis zu 33-Qubit-Quantenphasenschätzung
- Hierarchisches Lernen für Quanten-ML: Neuartige Trainingstechnik für groß angelegte Quanten-Variationsschaltungen - bis zu 21-Qubit-Quantum-Datenladung
Die folgende Tabelle gibt einen groben Anhaltspunkt über die Genauigkeit und die Laufzeiten aus früheren Benchmarking-Läufen auf ibm_fez. Die Leistung auf anderen Geräten kann variieren. Die Nutzungsdauer basiert auf der Annahme von 10.000 Schüssen pro Schaltkreis. Die angegebene "Anzahl der Qubits" ist keine harte Begrenzung, sondern stellt einen groben Schwellenwert dar, bei dem man eine extrem gleichmäßige Lösungsgenauigkeit erwarten kann. Größere Probleme wurden bereits erfolgreich gelöst, und es wird empfohlen, über diese Grenzen hinaus zu testen.
Beispiel | Anzahl der Qubits | Genauigkeit | Maß für die Genauigkeit | Gesamtzeit (S) | Laufzeitverbrauch (s) | Primitiv (Modus) |
|---|---|---|---|---|---|---|
| Bernstein-Vazirani | 50Q | 100 % | Erfolgsquote (Prozentsatz der Läufe, bei denen die richtige Antwort die höchste Zählbitfolge ist) | 10 | 8 | Stichprobenfunktion |
| Quanten-Fourier-Transformation | 30Q | 100 % | Erfolgsquote (Prozentsatz der Läufe, bei denen die richtige Antwort die höchste Zählbitfolge ist) | 10 | 8 | Stichprobenfunktion |
| Quanten-Phasenabschätzung | 30Q | 99.9998% | Genauigkeit des gefundenen Winkels: 1- abs(real_angle - angle_found)/pi | 10 | 8 | Stichprobenfunktion |
| Quantensimulation: Ising-Modell (15 Schritte) | 20Q | 99.775% | (unten definiert) | 60 (pro Stufe) | 15 (pro Stufe) | Schätzer |
| Quantensimulation 2: Molekulardynamik (20 Zeitpunkte) | 34Q | 96.78% | (unten definiert) | 10 (pro Zeitpunkt) | 6 (pro Zeitpunkt) | Schätzer |
Die Genauigkeit der Messung eines Erwartungswerts - die Metrik ist wie folgt definiert:
wobei = idealer Erwartungswert, = gemessener Erwartungswert, = idealer Maximalwert und = idealer Minimalwert. ist einfach der Durchschnitt des Wertes von über mehrere Messungen.
Diese Metrik wird verwendet, weil sie gegenüber globalen Verschiebungen und Skalierungen im Bereich der erreichbaren Werte unveränderlich ist. Mit anderen Worten: Unabhängig davon, ob Sie den Bereich der möglichen Erwartungswerte nach oben oder unten verschieben oder die Spanne vergrößern, sollte der Wert von konstant bleiben.
Erste Schritte
Fire Opal Performance Management verwendet Qiskit v2.0.0, die empfohlene Version. Unterstützte Versionen sind Qiskit >=v2.0.0.
Melden Sie sich mit Ihrem API-Schlüssel von „ IBM Quantum Platform “ an und wählen Sie die Qiskit-Funktion wie folgt aus. (In diesem Codeausschnitt wird davon ausgegangen, dass Sie Ihr Konto bereits in Ihrer lokalen Umgebung gespeichert haben.)
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# verify that you have access to the function
catalog.list()
Output:
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access Function
perf_mgmt = catalog.load("q-ctrl/performance-management")Wenn Sie ein Backend verwenden möchten, das diese Funktion derzeit nicht unterstützt, wenden Sie sich bitte an Q-CTRL, um die Unterstützung hinzuzufügen.
Primitive Schätzung
Beispiel für einen Schätzer
Verwenden Sie das Estimator-Primitiv von Fire Opal Performance Management, um den Erwartungswert eines einzelnen Paares aus Schaltkreisen und beobachtbaren Daten zu bestimmen.
Zusätzlich zu den Paketen qiskit-ibm-catalog und qiskit werden Sie auch das Paket numpy verwenden, um dieses Beispiel auszuführen. Sie können dieses Paket installieren, indem Sie die folgende Zelle auskommentieren, wenn Sie dieses Beispiel in einem Notebook ausführen, das den IPython-Kernel verwendet.
# %pip install numpy1. Erstellen Sie die Schaltung
Erzeugen Sie zum Beispiel einen zufälligen hermiteschen Operator und eine Beobachtungsgröße, die Sie in die Funktion Performance Management eingeben.
import numpy as np
from qiskit.circuit.library import iqp
from qiskit.quantum_info import random_hermitian, SparsePauliOp

n_qubits = 50

# Generate a random circuit
mat = np.real(random_hermitian(n_qubits, seed=1234))
circuit = iqp(mat)
circuit.measure_all()

# Define observables as a string
observable = SparsePauliOp("Z" * n_qubits)
# Create PUB tuple
estimator_pubs = [(circuit, observable)]2. Schalten Sie den Stromkreis
Führen Sie die Schaltung aus und legen Sie optional das Backend und die Anzahl der Schüsse fest.
# Run the circuit using Estimator
qctrl_estimator_job = perf_mgmt.run(
    primitive="estimator",
    pubs=estimator_pubs,
    backend_name=backend_name,
)
Sie können die bekannten „ Qiskit Serverless “-APIs verwenden, um den Status Ihrer Qiskit-Funktions-Workload zu überprüfen:
qctrl_estimator_job.status()Output:
'QUEUED'
3. Abrufen des Ergebnisses
# Retrieve the counts from the result list
result = qctrl_estimator_job.result()
Die Ergebnisse haben dasselbe Format wie ein Estimator-Ergebnis :
import numpy

result_str = str(result)

with numpy.printoptions(threshold=200):
    print(
        f"The result of the submitted job had {len(result)} PUB "
        f"and has a value:\n {result[0]}\n"
    )

print("The associated PubResult of this job has the following DataBins:")
print(f"{result[0].data}\n")

print(f"And this DataBin has attributes: {result[0].data.keys()}")

print("The expectation values measured from this PUB are:")
print(f"{result[0].data.evs}")
Output:
The result of the submitted job had 1 PUB
The result of the submitted job had 1 PUB and has a value:
 PubResult(data=DataBin(evs=0.0195, stds=0.9998098569228051), metadata={'precision': None})

The associated PubResult of this job has the following DataBins:
DataBin(evs=0.0195, stds=0.9998098569228051)

And this DataBin has attributes: dict_keys(['evs', 'stds'])
The expectation values measured from this PUB are:
0.0195
Sampler-Primitive
Beispiel für einen Sampler
Verwenden Sie das Sampler-Primitiv von Fire Opal Performance Management, um eine Bernstein-Vazirani-Schaltung auszuführen. Dieser Algorithmus, mit dem eine versteckte Zeichenkette aus den Ausgaben einer Blackbox-Funktion gefunden werden soll, ist ein gängiger Benchmarking-Algorithmus, da es nur eine einzige richtige Antwort gibt.
1. Erstellen Sie die Schaltung
Definieren Sie die richtige Antwort auf den Algorithmus, die versteckte Bitfolge und die Bernstein-Vazirani-Schaltung. Sie können die Breite der Schaltung anpassen, indem Sie einfach die circuit_width ändern.
import qiskit

circuit_width = 35
hidden_bitstring = "1" * circuit_width

# Create circuit, reserving one qubit for BV oracle
bv_circuit = qiskit.QuantumCircuit(circuit_width + 1, circuit_width)
bv_circuit.x(circuit_width)
bv_circuit.h(range(circuit_width + 1))
for input_qubit, bit in enumerate(reversed(hidden_bitstring)):
    if bit == "1":
        bv_circuit.cx(input_qubit, circuit_width)
bv_circuit.barrier()
bv_circuit.h(range(circuit_width + 1))
bv_circuit.barrier()
for input_qubit in range(circuit_width):
    bv_circuit.measure(input_qubit, input_qubit)

# Create PUB tuple
sampler_pubs = [(bv_circuit,)]
2. Schalten Sie den Stromkreis
Führen Sie die Schaltung aus und legen Sie optional das Backend und die Anzahl der Schüsse fest.
# Run the circuit using Sampler
qctrl_sampler_job = perf_mgmt.run(
    primitive="sampler",
    pubs=sampler_pubs,
    backend_name=backend_name,
)
Überprüfen Sie den Status Ihrer Qiskit-Funktions-Workload oder rufen Sie die Ergebnisse wie folgt ab:
# Print the ID so you can use it later, if necessary
print(qctrl_sampler_job.job_id)

qctrl_sampler_job.status()
Output:
60fe2fa1-a860-43e4-8615-c6ac4180f93b
'QUEUED'
3. Abrufen des Ergebnisses
# Retrieve the job results
sampler_result = qctrl_sampler_job.result()
# Get results for the first (and only) PUB
pub_result = sampler_result[0]
counts = pub_result.data.c.get_counts()
print("Counts for the meas output register (limited to 30 results):")
for i, (bitstring, count) in enumerate(counts.items()):
if i >= 50:
print(f" ... ({len(counts) - 30} more items)")
break
print(f" {bitstring}: {count}")Output:
Counts for the meas output register (limited to 30 results):
  11111111111111111111111111111111111: 1661
  11111111111111111111111111110111111: 60
  11111111111111111111111111111101111: 54
  11111111111111111111111111111110111: 54
  11111111111111011111111111111111111: 46
  11111111111111111110111111111111111: 44
  11111111111111111111111101111111111: 42
  11111111111111111111111110111111111: 42
  11111111111111110111111111111111111: 41
  11111111111111111111111111111111101: 39
  11111111111111111111101111111111111: 38
  11111111111111111111110111111111111: 38
  11111111111111111111111111101111111: 37
  11111111111111111111111111111111110: 36
  11111111111110111111111111111111111: 35
  11111111111111111111111111111011111: 32
  11111111111111101111111111111111111: 32
  01111111111111111111111111111111111: 27
  11111111111111111011111111111111111: 23
  11111111101111111111111111111111111: 22
  11111111111111111111111111111111011: 21
  11111111011111111111111111111111111: 20
  00000000000000011111111111111111111: 18
  11111111111111111111110101111111111: 18
  00000001111111111111111111111111111: 17
  11111111001111111111111111111111111: 16
  11101111111111111111111111111111111: 16
  11111111111101111111111111111111111: 16
  00000101111111111111111111111111111: 13
  11111111111111111111111011111111111: 13
  11111111111111111111111110101111111: 13
  11111111111111111101111111111111111: 12
  10111111111111111111111111111111111: 12
  11111111111111111111111110001111111: 12
  00000000000000000011111111111111111: 11
  11111111111111111111111111111110110: 10
  00000000000000000000000001111111111: 10
  11111111111011111111111111111111111: 9
  11111111111111101011111111111111111: 9
  00000000011111111111111111111111111: 8
  10101111111111111111111111111111111: 8
  00000000000000000000000001011111111: 8
  11111111111111111111111111111111001: 8
  00000111111111111111111111111111111: 7
  11111111111111111111111111111101110: 7
  11111111110111111111111111111111111: 7
  00000000000001011111111111111111111: 6
  00000000000000001111111111111111111: 6
  00000000000000000001011111111111111: 6
  11111111111111111111111111011111111: 6
  ... (1050 more items)
3. Zeichnen Sie die obersten Bitstrings
Zeichnen Sie die Bitfolge mit den höchsten Zählwerten auf, um festzustellen, ob die versteckte Bitfolge der Modus war.
import matplotlib.pyplot as plt


def plot_top_bitstrings(counts_dict, hidden_bitstring=None):
    # Sort and take the top 100 bitstrings
    top_100 = sorted(counts_dict.items(), key=lambda x: x[1], reverse=True)[
        :100
    ]
    if not top_100:
        print("No bitstrings found in the input dictionary.")
        return

    # Unzip the bitstrings and their counts
    bitstrings, counts = zip(*top_100)

    # Assign colors: purple if the bitstring matches hidden_bitstring,
    # otherwise gray
    colors = [
        "#680CE9" if bit == hidden_bitstring else "gray" for bit in bitstrings
    ]

    # Create the bar plot
    plt.figure(figsize=(15, 8))
    plt.bar(
        range(len(bitstrings)), counts, tick_label=bitstrings, color=colors
    )

    # Rotate the bitstrings for better readability
    plt.xticks(rotation=90, fontsize=8)
    plt.xlabel("Bitstrings")
    plt.ylabel("Counts")
    plt.title("Top 100 Bitstrings by Counts")

    # Show the plot
    plt.tight_layout()
    plt.show()
Die verborgene Bitfolge ist violett hervorgehoben und sollte die Bitfolge mit der höchsten Anzahl von Zählungen sein.
plot_top_bitstrings(counts, hidden_bitstring)Output:

Änderungsprotokoll
- 2026-02-20: Hinweis zur Abkündigung – Das
provider_job_idsMetadatenfeld wird in 30 Tagen in Version 0.13.0 abgekündigt. Benutzer können überjob_id()die Methode des Laufzeitdienstes auf die Job-ID zugreifen. - 11.02.2026: Wir bieten nun Unterstützung für
ibm_miamiund haben Ausführungsmetadaten zumPubResulthinzugefügt.
Unterstützung anfordern
Bei Fragen oder Problemen wenden Sie sich bitte an Q-CTRL.
Nächste Schritte
- Beantragen Sie Zugriff auf Q-CTRL Performance Management.
- Rufen Sie die API-Referenz für diese Qiskit-Funktion auf.
- Probieren Sie das Transverse-Field-Ising-Modell mit dem Tutorial „Leistungsmanagement“ von Q-CTRL aus.
- Probieren Sie die Quantenphasenabschätzung mit dem Tutorial „ Qiskit Functions ” von Q-CTRL aus
- Rezension Mundada P. S., et al. (2023). Experimentelles Benchmarking eines automatisierten deterministischen Fehlerunterdrückungs-Workflows für Quantenalgorithmen. Physical Review Applied, 20, 2.
- Rezension Kanno, S., et al. (2025). Tensorbasierte Quantephasendifferenzschätzung für groß angelegte Demonstrationen. arXiv Vorabdruck arXiv:2408.04946.
- Rezension SoftBank Corp, Demonstrationsexperiment eines Kommunikationsdienst-Fehlerdiagnosesystems unter Verwendung von Quanten- Machine Learning us (Blog), 30. August 2024.
- Rezension Yamauchi, H., et al. (2024). Parametrisierte energieeffiziente Quantenkernel für die Fehlerdiagnose von Netzwerkdiensten. arXiv Vorabdruck arXiv:2405.09724v1.
- Rezension Yamauchi, H., et al. (2025). Quantenspektroskopie der topologischen Dynamik mittels eines supersymmetrischen Hamilton-Operators. arXiv Vorabdruck arXiv:2511.23169v1.
- Rezension Wang, Y., et al. (2025). Δ-Motiv: Subgraph-Isomorphismus in großem Maßstab durch datenzentrierte Parallelität. arXiv Vorabdruck arXiv:2508.21287.
- Rezension Paterakis, N. G., et al. (2025). Quantencomputing in der Rechenlandschaft der Leistungselektronik: Vision und Realität. arXiv Vorabdruck arXiv:2507.02577.
- Rezension Gharibyan, H., et al. (2023). Hierarchisches Lernen für Quanten-ML: Neuartige Trainingstechnik für groß angelegte variationale Quantenschaltungen. arXiv Vorabdruck arXiv:2311.12929.
- Lesen Sie die Fallstudie zu Mitsubishi Chemical Corp.
- Lesen Sie die Fallstudie zur Bank Redacted.
- Lesen Sie die Fallstudie „ BlueQubit “.