Quantum-Kernel-Training
Geschätzte Laufzeit: weniger als eine Minute auf einem Heron- r3 -Prozessor (HINWEIS: Dies ist lediglich eine Schätzung. (Die Laufzeit kann variieren.)
Lernziele
- Kernel-Methoden und ihre Anwendungsbereiche
- Quantenkerne und wie sie verbesserte Merkmalsräume bieten können
- Aufbau von Quantenkern-Schaltungen
- So trainiert man einen Quantenkernel mit einem Qiskit-Muster : Zuordnen, Optimieren, Ausführen und Nachbearbeiten
Voraussetzungen
- Quantenkerne: Warum sie wichtig sind und wie sie in der Praxis eingesetzt werden
- Kovarianten-Quantenkerne für Daten mit Gruppenstruktur (Artikel)
- Einführung in Quantenkerne und Support-Vektor-Maschinen (Video)
- Quantenkerne in der Praxis (Video)
Es ist außerdem hilfreich, über Grundkenntnisse in der Gruppentheorie zu verfügen.
Hintergrund
Kernel-Verfahren sind in Anwendungen des maschinellen Lernens weit verbreitet. In diesem Zusammenhang bezieht sich „Kernel“ auf die Kernel-Matrix oder einzelne Einträge darin. Allgemein gesagt ist ein Kernel ein Ähnlichkeitsmaß zwischen Daten, die in einem hochdimensionalen Merkmalsraum kodiert sind, und kann beispielsweise bei Klassifizierungsaufgaben mit Support-Vektor-Maschinen eingesetzt werden.
Quantenkernel-Methoden sind solche, bei denen Quantencomputer zur Schätzung eines Kernels eingesetzt werden. Es ist bekannt, dass Quantencomputer Daten in quantenverstärkten Merkmalsräumen kodieren können und damit klassische Entsprechungen effektiv ersetzen. Für und , typischerweise mit , ist eine Merkmalskarte, . Das Ziel von ist es, Datenkategorien durch eine Hyperfläche voneinander zu trennen. Nimmt man die Vektoren im Merkmalsabbildungsraum als Argumente, so liefert die Kernel-Funktions ihr Skalarprodukt: . Klassischerweise sind diejenigen Merkmalsabbildungen von Interesse, bei denen die Kernel-Funktion leicht berechnet werden kann; das heißt, wenn das Skalarprodukt im Merkmalsabbildungsraum in Bezug auf die ursprünglichen Datenvektoren ausgedrückt werden kann und sowie nicht konstruiert werden müssen. Bei Quantenkerneln erfolgt die Merkmalsabbildung durch einen Quantenschaltkreis, und der Kernel wird anhand der aus dem Schaltkreis abgetasteten Messwahrscheinlichkeiten geschätzt.
Dieses Tutorial zeigt, wie man ein Qiskit-Muster erstellt, um Einträge in einer Quantenkernel-Matrix zu bewerten, die für die binäre Klassifizierung verwendet wird.
Anforderungen
Bevor Sie mit diesem Tutorial beginnen, sollten Sie sicherstellen, dass Sie Folgendes installiert haben:
- Qiskit SDK v2.3.1 oder höher, mit Visual isierungsunterstützung
- Qiskit Runtime v0.44.0 oder später (
pip install qiskit-ibm-runtime)
Einrichtung
# General Imports and helper functions
import urllib.request

import pandas as pd
import numpy as np
import matplotlib.pyplot as plt


from qiskit.circuit import Parameter, ParameterVector, QuantumCircuit
from qiskit.circuit.library import unitary_overlap
from qiskit.primitives import StatevectorSampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService, Sampler

# Download the dataset (portable across platforms)
urllib.request.urlretrieve(
    "https://raw.githubusercontent.com/qiskit-community/prototype-quantum-kernel-training/main/data/dataset_graph7.csv",
    "dataset_graph7.csv",
)


def visualize_counts(res_counts, num_qubits, num_shots):
    """Visualize the outputs from the Qiskit Sampler primitive."""
    zero_prob = res_counts.get(0, 0.0)
    top_10 = dict(
        sorted(res_counts.items(), key=lambda item: item[1], reverse=True)[
            :10
        ]
    )
    top_10.update({0: zero_prob})
    by_key = dict(sorted(top_10.items(), key=lambda item: item[0]))
    x_vals, y_vals = list(zip(*by_key.items()))
    x_vals = [bin(x_val)[2:].zfill(num_qubits) for x_val in x_vals]
    y_vals_prob = []
    for t in range(len(y_vals)):
        y_vals_prob.append(y_vals[t] / num_shots)
    y_vals = y_vals_prob
    plt.bar(x_vals, y_vals)
    plt.xticks(rotation=75)
    plt.title("Results of sampling")
    plt.xlabel("Measured bitstring")
    plt.ylabel("Probability")
    plt.show()


def get_training_data():
    """Read the training data."""
    df = pd.read_csv("dataset_graph7.csv", sep=",", header=None)
    training_data = df.values[:20, :]
    ind = np.argsort(training_data[:, -1])
    X_train = training_data[ind][:, :-1]

    return X_train
Beispiel für einen Simulator im kleinen Maßstab
In diesem Abschnitt gehen wir die vier Schritte des Qiskit-Musters anhand einer 7-Qubit-Instanz des Problems „Labeling Cosets with Error“ durch und berechnen einen einzelnen Eintrag der Kernel-Matrix unter Verwendung der StatevectorSampler Primitive aus Qiskit. Ein Zustandsvektor-Simulator ist (abgesehen vom Schrotrauschen) exakt und veranschaulicht uns die Methode von Anfang bis Ende, ohne QPU-Zeit zu beanspruchen. Im Abschnitt „Hardware-Beispiele“ wiederholen wir dann denselben Vorgang auf echter Hardware.
Schritt 1: Klassische Eingaben einem Quantenproblem zuordnen
- Eingabe: Trainingsdatensatz.
- Ausgabe: Abstrakte Schaltung zur Berechnung eines Kernelmatrixeintrags.
Das Problem der binären Klassifizierung, das wir hier lösen wollen, wird als „Fehlerbehaftete Klassifizierung von Nebenklassen “ bezeichnet Der Eingabedatensatz für das Training enthält eine Gruppenstruktur, die aus zwei Nebenklassen besteht, die durch eine Gruppe und eine Untergruppe gebildet werden. Als Gruppe wird für Qubits die Gruppe angenommen, die die spezielle unitäre Gruppe der Matrizen der Form darstellt und in der Natur weit verbreitet ist, z. B. im Standardmodell der Teilchenphysik. Wir betrachten die (Graph-Stabilisator-)Untergruppe mit für einen Graphen mit Kanten und Knoten . Beachte, dass die Stabilisatoren einen Stabilisatorzustand festlegen, sodass gilt. Schließlich definieren wir zwei linke Nebenklassen , indem wir zufällig zwei auswählen.
Weitere Informationen zum Datensatz und zu seiner Erstellung finden Sie in diesem Notebook aus dem Quantum Kernel Training Toolkit.
Wir erstellen den Quantenschaltkreis, mit dem ein Eintrag in der Kernel-Matrix ausgewertet wird.
Die Eingabedaten dienen zur Bestimmung der Drehwinkel für die parametrisierten Gatter der Schaltung.
Der Einfachheit halber verwenden wir die Stichproben x1=14 und x2=19.
Hinweis: Der in diesem Lernprogramm verwendete Datensatz kann hier heruntergeladen werden.
# Prepare training data
X_train = get_training_data()

# Empty kernel matrix
num_samples = np.shape(X_train)[0]
kernel_matrix = np.full((num_samples, num_samples), np.nan)

# Prepare feature map for computing overlap
num_features = np.shape(X_train)[1]
num_qubits = int(num_features / 2)
entangler_map = [[0, 2], [3, 4], [2, 5], [1, 4], [2, 3], [4, 6]]
fm = QuantumCircuit(num_qubits)
training_param = Parameter("θ")
feature_params = ParameterVector("x", num_qubits * 2)
fm.ry(training_param, fm.qubits)
for cz in entangler_map:
    fm.cz(cz[0], cz[1])
for i in range(num_qubits):
    fm.rz(-2 * feature_params[2 * i + 1], i)
    fm.rx(-2 * feature_params[2 * i], i)

# Assign tunable parameter to known optimal value and set the data params for
# first two samples
x1 = 14
x2 = 19
unitary1 = fm.assign_parameters(list(X_train[x1]) + [np.pi / 2])
unitary2 = fm.assign_parameters(list(X_train[x2]) + [np.pi / 2])

# Create the overlap circuit
overlap_circ = unitary_overlap(unitary1, unitary2)
overlap_circ.measure_all()
overlap_circ.draw("mpl", scale=0.6, style="iqp")
Output:

Schritt 2: Optimierung des Problems für die Ausführung auf Quantenhardware
- Eingabe: Abstrakte Schaltung, nicht für ein bestimmtes Backend optimiert.
- Ergebnis: Zielschaltung, optimiert für die ausgewählte QPU.
Für den in diesem Abschnitt verwendeten Statevector-Simulatorpfad ist keine backend-spezifische Optimierung erforderlich: Die abstrakte Schaltung kann direkt abgetastet werden. optimization_level=3Wir wenden diesen Schritt im folgenden Hardware-Beispiel an, bei dem die Schaltung mithilfe von generate_preset_pass_manager mit für eine echte QPU transpiliert wird.
Schritt 3: Mit „ Qiskit primitives “ ausführen
- Eingabe: Abstrakte Schaltung.
- Ergebnis: Quasi-Wahrscheinlichkeitsverteilung.
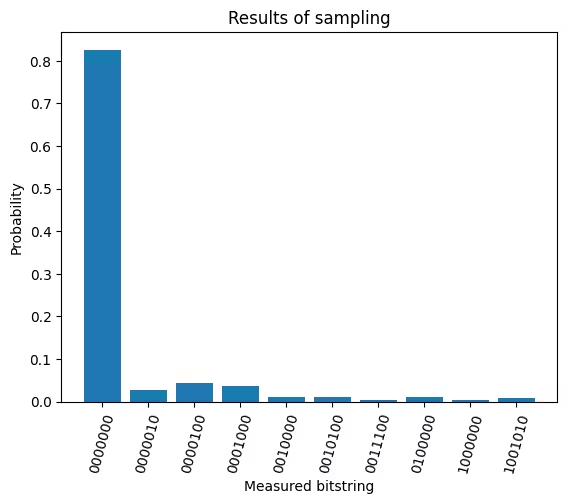
Verwenden Sie die StatevectorSampler Primitive aus Qiskit, um eine Quasi-Wahrscheinlichkeitsverteilung der Zustände zu rekonstruieren, die sich aus der Stichprobenentnahme aus dem Schaltkreis ergeben. Bei der Erstellung einer Kernelmatrix interessiert uns insbesondere die Wahrscheinlichkeit, den |0>-Zustand zu messen.
sampler = StatevectorSampler()

# Execute and get counts
num_shots = 10_000
results = sampler.run([overlap_circ], shots=num_shots).result()
counts = results[0].data.meas.get_int_counts()

# Plot counts
visualize_counts(counts, num_qubits, num_shots)
Output:
Schritt 4: Nachbearbeitung und Rückgabe des Ergebnisses im gewünschten klassischen Format
- Eingabe: Wahrscheinlichkeitsverteilung.
- Ausgabe: Ein einzelnes Element der Kernelmatrix.
Berechne die Wahrscheinlichkeit, dass auf dem Überlappungskreis der Wert gemessen wird, und trage die Kernelmatrix an der Stelle ein, die den durch diesen bestimmten Überlappungskreis dargestellten Messwerten entspricht (Zeile 15, Spalte 20).
kernel_matrix[x1, x2] = counts.get(0, 0.0) / num_shots
print(f"Fidelity (simulator): {kernel_matrix[x1, x2]}")
Output:
Fidelity (simulator): 0.8261
Beispiel für Hardware
Eine Quantenkernel-Matrix hat Einträge für Trainingsbeispiele, und jeder Eintrag erfordert die Ausführung einer Überlappungsschaltung, deren Tiefe an Zwei-Qubit-Gates mit der Größe der Merkmalskarte zunimmt. Folglich sind bei der Skalierung dieses Tutorials auf ein größeres Problem zwei sich verstärkende Kostenfaktoren zu berücksichtigen: Die QPU-Zeit pro Kernel-Matrix wächst quadratisch mit , und die Tiefe von unitary_overlap (die die Merkmalskarte mit ihrer Adjunkten vermischt) beeinträchtigt die Genauigkeit bei der Systemgröße und Konnektivität aktueller Hardware. Um die Demo kurz zu halten und einen sauberen Vergleich zu ermöglichen, führen wir daher dieselbe 7-Qubit-Instanz aus dem Beispiel im kleinen Maßstab auf einer echten QPU aus und vergleichen die Genauigkeit eines einzelnen Eintrags in der Kernel-Matrix mit dem oben berechneten Simulatorwert.
# ------------------------------ Step 1 ------------------------------
# Prepare training data
X_train = get_training_data()

# Empty kernel matrix
num_samples = np.shape(X_train)[0]
kernel_matrix = np.full((num_samples, num_samples), np.nan)

# Prepare feature map for computing overlap
num_features = np.shape(X_train)[1]
num_qubits = int(num_features / 2)
entangler_map = [[0, 2], [3, 4], [2, 5], [1, 4], [2, 3], [4, 6]]
fm = QuantumCircuit(num_qubits)
training_param = Parameter("θ")
feature_params = ParameterVector("x", num_qubits * 2)
fm.ry(training_param, fm.qubits)
for cz in entangler_map:
    fm.cz(cz[0], cz[1])
for i in range(num_qubits):
    fm.rz(-2 * feature_params[2 * i + 1], i)
    fm.rx(-2 * feature_params[2 * i], i)

# Assign tunable parameter to known optimal value and
# set the data params for first two samples
x1 = 14
x2 = 19
unitary1 = fm.assign_parameters(list(X_train[x1]) + [np.pi / 2])
unitary2 = fm.assign_parameters(list(X_train[x2]) + [np.pi / 2])

# Create the overlap circuit
overlap_circ = unitary_overlap(unitary1, unitary2)
overlap_circ.measure_all()

# ------------------------------ Step 2 ------------------------------
service = QiskitRuntimeService()
# backend = service.least_busy(
#    operational=True, simulator=False, min_num_qubits=overlap_circ.num_qubits
# )
backend = service.backend("ibm_pittsburgh")
print(f"Using backend: {backend.name}")
pm = generate_preset_pass_manager(optimization_level=3, backend=backend)
overlap_ibm = pm.run(overlap_circ)

# ------------------------------ Step 3 ------------------------------
sampler = Sampler(mode=backend)
sampler.options.environment.job_tags = ["TUT_QKT"]

num_shots = 10_000
results = sampler.run([overlap_ibm], shots=num_shots).result()
counts = results[0].data.meas.get_int_counts()
visualize_counts(counts, num_qubits, num_shots)

# ------------------------------ Step 4 ------------------------------
kernel_matrix[x1, x2] = counts.get(0, 0.0) / num_shots
print(f"Fidelity (hardware): {kernel_matrix[x1, x2]}")
Output:
Using backend: ibm_pittsburgh

Fidelity (hardware): 0.7517
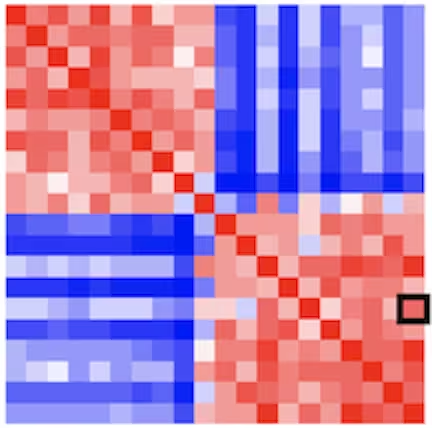
Um die gesamte Kernelmatrix auszufüllen, müssten wir für jeden ihrer eindeutigen Einträge ein Quantenexperiment durchführen. Die folgende Abbildung zeigt die resultierende Matrix für diesen Datensatz; ein dunkleres Rot steht für Übereinstimmungen, die näher an 1.0 liegen.
Nächste Schritte
Wenn Sie diese Arbeit interessant fanden, könnten Sie auch an folgenden Materialien interessiert sein:
- Quantum Kernel Training Toolkit – das Prototyp-Repository, auf dem dieses Tutorial basiert
- Quantum-Kernel-Training für „ Machine Learning “-Anwendungen – ein Qiskit- Machine Learning -Tutorial, das zeigt, wie man den trainierbaren Parameter trainiert
- Einführung in das Quanten- Machine Learning – ein Kurs zum maschinellen Lernen im Quantenbereich
- Quanten Machine Learning us von IBM Research – ein Überblick über die QML-Forschung unter IBM
- Kovarianten-Quantenkerne für Daten mit Gruppenstruktur – der Artikel, auf dem dieses Tutorial basiert