Krylov-Quanten-Diagonalisierung von Gitter-Hamilton-Operatoren
Geschätzte Laufzeit: 70 Minuten auf einem Heron- oder Nighthawk-Prozessor (HINWEIS: Dies ist lediglich eine Schätzung. (Die Laufzeit kann variieren.)
Lernziele
- Wie lässt sich die Krylov-Quanten-Diagonalisierung (KQD) als das Erlernen einer endlichen Hamilton-Funktion interpretieren, die als Spektralfilter fungiert?
- Wie man die projizierten Hamilton- und Überlappungsmatrizen mithilfe erweiterter Swap-Test-Messungen erstellt.
- Wie lässt sich das daraus resultierende verallgemeinerte Eigenwertproblem (GEVP) lösen und eine Schätzung der Grundzustandsenergie für einen Gitter-Hamilton-Operator ermitteln?
Voraussetzungen
- Qiskit primitives
- Schätzung der Grundzustandsenergie der Heisenberg-Kette mit VQE
- Kurs zu Algorithmen zur Quantendiagonalisierung
Hintergrund
Dieses Tutorial zeigt, wie man den Krylov-Quanten-Diagonalisierungsalgorithmus (KQD) im Rahmen von Qiskit-Patterns implementiert. Zunächst lernen Sie die Theorie hinter dem Algorithmus kennen und sehen anschließend eine Demonstration seiner Ausführung auf einer QPU.
Die Abschätzung der Eigenschaften von Vielteilchen-Hamilton-Operatoren im Niedrigenergiebereich ist eine zentrale Aufgabe der Quantensimulation. So stehen beispielsweise Grundzustandsenergien und niedrigliegende Anregungen in direktem Zusammenhang mit der chemischen Stabilität, der magnetischen Ordnung, Quantenphasenübergängen und dem Materialverhalten. Auf einem klassischen Computer wächst die Dimension des Hilbert-Raums exponentiell mit der Anzahl der Orbitalen oder Spins, sodass eine direkte Diagonalisierung schnell unpraktikabel wird.
Für dieses Problem gibt es mehrere Ansätze im Bereich des Quantencomputings. Kurzfristige Variationsmethoden wie der Variational Quantum Eigensolver (VQE) verwenden relativ flache parametrisierte Schaltkreise, erfordern jedoch eine nichtlineare klassische Optimierungsschleife mit zahlreichen Auswertungen der Quantenschaltkreise. Auf der anderen Seite bietet die Quantenphasenschätzung (QPE) einen direkteren Weg zur Eigenwertschätzung mit strengen Garantien, doch die Standard-QPE erfordert lange kohärente Schaltkreise und eignet sich vor allem für fehlertolerante Quantencomputer. KQD liegt zwischen diesen beiden Ansätzen: Es nutzt die Hamilton-Evolution in Echtzeit, wie bei Algorithmen auf Basis der Phasenschätzung, ersetzt jedoch die vollständige Phasenschätzung durch ein kompaktes projiziertes Eigenwertproblem, das klassisch gelöst werden kann.
Betrachten wir einen -Qubit-Hamilton-Operator und einen Referenzzustand . Die KQD-Methode erstellt einen Krylov-Unterraum aus in Echtzeit entwickelten Zuständen,
wobei die Krylov-Dimension und der Zeitschritt ist. Jeder Zustand im Krylov-Unterraum lässt sich dann als Linearkombination dieser Basiszustände darstellen,
wobei der Nenner den Zustand normiert.
Mit einfacher Algebra lässt sich zeigen, dass die entsprechende Energie als Rayleigh-Quotient ausgedrückt wird:
Hier sind die Matrizen und ,
Definieren Sie die projizierte Überlappungsmatrix und die Hamilton-Matrix. Ihre Einträge werden anhand von Messungen an Quantenschaltungen geschätzt.
Wir möchten den Koeffizienten ermitteln, der das Minimum liefert:
Nach dem Rayleigh-Ritz-Satz entspricht diese Minimierung der Lösung des verallgemeinerten Eigenwertproblems (GEVP),
Beachten Sie, dass die Dimension klein genug sein kann, damit ein klassischer Computer das GEVP lösen kann.
Es handelt sich um dasselbe Variationsprinzip, das auch bei der klassischen Unterraumdiagonalisierung zum Einsatz kommt, doch hier werden die Basiszustände durch die Quantenzeitentwicklung erzeugt. Im Vergleich zu VQE erfordert KQD in der Regel tiefere Schaltkreise, da es auf Echtzeit-Entwicklung basiert. Im Gegenzug vermeidet KQD die nichtlineare Parameteroptimierung und die iterative Ausführung auf Quantenhardware und verbessert sich systematisch mit zunehmender Größe des projizierten Unterraums. Der Algorithmus wurde in großem Maßstab auf bestehender Quantenhardware demonstriert [2], und seine Leistungsfähigkeit lässt sich mit nachweisbaren Garantien analysieren [1].
Anforderungen
Bevor Sie mit dieser Anleitung beginnen, stellen Sie bitte sicher, dass folgende Komponenten installiert sind:
- Qiskit SDK v2.3 oder höher mit Visualisierungsunterstützung
- Qiskit Runtime v0.22 oder höher (
pip install qiskit-ibm-runtime) - SciPy (
pip install scipy) - Matplotlib (
pip install matplotlib) - Pandas (
pip install pandas)
Für die Ausführung auf der Hardware sind qiskit-ibm-runtime sowie der Zugriff auf ein „ IBM Quantum® “-Konto erforderlich.
Einrichtung
Die Setup-Zelle importiert die erforderlichen Module und definiert Hilfsfunktionen für den Workflow:
- den Heisenberg-Hamilton-Operator aufstellen;
- das GEVP mit Schwellenwert lösen;
- den trainierten Krylov-Filter auswerten;
- Filterwerte in spektrale Gewichte umwandeln;
- Stellen Sie die Referenz- und die gefilterten Energieverteilungen grafisch dar.
from __future__ import annotations

import warnings

import numpy as np
import pandas as pd
import scipy.linalg as la
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit, transpile
from qiskit.circuit import Parameter
from qiskit.circuit.library import PauliEvolutionGate
from qiskit.primitives import StatevectorEstimator
from qiskit.quantum_info import Operator, SparsePauliOp
from qiskit.synthesis import LieTrotter, SuzukiTrotter
from qiskit.transpiler import PassManager, Layout
from qiskit.transpiler.passes import CommutativeOptimization
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Batch
from qiskit_ibm_runtime.fake_provider import FakeMarrakesh

warnings.filterwarnings("ignore")


def make_heisenberg_hamiltonian(
    num_qubits: int,
    coupling: float = 1.0,
) -> SparsePauliOp:
    """Make a Heisenberg Hamiltonian for a 1D chain of qubits with nearest-neighbor interactions."""
    terms: list[tuple[str, complex]] = []

    def append_term(q0: int, q1: int, pauli: str):
        label = ["I"] * num_qubits
        label[num_qubits - 1 - q0] = pauli[0]
        label[num_qubits - 1 - q1] = pauli[1]
        terms.append(("".join(label), coupling))

    for pauli in ("XX", "YY", "ZZ"):
        for q in range(num_qubits - 1):
            append_term(q, q + 1, pauli)
    return SparsePauliOp.from_list(terms).simplify()


def _basis_state_transition_amplitude_sparse(
    hamiltonian: SparsePauliOp,
    bra_state: int,
    ket_state: int,
) -> complex:
    """Evaluate <bra_state|H|ket_state> for computational-basis states."""
    num_qubits = hamiltonian.num_qubits
    amplitude = 0.0 + 0.0j
    for pauli, coeff in zip(hamiltonian.paulis, hamiltonian.coeffs):
        new_state = ket_state
        phase = 1.0 + 0.0j
        for q in range(num_qubits):
            x = bool(pauli.x[q])
            z = bool(pauli.z[q])
            if not x and not z:
                continue
            bit = (new_state >> q) & 1
            if x and z:
                # Y|0> = i|1>, Y|1> = -i|0>
                phase *= 1j if bit == 0 else -1j
                new_state ^= 1 << q
            elif x:
                new_state ^= 1 << q
            else:
                # Z|0> = |0>, Z|1> = -|1>
                if bit:
                    phase *= -1
        if new_state == bra_state:
            amplitude += coeff * phase
    return amplitude


def basis_state_expectation_sparse(
    hamiltonian: SparsePauliOp,
    bitstring: str,
) -> complex:
    """Evaluate <bitstring|H|bitstring>."""
    state = int(bitstring, 2)
    return _basis_state_transition_amplitude_sparse(
        hamiltonian,
        bra_state=state,
        ket_state=state,
    )


def diagonalize_single_1_subspace(
    hamiltonian: SparsePauliOp,
) -> np.ndarray:
    """Diagonalize the Hamiltonian projected onto the single-excitation subspace."""
    num_qubits = hamiltonian.num_qubits

    # Integer basis states |...010...>, with the excitation at qubit k.
    basis = [1 << k for k in range(num_qubits)]

    h_single = np.empty((num_qubits, num_qubits), dtype=complex)

    for row, bra_state in enumerate(basis):
        for col, ket_state in enumerate(basis):
            h_single[row, col] = _basis_state_transition_amplitude_sparse(
                hamiltonian,
                bra_state=bra_state,
                ket_state=ket_state,
            )
    # Remove floating-point-level asymmetry.
    h_single = 0.5 * (h_single + h_single.conj().T)
    evals, _ = np.linalg.eigh(h_single)
    return np.real(evals)


def simple_transpilation(circuit: QuantumCircuit) -> QuantumCircuit:
    """Transpilation to simplify the circuit"""
    pm = PassManager(
        [
            CommutativeOptimization(),
        ]
    )
    circuit = transpile(circuit, optimization_level=3)
    circuit = pm.run(circuit)
    return circuit


def summarize_circuit(circuit: QuantumCircuit) -> dict[str, int | str]:
    """Summarize the circuit with depth, size, and 2-qubit gate information."""
    two_qubit_total = sum(
        inst.operation.num_qubits == 2 for inst in circuit.data
    )
    two_qubit_depth = circuit.depth(lambda x: x[0].num_qubits == 2)
    return {
        "depth": circuit.depth(),
        "size": circuit.size(),
        "2q gates": two_qubit_total,
        "2q depth": two_qubit_depth,
    }


def solve_thresholded_gevp(
    h_matrix: np.ndarray,
    s_matrix: np.ndarray,
    threshold: float = 1e-10,
) -> tuple[float, np.ndarray, int]:
    """Solve H c = E S c using canonical orthogonalization of S."""
    s_vals, s_vecs = la.eigh(s_matrix)

    valid = s_vals > threshold
    if not np.any(valid):
        raise ValueError(
            "All overlap eigenvalues were removed by thresholding."
        )

    keep = valid

    orthogonalizer = s_vecs[:, keep] @ np.diag(1.0 / np.sqrt(s_vals[keep]))
    h_orth = orthogonalizer.conj().T @ h_matrix @ orthogonalizer
    h_orth = 0.5 * (h_orth + h_orth.conj().T)

    eigvals, eigvecs = la.eigh(h_orth)

    coeffs = orthogonalizer @ eigvecs[:, 0]
    normalization = np.sqrt(np.real(coeffs.conj().T @ s_matrix @ coeffs))
    coeffs /= normalization

    return float(np.real(eigvals[0])), coeffs, int(np.sum(keep))
Im ersten Teil dieses Tutorials veranschaulichen wir die KQD-Methode anhand eines Simulators mit lokalem Zustandsvektor. Später nutzen wir ein echtes Quanten-Backend, um ein Problem im industriellen Maßstab anzugehen.
Außerdem definieren wir ein fiktives Backend, um die backendspezifische Transpilierung zu veranschaulichen und die daraus resultierende Schaltung zu untersuchen.
try:
    service = QiskitRuntimeService()
except Exception:
    QiskitRuntimeService.save_account(
        token="<api_token>", instance="<instance>", overwrite=True
    )
    service = QiskitRuntimeService()

backend = FakeMarrakesh()
Beispiel für einen Simulator im kleinen Maßstab
Schritt 1: Klassische Eingaben einem Quantenproblem zuordnen
Hamilton-Funktor und Referenzzustand
In diesem Beispiel wird eine Heisenberg-Kette mit 12 Qubits und offenen Grenzen verwendet ( ),
mit einem Produktzustand mit einer einzigen Anregung
als Referenzzustand. Da der oben definierte Heisenberg-Hamilton-Operator die Gesamtzahl der Anregungen bewahrt, verbleibt der Referenzzustand im Unterraum mit einer einzigen Anregung, dessen Dimension nur linear mit der Anzahl der Qubits wächst. Wir können daher die exakte Grundzustandsenergie effizient berechnen, indem wir den auf diesen Unterraum beschränkten Hamiltonoperator diagonalisieren, und sie ausschließlich als diagnostischen Maßstab für die KQD-Schätzung verwenden. Der KQD-Workflow selbst schätzt die projizierten Matrixelemente mithilfe von „ Qiskit primitives “ und löst das daraus resultierende projizierte Problem auf klassische Weise.
# Problem definition for the simulator example
num_qubits = 12
hamiltonian = make_heisenberg_hamiltonian(num_qubits=num_qubits, coupling=1.0)
ref_bitstring = "000001000000"
ref_energy = basis_state_expectation_sparse(hamiltonian, ref_bitstring)

print("Hamiltonian:")
print(hamiltonian)
print(f"Reference state: |{ref_bitstring}>")
print("Reference energy: ", ref_energy)
Output:
Hamiltonian:
SparsePauliOp(['IIIIIIIIIIXX', 'IIIIIIIIIXXI', 'IIIIIIIIXXII', 'IIIIIIIXXIII', 'IIIIIIXXIIII', 'IIIIIXXIIIII', 'IIIIXXIIIIII', 'IIIXXIIIIIII', 'IIXXIIIIIIII', 'IXXIIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIIYYI', 'IIIIIIIIYYII', 'IIIIIIIYYIII', 'IIIIIIYYIIII', 'IIIIIYYIIIII', 'IIIIYYIIIIII', 'IIIYYIIIIIII', 'IIYYIIIIIIII', 'IYYIIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIIZZI', 'IIIIIIIIZZII', 'IIIIIIIZZIII', 'IIIIIIZZIIII', 'IIIIIZZIIIII', 'IIIIZZIIIIII', 'IIIZZIIIIIII', 'IIZZIIIIIIII', 'IZZIIIIIIIII', 'ZZIIIIIIIIII'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])
Reference state: |000001000000>
Reference energy:  (7+0j)
Legen Sie die Parameter für den Algorithmus fest
Ausgehend von den Obergrenzen für die Hamilton-Norm schlägt Ref. [1] heuristisch die Zeitschritt als „ “ vor. Da die Spektralnorm schwer zu berechnen ist, verwenden wir stattdessen ihre Obergrenze:
Wir haben die Krylov-Dimension auf und die Anzahl der Trotter-Schritte pro Zeitschritt auf festgelegt: ein ausreichend großer Krylov-Raum, um das tiefliegende Spektrum aufzulösen und gleichzeitig die tiefste Schaltung ( ) rechnerisch überschaubar zu halten, sowie genügend Trotter-Schritte, um den Diskretisierungsfehler bei dieser tiefsten Schaltung gering zu halten.
dt = np.pi / (3 * (num_qubits - 1))
print("dt in Krylov basis:  ", dt)

krylov_dim = 10
num_trotter_steps = 5
Output:
dt in Krylov basis: 0.09519977738150888
Schaltung aufbauen
Hier bauen wir die Schaltungen auf, um die Matrixelemente und zu schätzen. Da alle Potenzen von kommutieren, gilt
Solche Matrizen, bei denen die Elemente auf diese Weise von den Indexunterschieden abhängen, werden als Toeplitz-Matrizen bezeichnet und lassen sich aus den Elementen der ersten Zeile rekonstruieren, die durch indiziert sind.
Hier stellen wir die Schaltung vor, die als „Extended-Swap-Test“ bezeichnet wird und die
wobei gilt.
Referenzstatus
Wir berechnen den Referenzzustand .
qc_ref = QuantumCircuit(num_qubits)
for i, b in enumerate(reversed(ref_bitstring)):
    if b == "1":
        qc_ref.x(i)
display(qc_ref.draw("mpl", scale=0.5))
Output:

Zeitliche Entwicklung
Berechnen Sie den durch den Hamilton-Operator erzeugten Zeitentwicklungsoperator, der durch eine einfache Lie-Trotter-Approximation approximiert wird.
t = Parameter("t")

evol_gate = PauliEvolutionGate(
    hamiltonian,
    time=t,
    synthesis=LieTrotter(reps=num_trotter_steps),
    label="U(t)",
)

# Synthesize U(t) first and then control the synthesized circuit.
# This makes the controlled structure visible in the circuit drawer.
evolution_circuit = QuantumCircuit(num_qubits, name="U(t)")
evolution_circuit.append(evol_gate, range(num_qubits))
evolution_circuit = simple_transpilation(evolution_circuit)

# Make a controlled version of the evolution circuit.
controlled_evolution_gate = evolution_circuit.to_gate(label="U(t)").control(
    1, label="C-U(t)"
)
display(
    evolution_circuit.assign_parameters({t: 1.5}).draw(
        "mpl", scale=0.5, fold=-1
    )
)
Output:

Erweiterte Swap-Testschaltung [3]
Die Schaltung legt zunächst den Referenzzustand im Systemregister fest, während sich die Ancilla weiterhin im Zustand „ “ befindet:
Wendet man dann ein Hadamard-Gatter auf die Ancilla an, entsteht eine kohärente Überlagerung zweier Verzweigungen:
Schließlich gilt das Gatter für die kontrollierte Zeitentwicklung:
nur wenn sich die Ancilla im Zweig „ “ befindet. Dies bedeutet Folgendes:
Im nächsten Code-Block implementieren wir:
die im Ausführungsschritt als „ “ für „ “ zugewiesen wird.
ancilla = 0
system_qubits = list(range(1, num_qubits + 1))

extended_swap_test = QuantumCircuit(num_qubits + 1)

# Append state preparation part
extended_swap_test = extended_swap_test.compose(qc_ref, system_qubits)

# Prepare the coherent branch label, (|0> + |1>) / sqrt(2).
extended_swap_test.h(ancilla)

# Apply U(t) only to the |1> branch of the ancilla.
extended_swap_test.append(
    controlled_evolution_gate, [ancilla] + system_qubits
)

# Decompose once more for visualization so that control bullets are visible.
display(extended_swap_test.draw("mpl", fold=-1))
Output:

Beobachtbare Größen
Für jedes hermitische System mit den Observablen legen wir hier die zu berechnenden Observablen wie folgt fest:
Das liegt daran, dass das Überlappungselement liefert, während das Hamilton-Element liefert.
Unter Verwendung von erhalten wir
Ebenso lässt sich mit „ “
Daher gilt:
Schließlich müssen wir für jeden Zustands Folgendes messen:
n_qubits = hamiltonian.num_qubits

observable_labels = [
    "Re S_0d",
    "Im S_0d",
    "Re H_0d",
    "Im H_0d",
]

# X ⊗ I and Y ⊗ I.
# Qiskit's Pauli-label convention places qubit 0 on the rightmost character,
# so the ancilla Pauli is appended to the right.
obs_x_identity = SparsePauliOp("I" * n_qubits + "X")
obs_y_identity = SparsePauliOp("I" * n_qubits + "Y")

# X ⊗ H and Y ⊗ H.
obs_x_hamiltonian = SparsePauliOp.from_list(
    [
        (label + "X", coeff)
        for label, coeff in zip(
            hamiltonian.paulis.to_labels(),
            hamiltonian.coeffs,
        )
    ]
)

obs_y_hamiltonian = SparsePauliOp.from_list(
    [
        (label + "Y", coeff)
        for label, coeff in zip(
            hamiltonian.paulis.to_labels(),
            hamiltonian.coeffs,
        )
    ]
)

observables = [
    obs_x_identity,
    obs_y_identity,
    obs_x_hamiltonian,
    obs_y_hamiltonian,
]

for obs, label in zip(observables, observable_labels):
    print(f"Observable: {label}")
    print(obs)
    print()
Output:
Observable: Re S_0d
SparsePauliOp(['IIIIIIIIIIIIX'],
              coeffs=[1.+0.j])

Observable: Im S_0d
SparsePauliOp(['IIIIIIIIIIIIY'],
              coeffs=[1.+0.j])

Observable: Re H_0d
SparsePauliOp(['IIIIIIIIIIXXX', 'IIIIIIIIIXXIX', 'IIIIIIIIXXIIX', 'IIIIIIIXXIIIX', 'IIIIIIXXIIIIX', 'IIIIIXXIIIIIX', 'IIIIXXIIIIIIX', 'IIIXXIIIIIIIX', 'IIXXIIIIIIIIX', 'IXXIIIIIIIIIX', 'XXIIIIIIIIIIX', 'IIIIIIIIIIYYX', 'IIIIIIIIIYYIX', 'IIIIIIIIYYIIX', 'IIIIIIIYYIIIX', 'IIIIIIYYIIIIX', 'IIIIIYYIIIIIX', 'IIIIYYIIIIIIX', 'IIIYYIIIIIIIX', 'IIYYIIIIIIIIX', 'IYYIIIIIIIIIX', 'YYIIIIIIIIIIX', 'IIIIIIIIIIZZX', 'IIIIIIIIIZZIX', 'IIIIIIIIZZIIX', 'IIIIIIIZZIIIX', 'IIIIIIZZIIIIX', 'IIIIIZZIIIIIX', 'IIIIZZIIIIIIX', 'IIIZZIIIIIIIX', 'IIZZIIIIIIIIX', 'IZZIIIIIIIIIX', 'ZZIIIIIIIIIIX'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])

Observable: Im H_0d
SparsePauliOp(['IIIIIIIIIIXXY', 'IIIIIIIIIXXIY', 'IIIIIIIIXXIIY', 'IIIIIIIXXIIIY', 'IIIIIIXXIIIIY', 'IIIIIXXIIIIIY', 'IIIIXXIIIIIIY', 'IIIXXIIIIIIIY', 'IIXXIIIIIIIIY', 'IXXIIIIIIIIIY', 'XXIIIIIIIIIIY', 'IIIIIIIIIIYYY', 'IIIIIIIIIYYIY', 'IIIIIIIIYYIIY', 'IIIIIIIYYIIIY', 'IIIIIIYYIIIIY', 'IIIIIYYIIIIIY', 'IIIIYYIIIIIIY', 'IIIYYIIIIIIIY', 'IIYYIIIIIIIIY', 'IYYIIIIIIIIIY', 'YYIIIIIIIIIIY', 'IIIIIIIIIIZZY', 'IIIIIIIIIZZIY', 'IIIIIIIIZZIIY', 'IIIIIIIZZIIIY', 'IIIIIIZZIIIIY', 'IIIIIZZIIIIIY', 'IIIIZZIIIIIIY', 'IIIZZIIIIIIIY', 'IIZZIIIIIIIIY', 'IZZIIIIIIIIIY', 'ZZIIIIIIIIIIY'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])
Bei der Abschätzung der Matrixelemente von „ “ ist die Anzahl der Pauli-Terme wesentlich größer als bei den Matrixelementen von „ “.
Mithilfe einer Verschiebungstechnik [4] können wir nun die Anzahl der gemessenen Hamilton-Terme reduzieren. Wir zerlegen den Hamilton-Operator wie folgt:
wobei so gewählt wird, dass der Referenzzustand sein Eigenzustand ist,
Dann,
In dieser Datei gilt Folgendes:
ist das verschobene Matrixelement des Hamilton-Operators. Daher müssen wir lediglich und messen. Der Beitrag von wird klassisch anhand des bereits gemessenen Überlappungsmatrixelements rekonstruiert.
In diesem Beispiel bietet sich der diagonale Teil des Heisenberg-Hamilton-Operators an,
Da es sich bei dem Referenzzustand um einen Berechnungsbasiszustand handelt, ist er ein Eigenzustand jedes „ “-Terms.
Eine vorteilhaftere Wahl ist es jedoch, nicht nur die diagonalen Terme einzubeziehen, sondern auch die Terme, die den Referenzzustand auslöschen.
Für jedes Nachbarpaar gilt für den Operator :
und
Daher trägt der Term „ “ nur dann bei, wenn die beiden benachbarten Qubits unterschiedliche Belegungen in der Referenz-Bitfolge aufweisen. Sind die beiden Qubits entweder beide „ “ oder beide „ “, so löscht dieser Term den Referenzzustand aus und kann ebenfalls herausgenommen werden.
Sei , wobei gilt. Somit können wir wählen
Dieser Operator erfüllt weiterhin
denn die Terme von wirken diagonal auf ein, während die verschobenen Terme von den Wert Null ergeben. Der entsprechende Eigenwert wird daher ausschließlich durch die Terme „ “ bestimmt,
Mit dieser Wahl lautet der verschobene Hamilton-Operator nun:
Daher müssen nur die Kanten gemessen werden, an denen im Referenzzustand unterschiedliche Berufe ausgeübt werden. Alle Terme von und alle inaktiven Terme von werden durch den Überlappungsbeitrag rekonstruiert oder liefern per Konstruktion einen Beitrag von Null.
Dadurch ergibt sich eine kleinere Observable als bei einer Verschiebung nur des diagonalen Teils. Insbesondere bleiben bei einem Referenzzustand auf Berechnungsbasis mit einer lokalisierten Anregung nur die an die Anregung angrenzenden Kanten in erhalten. Daher kann die Anzahl der Pauli-Terme in und erheblich reduziert werden, während das rekonstruierte Matrixelement
bleibt genau gleich.
def make_reduced_heisenberg_observables(
    ref_bitstring: str,
    coupling: float = 1.0,
) -> tuple[SparsePauliOp, SparsePauliOp, float]:
    """Build X⊗(H-T), Y⊗(H-T), and tau."""
    n_qubits = len(ref_bitstring)

    shifted_terms: list[tuple[str, complex]] = []
    tau = 0.0

    def bit(q: int) -> str:
        return ref_bitstring[n_qubits - 1 - q]

    def append_term(q0: int, q1: int, pauli: str):
        label = ["I"] * n_qubits
        label[n_qubits - 1 - q0] = pauli[0]
        label[n_qubits - 1 - q1] = pauli[1]
        shifted_terms.append(("".join(label), coupling))

    for q in range(n_qubits - 1):
        same_occupation = bit(q) == bit(q + 1)

        # ZZ contribution to tau
        tau += coupling * (1.0 if same_occupation else -1.0)

        # XX + YY survives only for opposite occupations.
        if not same_occupation:
            append_term(q, q + 1, "XX")
            append_term(q, q + 1, "YY")

    if shifted_terms:
        obs_x_shifted_hamiltonian = SparsePauliOp.from_list(
            [(label + "X", coeff) for label, coeff in shifted_terms]
        )
        obs_y_shifted_hamiltonian = SparsePauliOp.from_list(
            [(label + "Y", coeff) for label, coeff in shifted_terms]
        )
    else:
        obs_x_shifted_hamiltonian = SparsePauliOp(
            "I" * n_qubits + "X", coeffs=[0.0]
        )
        obs_y_shifted_hamiltonian = SparsePauliOp(
            "I" * n_qubits + "Y", coeffs=[0.0]
        )

    return obs_x_shifted_hamiltonian, obs_y_shifted_hamiltonian, tau


obs_x_shifted_hamiltonian, obs_y_shifted_hamiltonian, shift_tau = (
    make_reduced_heisenberg_observables(ref_bitstring)
)

print("Observable: Re shifted H_0d")
print(obs_x_shifted_hamiltonian)
print()

print("Observable: Im shifted H_0d")
print(obs_y_shifted_hamiltonian)
print()

print("tau =", shift_tau)

observables = [
    obs_x_identity,
    obs_y_identity,
    obs_x_shifted_hamiltonian,
    obs_y_shifted_hamiltonian,
]
observable_labels = [
    "Re S_0d",
    "Im S_0d",
    "Re shifted H_0d",
    "Im shifted H_0d",
]
Output:
Observable: Re shifted H_0d
SparsePauliOp(['IIIIIXXIIIIIX', 'IIIIIYYIIIIIX', 'IIIIXXIIIIIIX', 'IIIIYYIIIIIIX'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])

Observable: Im shifted H_0d
SparsePauliOp(['IIIIIXXIIIIIY', 'IIIIIYYIIIIIY', 'IIIIXXIIIIIIY', 'IIIIYYIIIIIIY'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])

tau = 7.0
Schritt 2: Optimierung des Problems für die Ausführung auf Quantenhardware
Nun wandeln wir die abstrakte Schaltung für den erweiterten Swap-Test in eine hardwareorientierte Vorlage um. Zuvor optimieren wir die Schaltung zunächst auf abstrakter Ebene weiter.
Vergleich der Reihenfolge der Hamilton-Terme
Zunächst vergleichen wir verschiedene Reihenfolgen der Pauli-Terme im Heisenberg-Hamilton-Operator für die Hamilton-Simulation. Der Hamilton-Operator selbst bleibt unverändert, doch die Reihenfolge beeinflusst, wie der Schaltkreis in Produktform generiert wird und inwieweit die Struktur im Schaltkreis parallelisiert werden kann. Beispielsweise listet die naive Reihenfolge zunächst alle „Nearest-Neighbor“- -Terme auf, dann alle „ “-Terme und schließlich alle „ “-Terme. Dadurch werden benachbarte Kanten wie und nebeneinander platziert, sodass sie nicht parallel ausgeführt werden können. Bei der „even-then-odd“-Reihenfolge werden zunächst die disjunkten geraden Kanten und anschließend die ungeraden Kanten durchlaufen, wodurch parallele Zwei-Qubit-Schichten freigelegt werden. Die nach geraden und ungeraden Kanten gruppierte Reihenfolge geht noch einen Schritt weiter: Für jede Kante werden die lokalen Terme „ “, „ “ und „ “ beibehalten, während weiterhin gerade Kanten vor ungeraden Kanten besucht werden. Wir gehen davon aus, dass die „even-then-odd“- und „even-odd“-Anordnungen mit Kantengruppierung die Schaltungstiefe verringern, indem sie parallele Zwei-Qubit-Schichten freilegen, und dass die Anordnung mit Kantengruppierung zudem den Trotter-Fehler reduziert, da die lokale Zwei-Qubit-Wechselwirkung an derselben Kante als kompakter Block behandelt wird.

Die Hamilton-Reihenfolge wirkt sich auch auf den Trotter-Fehler aus. Wenn wir nichtkommutierende Terme nebeneinander setzen, treten die Basisübergänge häufiger auf, was zu einem größeren Trotter-Fehler führt. Durch die Gruppierung von Termen, die dieselbe Pauli-Basistransformation erfordern, lassen sich überflüssige Basiswechsel vermeiden.
Hier wird für den Vergleich die größte Evolutionszeit herangezogen, die in den Krylov-Schätzungen der ersten Zeile auftritt ( ), wobei dieselbe Transpilationsbedingung verwendet wird.
Um den Trotter-Fehler zu messen, verwenden wir die Prozessuntreue zwischen der Trotterisierten Schaltung und der exakten Hamilton-Entwicklung,
wobei die Dimension des Hilbert-Raums ist.
Diese Diagnose verwendet dichte Matrizen und eignet sich daher für dieses kleine 12-Qubit-Beispiel, ist jedoch nicht als skalierbare Subroutine gedacht.
# The comparison uses the largest time that appears in the first-row Krylov estimates.
# Circuit depth does not depend on this numeric value, but the Trotter error does.
comparison_time = (krylov_dim - 1) * dt


def make_heisenberg_hamiltonian_ordered(
    num_qubits: int,
    ordering: str,
    coupling: float = 1.0,
) -> SparsePauliOp:
    """Return the same Heisenberg Hamiltonian with a specified term ordering."""
    terms: list[tuple[str, complex]] = []
    even_edges = [(q, q + 1) for q in range(0, num_qubits - 1, 2)]
    odd_edges = [(q, q + 1) for q in range(1, num_qubits - 1, 2)]

    def append_term(q0: int, q1: int, pauli: str):
        label = ["I"] * num_qubits
        label[num_qubits - 1 - q0] = pauli[0]
        label[num_qubits - 1 - q1] = pauli[1]
        terms.append(("".join(label), coupling))

    if ordering == "naive":
        for pauli in ("XX", "YY", "ZZ"):
            for q in range(num_qubits - 1):
                append_term(q, q + 1, pauli)
    elif ordering == "even-then-odd":
        for pauli in ("XX", "YY", "ZZ"):
            for q0, q1 in even_edges + odd_edges:
                append_term(q0, q1, pauli)
    elif ordering == "even-odd edge-grouped":
        for q0, q1 in even_edges + odd_edges:
            for pauli in ("XX", "YY", "ZZ"):
                append_term(q0, q1, pauli)
    else:
        raise ValueError(f"Unknown ordering: {ordering}")

    return SparsePauliOp.from_list(terms).simplify()


def build_numeric_evolution_circuit(
    hamiltonian: SparsePauliOp,
    synthesis,
    time_value: float,
    **synthesis_kwargs,
) -> QuantumCircuit:
    """Build a numeric circuit for exp(-i H t) with a chosen synthesis rule."""
    evolution_gate = PauliEvolutionGate(
        hamiltonian,
        time=time_value,
        synthesis=synthesis(**synthesis_kwargs),
    )
    circuit = QuantumCircuit(hamiltonian.num_qubits)
    circuit.append(evolution_gate, range(hamiltonian.num_qubits))
    return circuit


def process_infidelity(
    circuit: QuantumCircuit,
    exact_matrix: np.ndarray,
) -> float:
    """Return 1 - |Tr(U_circuit† U_exact) / d|²."""
    circuit_matrix = np.asarray(Operator(circuit).data)
    dim = circuit_matrix.shape[0]
    normalized_trace = np.vdot(circuit_matrix, exact_matrix) / dim
    fidelity = np.abs(normalized_trace) ** 2
    return float(np.clip(1.0 - fidelity, 0.0, 1.0))


hamiltonians_by_ordering = {
    ordering: make_heisenberg_hamiltonian_ordered(
        num_qubits, ordering, coupling=1.0
    )
    for ordering in ["naive", "even-then-odd", "even-odd edge-grouped"]
}

print(f"Comparison time: {comparison_time}\n")

for order_name, ham_ordered in hamiltonians_by_ordering.items():
    print(f"{order_name}:")
    print([op for op, _ in ham_ordered.to_list()])
    print()

print("Precomputing the exact evolution operator... ", end="")
exact_matrix = la.expm(-1j * comparison_time * hamiltonian.to_matrix())
print("Done")
Output:
Comparison time: 0.8567979964335799

naive:
['IIIIIIIIIIXX', 'IIIIIIIIIXXI', 'IIIIIIIIXXII', 'IIIIIIIXXIII', 'IIIIIIXXIIII', 'IIIIIXXIIIII', 'IIIIXXIIIIII', 'IIIXXIIIIIII', 'IIXXIIIIIIII', 'IXXIIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIIYYI', 'IIIIIIIIYYII', 'IIIIIIIYYIII', 'IIIIIIYYIIII', 'IIIIIYYIIIII', 'IIIIYYIIIIII', 'IIIYYIIIIIII', 'IIYYIIIIIIII', 'IYYIIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIIZZI', 'IIIIIIIIZZII', 'IIIIIIIZZIII', 'IIIIIIZZIIII', 'IIIIIZZIIIII', 'IIIIZZIIIIII', 'IIIZZIIIIIII', 'IIZZIIIIIIII', 'IZZIIIIIIIII', 'ZZIIIIIIIIII']

even-then-odd:
['IIIIIIIIIIXX', 'IIIIIIIIXXII', 'IIIIIIXXIIII', 'IIIIXXIIIIII', 'IIXXIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIXXI', 'IIIIIIIXXIII', 'IIIIIXXIIIII', 'IIIXXIIIIIII', 'IXXIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIYYII', 'IIIIIIYYIIII', 'IIIIYYIIIIII', 'IIYYIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIYYI', 'IIIIIIIYYIII', 'IIIIIYYIIIII', 'IIIYYIIIIIII', 'IYYIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIZZII', 'IIIIIIZZIIII', 'IIIIZZIIIIII', 'IIZZIIIIIIII', 'ZZIIIIIIIIII', 'IIIIIIIIIZZI', 'IIIIIIIZZIII', 'IIIIIZZIIIII', 'IIIZZIIIIIII', 'IZZIIIIIIIII']

even-odd edge-grouped:
['IIIIIIIIIIXX', 'IIIIIIIIIIYY', 'IIIIIIIIIIZZ', 'IIIIIIIIXXII', 'IIIIIIIIYYII', 'IIIIIIIIZZII', 'IIIIIIXXIIII', 'IIIIIIYYIIII', 'IIIIIIZZIIII', 'IIIIXXIIIIII', 'IIIIYYIIIIII', 'IIIIZZIIIIII', 'IIXXIIIIIIII', 'IIYYIIIIIIII', 'IIZZIIIIIIII', 'XXIIIIIIIIII', 'YYIIIIIIIIII', 'ZZIIIIIIIIII', 'IIIIIIIIIXXI', 'IIIIIIIIIYYI', 'IIIIIIIIIZZI', 'IIIIIIIXXIII', 'IIIIIIIYYIII', 'IIIIIIIZZIII', 'IIIIIXXIIIII', 'IIIIIYYIIIII', 'IIIIIZZIIIII', 'IIIXXIIIIIII', 'IIIYYIIIIIII', 'IIIZZIIIIIII', 'IXXIIIIIIIII', 'IYYIIIIIIIII', 'IZZIIIIIIIII']

Precomputing the exact evolution operator... Done
Zunächst belassen wir die Syntheseregel auf einen Trotter-Schritt erster Ordnung und variieren lediglich die Reihenfolge der Pauli-Terme. Das Ziel dieses Vergleichs besteht vor allem darin, zu ermitteln, um wie viel die Schaltungstiefe und die Kosten pro zwei Qubits reduziert werden können, wenn nicht überlappende Kanten zwischen nächsten Nachbarn dem Transpiler zugänglich gemacht werden.
ordering_comparison_rows = []
infidelity_reps = [1, 2, 4, 8]

for ordering, ham_ordered in hamiltonians_by_ordering.items():
    for reps in infidelity_reps:
        circuit = build_numeric_evolution_circuit(
            ham_ordered,
            LieTrotter,
            comparison_time,
            reps=reps,
        )
        decomposed_circuit = simple_transpilation(circuit)
        infidelity = process_infidelity(decomposed_circuit, exact_matrix)
        ordering_comparison_rows.append(
            {
                "ordering": ordering,
                "synthesis": f"LieTrotter(reps={reps})",
                "infidelity": infidelity,
                **summarize_circuit(decomposed_circuit),
            }
        )
        if reps == 1:
            print(f"Circuit for {ordering} ordering:")
            print([op for op, _ in ham_ordered.to_list()])
            display(decomposed_circuit.draw("mpl", fold=-1, scale=0.6))

ordering_comparison_df = pd.DataFrame(ordering_comparison_rows)
display(ordering_comparison_df)

hamiltonian_for_synthesis = hamiltonians_by_ordering["even-odd edge-grouped"]
Output:
Circuit for naive ordering:
['IIIIIIIIIIXX', 'IIIIIIIIIXXI', 'IIIIIIIIXXII', 'IIIIIIIXXIII', 'IIIIIIXXIIII', 'IIIIIXXIIIII', 'IIIIXXIIIIII', 'IIIXXIIIIIII', 'IIXXIIIIIIII', 'IXXIIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIIYYI', 'IIIIIIIIYYII', 'IIIIIIIYYIII', 'IIIIIIYYIIII', 'IIIIIYYIIIII', 'IIIIYYIIIIII', 'IIIYYIIIIIII', 'IIYYIIIIIIII', 'IYYIIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIIZZI', 'IIIIIIIIZZII', 'IIIIIIIZZIII', 'IIIIIIZZIIII', 'IIIIIZZIIIII', 'IIIIZZIIIIII', 'IIIZZIIIIIII', 'IIZZIIIIIIII', 'IZZIIIIIIIII', 'ZZIIIIIIIIII']

Circuit for even-then-odd ordering:
['IIIIIIIIIIXX', 'IIIIIIIIXXII', 'IIIIIIXXIIII', 'IIIIXXIIIIII', 'IIXXIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIXXI', 'IIIIIIIXXIII', 'IIIIIXXIIIII', 'IIIXXIIIIIII', 'IXXIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIYYII', 'IIIIIIYYIIII', 'IIIIYYIIIIII', 'IIYYIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIYYI', 'IIIIIIIYYIII', 'IIIIIYYIIIII', 'IIIYYIIIIIII', 'IYYIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIZZII', 'IIIIIIZZIIII', 'IIIIZZIIIIII', 'IIZZIIIIIIII', 'ZZIIIIIIIIII', 'IIIIIIIIIZZI', 'IIIIIIIZZIII', 'IIIIIZZIIIII', 'IIIZZIIIIIII', 'IZZIIIIIIIII']

Circuit for even-odd edge-grouped ordering:
['IIIIIIIIIIXX', 'IIIIIIIIIIYY', 'IIIIIIIIIIZZ', 'IIIIIIIIXXII', 'IIIIIIIIYYII', 'IIIIIIIIZZII', 'IIIIIIXXIIII', 'IIIIIIYYIIII', 'IIIIIIZZIIII', 'IIIIXXIIIIII', 'IIIIYYIIIIII', 'IIIIZZIIIIII', 'IIXXIIIIIIII', 'IIYYIIIIIIII', 'IIZZIIIIIIII', 'XXIIIIIIIIII', 'YYIIIIIIIIII', 'ZZIIIIIIIIII', 'IIIIIIIIIXXI', 'IIIIIIIIIYYI', 'IIIIIIIIIZZI', 'IIIIIIIXXIII', 'IIIIIIIYYIII', 'IIIIIIIZZIII', 'IIIIIXXIIIII', 'IIIIIYYIIIII', 'IIIIIZZIIIII', 'IIIXXIIIIIII', 'IIIYYIIIIIII', 'IIIZZIIIIIII', 'IXXIIIIIIIII', 'IYYIIIIIIIII', 'IZZIIIIIIIII']

Wir stellen fest reps=1, dass sowohl die „even-then-odd“- als auch die „even-odd“-Kantengruppierung die Tiefe von 15 auf 6 reduzieren, indem sie parallele Zwei-Qubit-Schichten freilegen, während die Anzahl der Zwei-Qubit-Gatter bei allen drei Anordnungen gleich bleibt.
Da jedoch bei allen drei Ordnungen die Untreue nahe bei 1 liegt, variieren wir die Anzahl der Trotter-Wiederholungen, um die Ordnungen deutlicher voneinander abzugrenzen.
Mit zunehmender Anzahl von Wiederholungen nimmt die Unzuverlässigkeit der Reihenfolge even-odd edge-grouped schneller ab als bei den beiden anderen und erreicht den Wert 0.045, während reps=8 sie bei der naiven sowie der „zuerst gerade, dann ungerade“-Reihenfolge bei 0.075 liegt.
Vergleich der Synthese von Produktformeln
Als Nächstes untersuchen wir verschiedene erweiterte Einstellungen der Trotterisierung, wobei die feste Hamilton-Ordnung auf die nach geraden und ungeraden Kanten gruppierte Ordnung umgestellt wird. Wir betrachten den Lie-Trotter-Prozess erster Ordnung, den Suzuki-Trotter-Prozess zweiter Ordnung und den Suzuki-Trotter-Prozess vierter Ordnung.
synthesis_comparison_rows = []

for num_trotter_steps in [1, 2, 3, 4, 5]:
    synthesis_cases = [
        ("LieTrotter", LieTrotter, {"reps": num_trotter_steps}),
        (
            "SuzukiTrotter(order=2)",
            SuzukiTrotter,
            {"order": 2, "reps": num_trotter_steps},
        ),
        (
            "SuzukiTrotter(order=4)",
            SuzukiTrotter,
            {"order": 4, "reps": num_trotter_steps},
        ),
    ]
    for label, synthesis, kwargs in synthesis_cases:
        circuit = build_numeric_evolution_circuit(
            hamiltonian_for_synthesis,
            synthesis,
            comparison_time,
            **kwargs,
        )
        decomposed_circuit = simple_transpilation(circuit)
        synthesis_comparison_rows.append(
            {
                "synthesis": label,
                "reps": kwargs["reps"],
                "infidelity": process_infidelity(
                    decomposed_circuit, exact_matrix
                ),
                **summarize_circuit(decomposed_circuit),
            }
        )

synthesis_comparison_df = pd.DataFrame(synthesis_comparison_rows)
display(synthesis_comparison_df.sort_values(["2q gates", "2q depth"]))

# For memory free
exact_matrix = None
Output:
Lie-Trotter liefert den flachsten Kreis, weist jedoch den größten Fehler auf, während der Suzuki-Trotter-Algorithmus vierter Ordnung zwar genauer ist, aber die Kreistiefe erhöht. Für den weiteren Verlauf des Tutorials entscheiden wir uns für die Suzuki-Trotter-Formel zweiter Ordnung, da sie eine Schaltung mit geringer Tiefe liefert und gleichzeitig den Trotter-Fehler im Vergleich zur Formel erster Ordnung erheblich reduziert.
Das Gatter für die kontrollierte zeitliche Entwicklung entfernen
Im erweiterten Swap-Test erfordert die Steuerung der zeitlichen Entwicklung durch ein einzelnes Ancilla-Qubit, dass das Ancilla viele Gatter im gesamten System steuert. Dies kann zu einem erheblichen Routing-Aufwand führen und erfordert im schlimmsten Fall praktisch eine „All-to-One“-Konnektivität. Um dies zu vermeiden, ist eine weitere Optimierung möglich, indem das gesteuerte Zeitentwicklungsgatter durch eine steuerungsfreie Version ersetzt wird, wobei die Symmetrie des Hamilton-Operators ausgenutzt wird. Betrachten wir die folgende Schaltung.

Hier bereitet den Referenzzustand vor: .
Anstatt zunächst „ “ vorzubereiten und anschließend „ “ nur auf den Zweig „ “ anzuwenden, bereitet der Schaltkreis die beiden Zweige direkt wie folgt vor:
wo
Die Schaltung wendet zunächst ein Hadamard-Gatter auf den Ancilla an und bereitet den Referenzzustand nur auf dem Zweig „ “ vor:
Anschließend wird der Operator der unkontrollierten Zeitentwicklung auf beide Zweige angewendet:
Da der Hamiltonoperator die Anregungszahl erhält, lässt sich erkennen, dass sein Eigenzustand ist, und somit akumuliert der Evolutionsoperator unter dem Hamiltonoperator lediglich eine Phase:
Dies bedeutet Folgendes:
Anschließend wird „ “ ausschließlich auf den Zweig „ “ angewendet.
Zu diesem Zeitpunkt weisen die beiden Zweige eine zusätzliche relative Phase auf. Um es zu entfernen, wenden wir das Ancilla-Phasengatter an
Dadurch wird der Zustand wie folgt transformiert:
So haben wir schließlich, bis auf eine irrelevante globale Phase, Folgendes hergestellt:
Im folgenden Code-Block implementieren wir diese steuerungsfreie Schaltung.
controlled_extended_swap_test = extended_swap_test

# Reuse the ordering and synthesis rule selected by the comparison above.
evol_gate_optimized = PauliEvolutionGate(
    hamiltonian_for_synthesis,
    time=t,
    synthesis=SuzukiTrotter(order=2, reps=num_trotter_steps),
)

uncontrolled_evolution = QuantumCircuit(num_qubits, name="U_ST2(t)")
uncontrolled_evolution.append(evol_gate_optimized, range(num_qubits))

controlled_state_prep = QuantumCircuit(num_qubits + 1, name="C-Prep")
for q, bit in enumerate(reversed(ref_bitstring)):
    if bit == "1":
        controlled_state_prep.cx(ancilla, system_qubits[q])

vacuum_bitstring = "0" * num_qubits
vacuum_energy = basis_state_expectation_sparse(hamiltonian, "0" * num_qubits)

optimized_extended_swap_test = QuantumCircuit(num_qubits + 1)
optimized_extended_swap_test.h(ancilla)

# Prepare |psi_ref> only on the |1> branch.
optimized_extended_swap_test.compose(controlled_state_prep, inplace=True)
optimized_extended_swap_test.barrier()

# Apply the Trotterized time evolution without control.
optimized_extended_swap_test.compose(
    uncontrolled_evolution,
    qubits=system_qubits,
    inplace=True,
)
optimized_extended_swap_test.barrier()

# Map |0>|0...0> to |0>|psi_ref>, leaving the |1> branch unchanged.
optimized_extended_swap_test.x(ancilla)
optimized_extended_swap_test.compose(controlled_state_prep, inplace=True)
optimized_extended_swap_test.x(ancilla)

# Cancel the known vacuum phase so that the same X/Y observables can be used.
optimized_extended_swap_test.p(-vacuum_energy * t, ancilla)
optimized_extended_swap_test = simple_transpilation(
    optimized_extended_swap_test
)

print(f"Vacuum energy E_vac = {vacuum_energy:.1f}")
display(
    optimized_extended_swap_test.assign_parameters({t: 1.0}).draw(
        "mpl", scale=0.5, fold=26
    )
)
Output:
Vacuum energy E_vac = 11.0+0.0j

Transpilation
Nun transpilieren wir die gesteuerten und die ungesteuerten Schaltungen, damit sie auf der Hardware ausgeführt werden können. Vergleichen wir das Ergebnis der transpilierten Schaltungen.
pass_manager = generate_preset_pass_manager(
    backend=backend,
    optimization_level=3,
)

isa_controlled_extended_swap_test = pass_manager.run(
    controlled_extended_swap_test
)

pass_manager = generate_preset_pass_manager(
    backend=backend, optimization_level=3, routing_method="none"
)
isa_optimized_extended_swap_test = pass_manager.run(
    optimized_extended_swap_test
)

transpilation_result = [
    {
        "label": "abstract controlled U(t)",
        **summarize_circuit(isa_controlled_extended_swap_test),
    },
    {
        "label": "optimized non-controlled U(t)",
        **summarize_circuit(isa_optimized_extended_swap_test),
    },
]

display(pd.DataFrame(transpilation_result))


def filter_qubits_from_layout(layout):
    q_layout = Layout(
        {
            physical: virtual
            for physical, virtual in layout.get_physical_bits().items()
            if virtual._register.name == "q"
        }
    )
    return q_layout


print(
    filter_qubits_from_layout(
        isa_optimized_extended_swap_test.layout.initial_layout
    )
)

isa_observables = [
    op.apply_layout(isa_optimized_extended_swap_test.layout)
    for op in observables
]
Output:
Layout({
18: <Qubit register=(13, "q"), index=0>,
5: <Qubit register=(13, "q"), index=1>,
6: <Qubit register=(13, "q"), index=2>,
7: <Qubit register=(13, "q"), index=3>,
8: <Qubit register=(13, "q"), index=4>,
9: <Qubit register=(13, "q"), index=5>,
10: <Qubit register=(13, "q"), index=6>,
11: <Qubit register=(13, "q"), index=7>,
12: <Qubit register=(13, "q"), index=8>,
13: <Qubit register=(13, "q"), index=9>,
14: <Qubit register=(13, "q"), index=10>,
15: <Qubit register=(13, "q"), index=11>,
19: <Qubit register=(13, "q"), index=12>
})
Schritt 3: Mit „ Qiskit primitives “ ausführen
Der nächste Schritt besteht darin, dieselbe parametrisierte Schaltung für mehrere Werte von zu betrachten. Für jeden Wert von schätzen wir vier Erwartungswerte: , , und . Diese vier Zahlen werden dann zu den komplexen Elementen der ersten Zeile und zusammengefasst.
Hier lassen sich und klassisch berechnen, da spärlich ist; daher überspringen wir den Fall .
pub_list = []
d_values = list(range(1, krylov_dim))

# Exact local statevector estimator.
estimator = StatevectorEstimator()

# We use the circuit before the transpilation for the local simulator,
# but we will use the transpiled circuit for the real backend.
for d in d_values:
    parameter_values = [d * dt]

    for ob in observables:
        pub_list.append(
            (
                optimized_extended_swap_test,
                ob,
                parameter_values,
            )
        )

job = estimator.run(pub_list)

# Local PrimitiveJob does not provide Runtime-style job inputs,
# so preserve the inputs directly.
inputs = pub_list
result = job.result()

print(f"Number of Krylov basis states: r = {len(d_values)}")
print(f"Number of PUBs: {len(pub_list)}")
print(f"Each d uses observables: {observable_labels}")
Output:
Number of Krylov basis states: r = 9
Number of PUBs: 36
Each d uses observables: ['Re S_0d', 'Im S_0d', 'Re shifted H_0d', 'Im shifted H_0d']
Schritt 4: Nachbearbeitung und Rückgabe des Ergebnisses im gewünschten klassischen Format
Nach der Schätzung der projizierten Matrizen führen wir eine Regularisierung durch und lösen das GEVP
Der kleinste verallgemeinerte Eigenwert liefert die KQD-Schätzung der Grundzustandsenergie.
h_shifted_row_est = np.zeros(krylov_dim, dtype=complex)
s_row_est = np.zeros(krylov_dim, dtype=complex)

h_shifted_row_est[0] = ref_energy - shift_tau
s_row_est[0] = 1.0

for idx, (pub_input, pub_result) in enumerate(zip(inputs, result)):
    d_index, obs_index = divmod(idx, len(observables))
    ev = np.asarray(pub_result.data.evs).reshape(-1)[0]
    std = np.asarray(pub_result.data.stds).reshape(-1)[0]

    if obs_index == 0:
        s_row_est[d_index + 1] = ev
    elif obs_index == 1:
        s_row_est[d_index + 1] += 1j * ev
    elif obs_index == 2:
        h_shifted_row_est[d_index + 1] = ev
    elif obs_index == 3:
        h_shifted_row_est[d_index + 1] += 1j * ev

# H_0d = shifted_H_0d + tau * S_0d.
h_row_est = h_shifted_row_est + shift_tau * s_row_est

h_matrix_est = la.toeplitz(h_row_est.conj(), h_row_est)
s_matrix_est = la.toeplitz(s_row_est.conj(), s_row_est)

s_eigvals = la.eigvalsh(0.5 * (s_matrix_est + s_matrix_est.conj().T))
positive_s_eigvals = s_eigvals[s_eigvals > 1e-12]
s_condition_number = (
    positive_s_eigvals[-1] / positive_s_eigvals[0]
    if len(positive_s_eigvals) > 0
    else np.inf
)


with np.printoptions(precision=3, suppress=True):
    print("Estimated first row of S:")
    print(s_row_est)
    print()
    print("Estimated first row of H:")
    print(h_row_est)
    print()
    print("Eigenvalues of the estimated overlap matrix S:")
    print(s_eigvals)
    print(f"Condition number above 1e-12: {s_condition_number:.3e}")
    print()
Output:
Estimated first row of S:
[ 1.   +0.j     0.758-0.596j  0.203-0.836j -0.291-0.636j -0.444-0.229j
 -0.276+0.053j -0.044+0.051j  0.006-0.121j -0.155-0.218j -0.345-0.101j]

Estimated first row of H:
[ 7.   +0.j     4.842-4.76j   0.044-6.185j -3.791-3.653j -4.137+0.39j
 -1.495+2.654j  1.331+1.777j  1.85 -0.763j -0.032-2.278j -2.222-1.372j]

Eigenvalues of the estimated overlap matrix S:
[-0.     0.     0.     0.     0.     0.     0.01   0.355  3.526  6.109]
Condition number above 1e-12: 1.904e+12
Nun lösen wir das verallgemeinerte Eigenwertproblem unter Verwendung der Matrizen, die aus den Schaltungsschätzungen rekonstruiert wurden. Bei einer idealen Zustandsvektorberechnung mit exakter Echtzeitentwicklung sollte dies das exakte projizierte Ergebnis wiedergeben. In der Praxis können Abweichungen durch Trotterisierung, Stichprobenfehler und numerische Instabilität der Überlappungsmatrix entstehen.
Wir beobachten, wie sich die Energie annähert, wenn wir die Dimension des Krylov-Unterraums erhöhen.
exact_evals = diagonalize_single_1_subspace(hamiltonian)
exact_ground = min(exact_evals)
print("exact ground state energy:  ", exact_ground)

threshold = 1e-12
energy_convergence = []

for r in range(1, krylov_dim + 1):
    energy_est_kqd, coeffs_est, retained_est = solve_thresholded_gevp(
        h_matrix_est[:r, :r],
        s_matrix_est[:r, :r],
        threshold=threshold,
    )
    energy_convergence.append(energy_est_kqd)
    print(
        f"Krylov ground state energy (dim={r}, retained={retained_est}): ",
        energy_est_kqd,
    )
Output:
exact ground state energy:   3.136296694843727
Krylov ground state energy (dim=1, retained=1):  7.0
Krylov ground state energy (dim=2, retained=2):  4.184510657551266
Krylov ground state energy (dim=3, retained=3):  3.5539074630394136
Krylov ground state energy (dim=4, retained=4):  3.3366270761341044
Krylov ground state energy (dim=5, retained=5):  3.252017453225087
Krylov ground state energy (dim=6, retained=6):  3.2300275138879186
Krylov ground state energy (dim=7, retained=7):  3.2299154099085685
Krylov ground state energy (dim=8, retained=7):  3.2298063744216776
Krylov ground state energy (dim=9, retained=7):  3.2296778282872456
Krylov ground state energy (dim=10, retained=8):  3.223647515867734
def plot_energy_convergence(energy_convergence, exact_ground, krylov_dim):
    fig, ax = plt.subplots(figsize=(7, 4.5))

    ax.plot(
        range(1, krylov_dim + 1),
        energy_convergence,
        marker="o",
        label="KQD estimate",
    )

    ax.axhline(
        exact_ground,
        linestyle="--",
        label=f"Exact ground energy = {exact_ground:.6f}",
    )

    ax.set_xlabel("Krylov dimension")
    ax.set_ylabel("Ground-state energy")
    ax.grid(True, alpha=0.3)
    ax.legend()
    plt.tight_layout()
    plt.show()


plot_energy_convergence(energy_convergence, exact_ground, krylov_dim)
Output:

Beispiel für groß angelegte Hardware
Im vorangegangenen Abschnitt wurde ein 12-Qubit-Modell verwendet, damit die Zustandsvektor-Simulation als Diagnoseinstrument dienen konnte. Nun skalieren wir denselben KQD-Workflow auf eine Heisenberg-Kette mit 30 Qubits und bereiten die Arbeitslast für die Ausführung auf der „ IBM Quantum “-Hardware vor.
Schritte 1–4 in einem einzigen Codeblock zusammengefasst
Hier führen wir nun all diese Details zu einem einzigen Workflow in größerem Maßstab zusammen, der anschließend auf unserer realen Quantenhardware ausgeführt wird. In diesem Abschnitt wenden wir realistische Einstellungen zur Fehlerminderung an, um die Zuverlässigkeit der Ergebnisse zu verbessern. Da die Matrixelemente, die verschiedenen Werten von entsprechen, parallel berechnet werden können, nutzen wir den Modus mode Batch, um sie effizient auszuführen.
# -------------------------Step 1-------------------------

# Map the classical problem to quantum circuits and observables.
# Problem and KQD parameters.
large_num_qubits = 30
large_krylov_dim = 7
large_num_trotter_steps = 3
large_dt = np.pi / (3 * (large_num_qubits - 1))
large_t = Parameter("t_large")

# Use a single excitation near the center of the chain.
large_excitation_qubit = large_num_qubits // 2
large_ref_label = ["0"] * large_num_qubits
large_ref_label[large_num_qubits - 1 - large_excitation_qubit] = "1"
large_ref_bitstring = "".join(large_ref_label)

# Use the ordering and product formula selected in the preceding section.
large_hamiltonian = make_heisenberg_hamiltonian_ordered(
    large_num_qubits,
    ordering="even-odd edge-grouped",
    coupling=1.0,
)
large_ref_energy = float(
    np.real(
        basis_state_expectation_sparse(large_hamiltonian, large_ref_bitstring)
    )
)
large_vacuum_energy = float(
    np.real(
        basis_state_expectation_sparse(
            large_hamiltonian, "0" * large_num_qubits
        )
    )
)

large_evolution_gate = PauliEvolutionGate(
    large_hamiltonian,
    time=large_t,
    synthesis=SuzukiTrotter(order=2, reps=large_num_trotter_steps),
)
large_uncontrolled_evolution = QuantumCircuit(
    large_num_qubits,
    name="U_ST2_large(t)",
)
large_uncontrolled_evolution.append(
    large_evolution_gate,
    range(large_num_qubits),
)

# Build the control-free extended-swap-test circuit.
large_ancilla = 0
large_system_qubits = list(range(1, large_num_qubits + 1))

large_controlled_state_prep = QuantumCircuit(
    large_num_qubits + 1,
    name="C-Prep-large",
)
large_controlled_state_prep.cx(
    large_ancilla,
    large_system_qubits[large_excitation_qubit],
)

large_extended_swap_test = QuantumCircuit(large_num_qubits + 1)
large_extended_swap_test.h(large_ancilla)
large_extended_swap_test.compose(large_controlled_state_prep, inplace=True)
large_extended_swap_test.compose(
    large_uncontrolled_evolution,
    qubits=large_system_qubits,
    inplace=True,
)
large_extended_swap_test.x(large_ancilla)
large_extended_swap_test.compose(
    large_controlled_state_prep.inverse(),
    inplace=True,
)
large_extended_swap_test.x(large_ancilla)
large_extended_swap_test.p(
    -large_vacuum_energy * large_t,
    large_ancilla,
)

# Reuse the Hamiltonian-shifting construction from the preceding section.
(
    large_obs_x_shifted_hamiltonian,
    large_obs_y_shifted_hamiltonian,
    large_shift_tau,
) = make_reduced_heisenberg_observables(large_ref_bitstring)

large_observables = [
    SparsePauliOp("I" * large_num_qubits + "X"),
    SparsePauliOp("I" * large_num_qubits + "Y"),
    large_obs_x_shifted_hamiltonian,
    large_obs_y_shifted_hamiltonian,
]
large_observable_labels = [
    "Re S_0d",
    "Im S_0d",
    "Re shifted H_0d",
    "Im shifted H_0d",
]

# -------------------------Step 2-------------------------

# Optimize the problem for quantum execution.
# Select a real backend and transpile the parameterized circuit to ISA form.
large_backend = service.backend("ibm_boston")
large_pass_manager = generate_preset_pass_manager(
    backend=large_backend, optimization_level=3, routing_method="none"
)
large_isa_circuit = large_pass_manager.run(large_extended_swap_test)
large_isa_observables = [
    observable.apply_layout(large_isa_circuit.layout)
    for observable in large_observables
]

large_two_qubit_gate_count = sum(
    instruction.operation.num_qubits == 2
    for instruction in large_isa_circuit.data
)

print(f"Backend: {large_backend.name}")
print(f"System qubits: {large_num_qubits}")
print(f"Total circuit qubits: {large_isa_circuit.num_qubits}")
print(f"Krylov dimension: {large_krylov_dim}")
print(f"Time step: {large_dt:.6f}")
print(f"Shift tau: {large_shift_tau}")
print(f"ISA circuit depth: {large_isa_circuit.depth()}")
print(f"ISA two-qubit gates: {large_two_qubit_gate_count}")
print(
    f"ISA two-qubit depth: {large_isa_circuit.depth(lambda x: x[0].num_qubits == 2)}"
)

# -------------------------Step 3-------------------------

# Execute on quantum hardware with Qiskit Runtime primitives.
# Submit one job per d, with all four observables in that job.
large_d_values = list(range(1, large_krylov_dim))
retrieve_batch_id = None
large_jobs = []

if retrieve_batch_id is None:
    large_estimator_options = {
        "default_shots": 8192,
        "dynamical_decoupling": {
            "enable": True,
            "sequence_type": "XpXm",
        },
        "resilience": {
            "measure_mitigation": True,
            "measure_noise_learning": {
                "num_randomizations": 32,
                "shots_per_randomization": 256,
            },
            "layer_noise_learning": {
                "max_layers_to_learn": 4,
                "layer_pair_depths": [0, 1, 2, 4, 16, 32],
                "num_randomizations": 32,
                "shots_per_randomization": 128,
            },
            "zne_mitigation": True,
            "zne": {
                "amplifier": "pea",
                "noise_factors": [1.0, 1.5, 2.0],
                "extrapolator": ("exponential", "linear"),
            },
        },
        "twirling": {
            "enable_gates": True,
            "enable_measure": True,
            "num_randomizations": 32,
            "shots_per_randomization": 256,
            "strategy": "active-accum",
        },
    }

    with Batch(backend=large_backend) as large_batch:
        large_batch_id = large_batch.session_id
        large_estimator = EstimatorV2(
            mode=large_batch,
            options=large_estimator_options,
        )
        # Krylov quantum diagonalization of lattice Hamiltonians -> TUT_KQDOLH.
        large_estimator.options.environment.job_tags = ["TUT_KQDOLH"]

        for d in large_d_values:
            parameter_values = [d * large_dt]
            pubs_for_d = [
                (large_isa_circuit, observable, parameter_values)
                for observable in large_isa_observables
            ]
            job = large_estimator.run(pubs_for_d)
            large_jobs.append(job)
            print(
                f"Submitted d={d}: job_id={job.job_id()}, "
                f"PUBs={len(pubs_for_d)}"
            )

    print(f"Batch ID: {large_batch_id}")
else:
    large_batch_id = retrieve_batch_id
    large_jobs = service.jobs(
        session_id=large_batch_id,
        limit=None,
        descending=False,
    )

large_job_ids_by_d = {
    d: job.job_id() for d, job in zip(large_d_values, large_jobs)
}
print(f"Job IDs by d: {large_job_ids_by_d}")

# -------------------------Step 4-------------------------

# Post-process the quantum results and solve the classical GEVP.
# Reconstruct the first rows of S and the shifted Hamiltonian matrix.
large_s_row_est = np.zeros(large_krylov_dim, dtype=complex)
large_h_shifted_row_est = np.zeros(large_krylov_dim, dtype=complex)
large_s_row_est[0] = 1.0
large_h_shifted_row_est[0] = large_ref_energy - large_shift_tau

for d, job in zip(large_d_values, large_jobs):
    job_result = job.result()

    if len(job_result) != len(large_observables):
        raise RuntimeError(
            f"Expected {len(large_observables)} PUB results for d={d}, "
            f"but received {len(job_result)}."
        )

    expectation_values = [
        np.asarray(pub_result.data.evs).reshape(-1)[0]
        for pub_result in job_result
    ]

    large_s_row_est[d] = expectation_values[0] + 1j * expectation_values[1]
    large_h_shifted_row_est[d] = (
        expectation_values[2] + 1j * expectation_values[3]
    )

# H_0d = shifted_H_0d + tau * S_0d.
large_h_row_est = large_h_shifted_row_est + large_shift_tau * large_s_row_est

large_s_matrix_est = la.toeplitz(
    large_s_row_est.conj(),
    large_s_row_est,
)
large_h_matrix_est = la.toeplitz(
    large_h_row_est.conj(),
    large_h_row_est,
)

large_exact_gnd = min(diagonalize_single_1_subspace(large_hamiltonian))

large_energy_convergence = []

with np.printoptions(precision=5, suppress=True):
    print("Estimated first row of S:")
    print(large_s_row_est)
    print("Estimated first row of H:")
    print(large_h_row_est)
    print("exact ground state energy:  ", large_exact_gnd)

    for r in range(1, large_krylov_dim + 1):
        energy_est_kqd, coeffs_est, retained_est = solve_thresholded_gevp(
            large_h_matrix_est[:r, :r],
            large_s_matrix_est[:r, :r],
            threshold=5e-2,
        )
        large_energy_convergence.append(energy_est_kqd)
        print(
            f"Krylov ground state energy (dim={r}, retained={retained_est}): ",
            energy_est_kqd,
        )

plot_energy_convergence(
    large_energy_convergence, large_exact_gnd, large_krylov_dim
)
Output:
Backend: ibm_boston
System qubits: 30
Total circuit qubits: 156
Krylov dimension: 7
Time step: 0.036110
Shift tau: 25.0
ISA circuit depth: 219
ISA two-qubit gates: 728
ISA two-qubit depth: 52
Job IDs by d: {1: 'd9fl4p4jeosc73fk4dg0', 2: 'd9fl4pineu4c739poecg', 3: 'd9fl4q2neu4c739poedg', 4: 'd9fl4qhhtsac739fjgn0', 5: 'd9fl4r4jeosc73fk4dhg', 6: 'd9fl4rkjeosc73fk4dj0'}
Estimated first row of S:
[ 1.     +0.j       0.42055-0.65466j -0.17883-0.73125j -0.64523-0.31601j
 -0.70781+0.55574j -0.02467+0.70525j  0.59301+0.55602j]
Estimated first row of H:
[ 25.      +0.j       10.3419 -16.5586j   -5.017  -18.03933j
 -16.44797 -6.98173j -17.17081+14.84502j   0.62722+17.81196j
  15.68886+12.74875j]
exact ground state energy:   21.021912418526902
Krylov ground state energy (dim=1, retained=1):  25.0
Krylov ground state energy (dim=2, retained=2):  24.432409110686205
Krylov ground state energy (dim=3, retained=3):  24.256856893278556
Krylov ground state energy (dim=4, retained=4):  23.727409826799715
Krylov ground state energy (dim=5, retained=4):  23.324720470780864
Krylov ground state energy (dim=6, retained=5):  21.91957579005085
Krylov ground state energy (dim=7, retained=5):  21.548331214122644

Anhang: Die Sichtweise der Hamilton-Funktion (Spektralfilter)
Der vorgestellte Hauptablauf veranschaulicht die praktische Anwendung von KQD: Erstellung einer Krylov-Basis aus in Echtzeit berechneten Zuständen, Schätzung der projizierten Matrizen und sowie Lösung des GEVP. In diesem Anhang wird dieselbe Berechnung aus einem ergänzenden Blickwinkel betrachtet, der erklärt, warum KQD funktioniert: aus der Perspektive der Hamilton-Funktion bzw. des Spektralfilters [3], [5]. Es greift auf das 12-Qubit-Modell, die Zeitschritt- und die oben bereits ermittelte Krylov-Lösung zurück; eine erneute Schaltungsausführung ist nicht erforderlich.
Der Referenzzustand als Energieverteilung
Sei die Eigenwertzerlegung des Hamilton-Operators
mit den Energieeigenzuständen . Jeder Referenzzustand lässt sich in dieser Eigenbasis entwickeln,
Daher weist sie bei jedem Energie ein Spektralgewicht auf. Die Referenzenergie ist der Mittelwert dieser Verteilung, .
Die Eigenwertzerlegung eines allgemeinen Hamilton-Operators vom Typ „ “-Qubit ist exponentiell aufwendig, daher dient dieses Bild lediglich der Diagnose und ist nicht Bestandteil des Algorithmus. Hier können wir dies jedoch für dasselbe Problem „ “ kostengünstig berechnen: Der Heisenberg-Hamiltonoperator bewahrt die Gesamtanzahl der Anregungen, und die Referenzverteilung weist eine einzige Anregung auf, sodass ihr gesamter Spektralinhalt im Unterraum der einzelnen Anregung liegt, dessen Dimension nur linear mit wächst. Wir verwenden daher erneut den exakten Block für eine einzelne Anregung (der oben bereits als Benchmark verwendet wurde) und lesen die Referenzverteilung innerhalb dieses Unterraums ab.
# Exact single-excitation-subspace decomposition of the reference state.
# This reuses make_heisenberg_hamiltonian / _basis_state_transition_amplitude_sparse
# and the n=12 `hamiltonian` and `ref_bitstring` defined in the small-scale example.
single_excitation_states = [1 << k for k in range(num_qubits)]

h_single = np.array(
    [
        [
            _basis_state_transition_amplitude_sparse(hamiltonian, bra, ket)
            for ket in single_excitation_states
        ]
        for bra in single_excitation_states
    ]
)
h_single = 0.5 * (h_single + h_single.conj().T)

subspace_evals, subspace_evecs = la.eigh(h_single)
subspace_evals = np.real(subspace_evals)

# Reference-state coordinates inside the single-excitation subspace.
ref_position = single_excitation_states.index(int(ref_bitstring, 2))
ref_in_subspace = np.zeros(num_qubits, dtype=complex)
ref_in_subspace[ref_position] = 1.0

# Amplitudes and spectral weights of the reference in the energy eigenbasis.
ref_eigen_amplitudes = subspace_evecs.conj().T @ ref_in_subspace
ref_spectral_weights = np.abs(ref_eigen_amplitudes) ** 2

print(f"Single-excitation subspace dimension: {num_qubits}")
print(f"Subspace ground-state energy:         {subspace_evals[0]:.6f}")
print(
    f"Reference energy (sum p_m E_m):       {np.sum(ref_spectral_weights * subspace_evals):.6f}"
)
print(f"Reference weight on subspace ground:  {ref_spectral_weights[0]:.6f}")
Output:
Single-excitation subspace dimension: 12
Subspace ground-state energy:         3.136297
Reference energy (sum p_m E_m):       7.000000
Reference weight on subspace ground:  0.163827
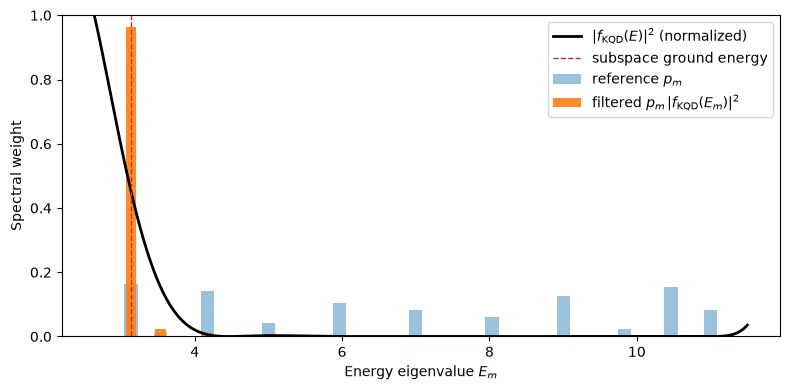
KQD trainiert einen Filter, der diese Verteilung umformt
Eine Hamilton-Funktion wird mittels Spektralrechnung definiert,
oder, mit anderen Worten, eine gewichtete Summe von Eigenprojektoren. Wird dies auf die Referenz angewendet, wird jede Spektralamplitude umgestaltet, :
Wenn „ “ bei der niedrigsten Energie eine scharfe Spitze aufweisen würde (ansonsten „ “ und „ “), würde „ “ als Grundzustands-Projektor fungieren, und die normierte Ausgabe wäre (nahezu) der Grundzustand. Daher ist ein guter energiespektraler Tiefpassfilter genau das, was wir brauchen.
KQD schreibt „ “ nicht im Voraus vor. Stattdessen erweitert es den Filter auf der Basis der Echtzeitentwicklung,
eine trigonometrische Funktion der Energie, deren Koeffizienten genau dem oben ermittelten GEVP-Eigenvektor entsprechen. Die Minimierung des Rayleigh-Quotienten entspricht daher dem Erlernen des Filters, der das Gewicht des angeregten Zustands der Referenz am besten unterdrückt. Ein größeres Krylov- s verleiht dem Filter mehr Freiheitsgrade und einen schärferen Peak bei der Grundzustandsenergie.
Der folgende Helper wertet diesen trainierten Filter auf einer Energieachse aus; anschließend wenden wir ihn auf die oben ermittelte Referenzverteilung an.
def trigonometric_krylov_filter(
    coeffs: np.ndarray,
    energies: np.ndarray,
    time_step: float,
) -> np.ndarray:
    """Evaluate the learned Krylov filter f(E) = sum_l c_l exp(-i l dt E)."""
    values = np.zeros_like(energies, dtype=complex)
    for ell, coeff in enumerate(coeffs):
        values += coeff * np.exp(-1j * ell * time_step * energies)
    return values


def filtered_spectral_weights(
    weights: np.ndarray,
    filter_values: np.ndarray,
) -> np.ndarray:
    """Reshape spectral weights by |f(E)|^2 and renormalize."""
    reshaped = weights * np.abs(filter_values) ** 2
    return reshaped / np.sum(reshaped)


# Recover the KQD coefficients from the already-estimated projected matrices.
# The shift only moves H by tau * S, so it does not change the GEVP eigenvector;
# we solve at the full Krylov dimension used in the small-scale example.
_, kqd_coeffs, _ = solve_thresholded_gevp(
    h_matrix_est,
    s_matrix_est,
    threshold=1e-12,
)

filter_on_spectrum = trigonometric_krylov_filter(
    kqd_coeffs, subspace_evals, dt
)
filtered_weights = filtered_spectral_weights(
    ref_spectral_weights, filter_on_spectrum
)

print(f"Ground-state overlap  (reference): {ref_spectral_weights[0]:.4f}")
print(f"Ground-state overlap  (filtered):  {filtered_weights[0]:.4f}")
print(
    f"Mean energy           (reference): {np.sum(ref_spectral_weights * subspace_evals):.6f}"
)
print(
    f"Mean energy           (filtered):  {np.sum(filtered_weights * subspace_evals):.6f}"
)
Output:
Ground-state overlap  (reference): 0.1638
Ground-state overlap  (filtered):  0.9638
Mean energy           (reference): 7.000000
Mean energy           (filtered):  3.164503
Stellen Sie sich den Filter und seine Flexibilität vor
Zunächst zeigen wir den trainierten Filter bei der oben verwendeten vollen Krylov-Dimension und verfolgen dann, wie er mit zunehmender Dimension an Schärfe gewinnt.
Die Balken zeigen die Referenz-Spektralgewichte (vorher) und die gefilterten Gewichte (nachher) zusammen mit der gelernten Filterintensität auf einer kontinuierlichen Energieachse. Der Filter konzentriert das Gewicht auf die niedrigste Energie des Unterraums mit Einzelanregung – dieselbe Energie, zu der die KQD-Schätzung im Beispiel mit kleinem Maßstab konvergierte. Beachten Sie, dass es sich hierbei um den Grundzustand innerhalb des Sektors mit einer einzigen Anregung handelt, der für diesen anregungserhaltenden Referenzzustand relevant ist, und nicht um den globalen Grundzustand.
fig, ax = plt.subplots(figsize=(8, 4))

visible = (ref_spectral_weights > 1e-4) | (filtered_weights > 1e-4)
ax.bar(
    subspace_evals[visible],
    ref_spectral_weights[visible],
    width=0.18,
    alpha=0.45,
    label="reference $p_m$",
)
ax.bar(
    subspace_evals[visible],
    filtered_weights[visible],
    width=0.14,
    alpha=0.9,
    label=r"filtered $p_m\,|f_{\rm KQD}(E_m)|^2$",
)

energy_grid = np.linspace(
    subspace_evals.min() - 0.5, subspace_evals.max() + 0.5, 800
)
filter_intensity = (
    np.abs(trigonometric_krylov_filter(kqd_coeffs, energy_grid, dt)) ** 2
)
filter_intensity /= filter_intensity.max()
ax.plot(
    energy_grid,
    filter_intensity,
    color="k",
    linewidth=2,
    label=r"$|f_{\rm KQD}(E)|^2$ (normalized)",
)

ax.axvline(
    subspace_evals[0],
    color="C3",
    linestyle="--",
    linewidth=1,
    label="subspace ground energy",
)
ax.set_xlabel("Energy eigenvalue $E_m$")
ax.set_ylabel("Spectral weight")
ax.set_ylim(0, 1)
ax.legend(loc="upper right")
plt.tight_layout()
plt.show()
Output:
Erhöhung der Krylov-Dimension: Flexibilität der gelernten Funktion
Zur Erinnerung: Der trainierte Filter ist ein trigonometrisches Polynom in der Energie mit Koeffizienten der Form ,
Die Krylov-Dimension entspricht genau der Anzahl der freien Koeffizienten und bestimmt somit die Flexibilität der Funktion. Ein kleiner „ “ kann nur einen breiten, sanft variierenden Filter erzeugen, der Gewicht in tiefer liegende angeregte Zustände abfließen lässt; wenn die „ “ zunimmt, kann der Filter einen schmaleren Peak bei der Zielenergie bilden und das verbleibende Gewicht der angeregten Zustände stärker unterdrücken. Dies ist das spektrale Filter-Äquivalent der im Beispiel mit kleinen Skalen beobachteten Energiekonvergenz: Mit zunehmendem Wert von kollabiert die gefilterte Verteilung auf den Grundzustand des Unterraums, und die geschätzte Energie nähert sich diesem Wert an.
Wir verwenden die oben bereits geschätzten Projektionsmatrizen erneut und lösen einfach das GEVP bei jedem führenden „ “-Block, um anschließend den entsprechenden Filter zu berechnen und grafisch darzustellen.
# Sweep the Krylov dimension using the leading r x r blocks of the estimated matrices.
sweep_dims = [r for r in (2, 4, 6, 8, krylov_dim) if r <= krylov_dim]
sweep_dims = sorted(set(sweep_dims))

energy_grid = np.linspace(
    subspace_evals.min() - 0.5, subspace_evals.max() + 0.5, 800
)

sweep_cases = []
print(" r    retained    ground overlap    filtered energy")
print("--    --------    --------------    ---------------")
for r in sweep_dims:
    _, coeffs_r, retained_r = solve_thresholded_gevp(
        h_matrix_est[:r, :r],
        s_matrix_est[:r, :r],
        threshold=1e-12,
    )
    filter_on_spectrum_r = trigonometric_krylov_filter(
        coeffs_r, subspace_evals, dt
    )
    filtered_weights_r = filtered_spectral_weights(
        ref_spectral_weights, filter_on_spectrum_r
    )
    filtered_energy_r = float(np.sum(filtered_weights_r * subspace_evals))

    sweep_cases.append((r, coeffs_r, filtered_weights_r))
    print(
        f"{r:2d}    {retained_r:8d}    {filtered_weights_r[0]:14.4f}    {filtered_energy_r:15.6f}"
    )

print(f"\nSubspace ground-state energy (target): {subspace_evals[0]:.6f}")

# One panel per Krylov dimension: filtered spectrum (bars) + filter intensity (curve).
fig, axes = plt.subplots(
    len(sweep_cases),
    1,
    figsize=(8, 2.1 * len(sweep_cases)),
    sharex=True,
)
axes = np.atleast_1d(axes)

for idx, (ax, (r, coeffs_r, filtered_weights_r)) in enumerate(
    zip(axes, sweep_cases)
):
    visible = (ref_spectral_weights > 1e-4) | (filtered_weights_r > 1e-4)
    ax.bar(
        subspace_evals[visible],
        ref_spectral_weights[visible],
        width=0.18,
        alpha=0.35,
        color="C0",
        label="reference $p_m$" if idx == 0 else None,
    )
    ax.bar(
        subspace_evals[visible],
        filtered_weights_r[visible],
        width=0.14,
        alpha=0.9,
        color="C1",
        label="filtered weights" if idx == 0 else None,
    )

    filter_intensity_r = (
        np.abs(trigonometric_krylov_filter(coeffs_r, energy_grid, dt)) ** 2
    )
    filter_intensity_r /= filter_intensity_r.max()
    ax.plot(energy_grid, filter_intensity_r, color="k", linewidth=2)

    ax.axvline(subspace_evals[0], color="C3", linestyle="--", linewidth=1)
    ax.set_ylim(0, 1)
    ax.set_ylabel("weight")
    ax.legend(loc="upper right", title=f"$r={r}$")

axes[-1].set_xlabel("Energy eigenvalue $E_m$")
fig.suptitle(
    r"KQD-learned filter $|f_{\rm KQD}(E)|^2$ sharpening with Krylov dimension $r$",
    y=1.0,
)
fig.tight_layout()
plt.show()
Output:
 r    retained    ground overlap    filtered energy
--    --------    --------------    ---------------
 2           2            0.4549           4.184510
 4           4            0.8373           3.310168
 6           6            0.9706           3.158100
 8           7            0.9701           3.158725
10           8            0.9638           3.164503

Subspace ground-state energy (target): 3.136297

Nächste Schritte
Wenn Sie diese Arbeit interessant fanden, könnten Sie auch an folgenden Materialien interessiert sein:
Referenzen
[1] E. N. Epperly, L. Lin und Y. Nakatsukasa, Eine Theorie zur Diagonalisierung von Quantenunterräumen, SIAM Journal on Matrix Analysis and Applications 43, 1263–1290 (2022).
[2] N. Yoshioka, M., Amico, W., Kirby u. a., Diagonalisierung großer Vielteilchen-Hamilton-Operatoren auf einem Quantenprozessor, arXiv:2407.14431 (2024).
[3] R. M. Parrish und P. L. McMahon, Diagonalisierung von Quantenfiltern: Quanten-Eigenwertzerlegung ohne vollständige Quantphasenschätzung, Physical Review Letters 122, 230401 (2019).
[4] G. Lee, S. Choi, J. Huh und AF Izmaylov, Effiziente Strategien zur Reduzierung des Abtastfehlers bei der Quanten-Krylov-Unterraum-Diagonalisierung, Digital Discovery 4, 954-969 (2025).
[5] G. Lee, M. Kang, J. Hong, S. Fomichev und J. Hm, „Filtered Quantum Phase Estimation“, arXiv:2510.04294 (2025).