Näherungsweiser Quanten-Optimierungsalgorithmus
Geschätzte Nutzungsdauer: 22 Minuten auf einem Heron r3 Prozessor (HINWEIS: Dies ist nur eine Schätzung. Ihre Laufzeit kann variieren.)
Lernziele
- Wie man ein klassisches kombinatorisches Optimierungsproblem (Max-Cut) auf einen Quanten-Hamiltonian abbildet
- So implementieren und führen Sie den Quantum Approximate Optimization Algorithm (QAOA) mithilfe von Sitzungen des „ IBM Quantum “-Compute-Service aus
- Wie man einen QAOA-Workflow von einem kleinen Simulatorbeispiel auf die Ausführung auf Hardware im industriellen Maßstab skaliert
Voraussetzungen
- Grundlagen von Quantenschaltungen
- Variationsalgorithmen
- QAOA im Detail – eine umfassende Darstellung des QAOA-Algorithmus und seiner Anwendung im großtechnischen Maßstab
Hintergrund
Der Quantum Approximate Optimization Algorithm (QAOA) ist ein hybrides, iteratives Verfahren, das Quanten- und klassische Methoden kombiniert, um kombinatorische Optimierungsprobleme zu lösen. In diesem Tutorial werden Sie QAOA einsetzen, um das Maximum-Cut- Problem (Max-Cut) zu lösen – ein NP-schweres Optimierungsproblem mit Anwendungen in den Bereichen Clustering, Netzwerkwissenschaft und statistische Physik. Gegeben sei ein Graph aus Knoten, die durch Kanten verbunden sind. Das Ziel besteht darin, die Knoten in zwei Mengen zu unterteilen, sodass die Anzahl der Kanten, die die Teilung kreuzen, maximiert wird.
Die kombinatorische Optimierung spielt auch bei Herausforderungen im Bereich der Nachhaltigkeit eine Rolle, beispielsweise bei der Planung von Lieferrouten zur Senkung des Kraftstoffverbrauchs und bei der Zuweisung von Ressourcen zur Vermeidung von Materialverschwendung. Das Max-Cut-Beispiel vermittelt, wie man ein Ziel als Kosten-Hamiltonian formuliert und mit QAOA mögliche Lösungen untersucht. Um diesen Ansatz auf ein Nachhaltigkeitsproblem anzuwenden, sind ein Ziel und Randbedingungen erforderlich, die die beabsichtigte Anwendung widerspiegeln.
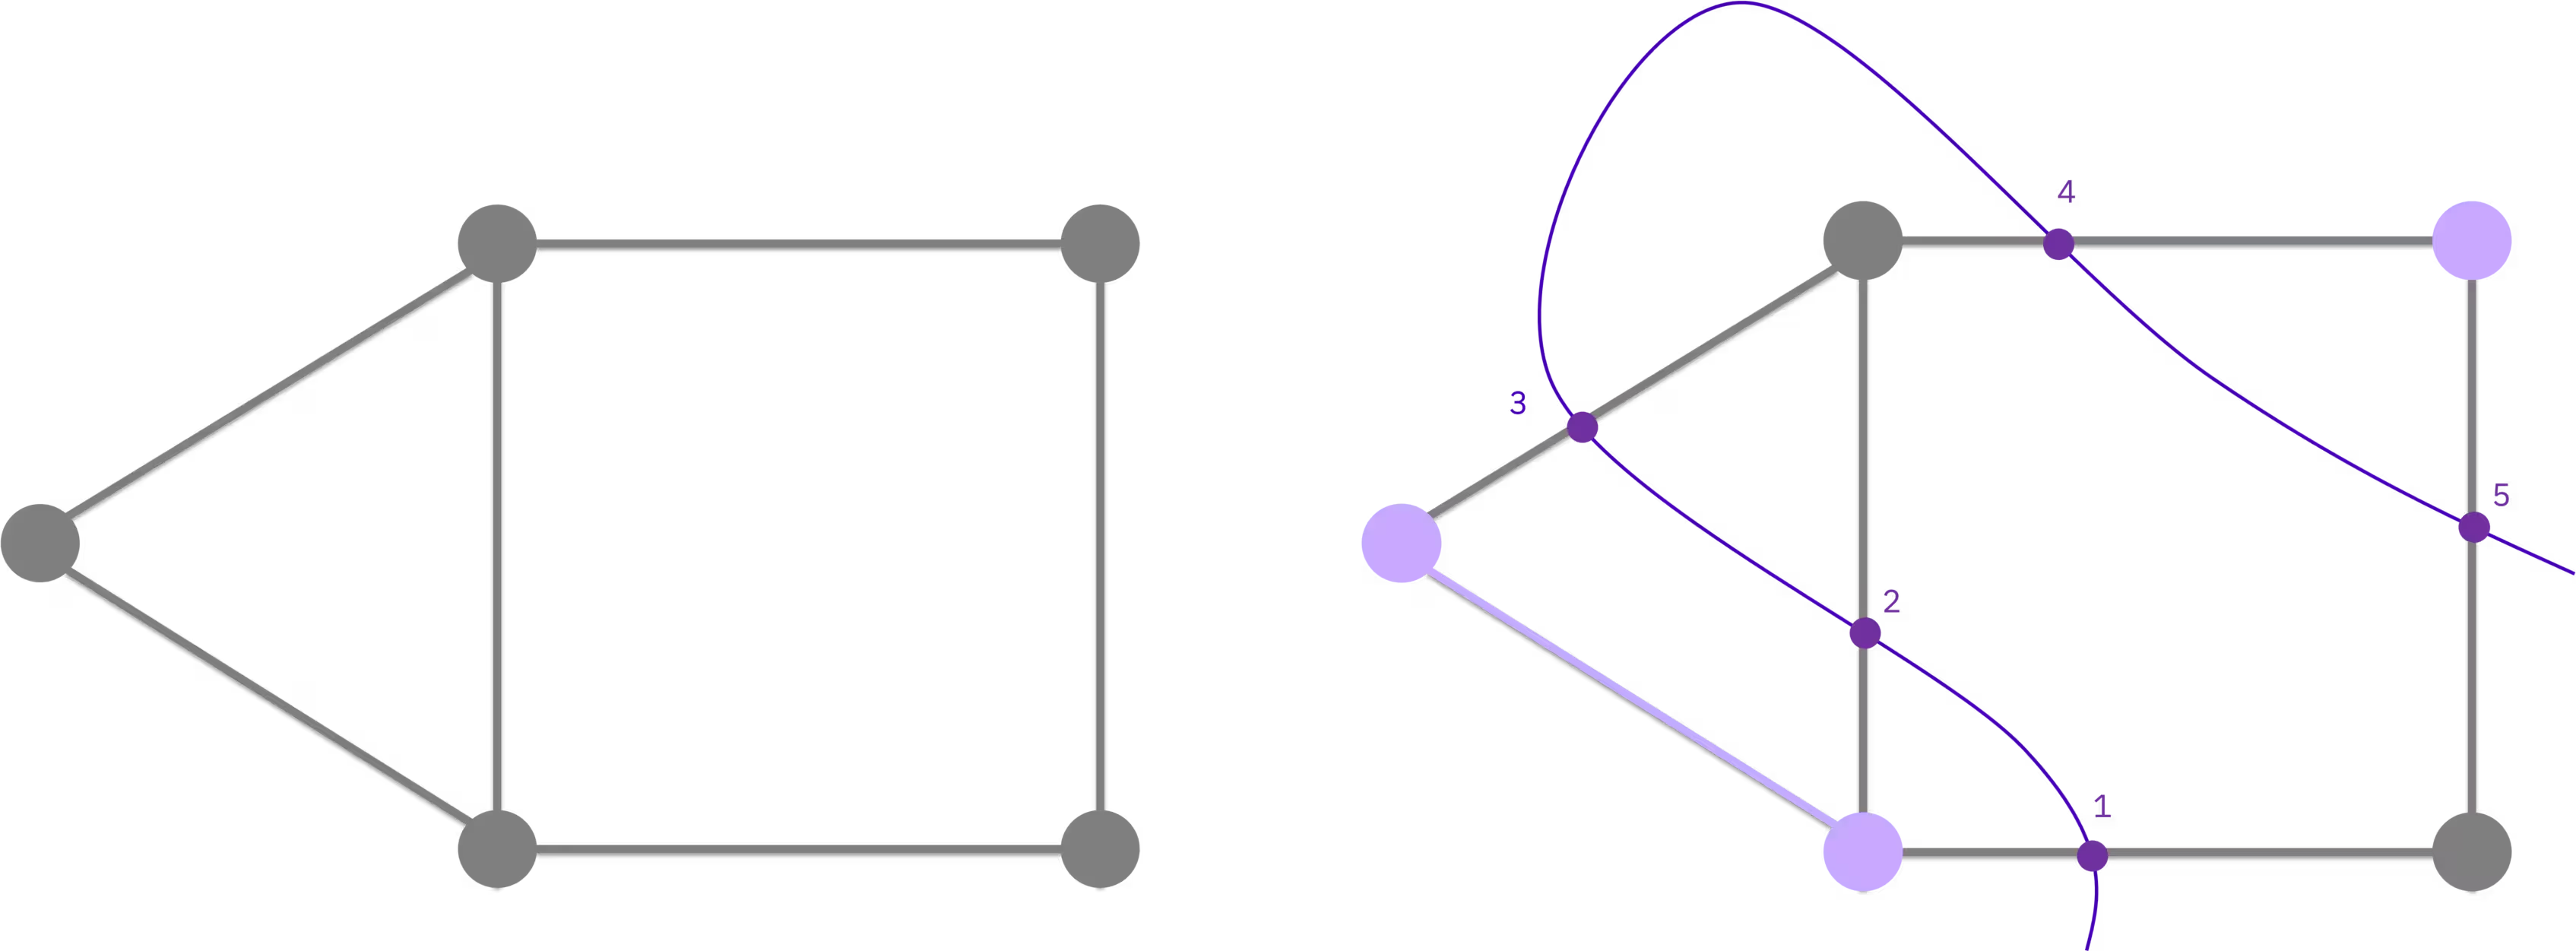
Von der klassischen Optimierung zu Quantenschaltungen
Max-Cut lässt sich als klassisches binäres Optimierungsproblem formulieren. Jedem Knoten wird eine binäre Variable „ “ zugewiesen, die angibt, zu welcher Menge er gehört. Das Ziel besteht darin, die Anzahl der Kanten zu maximieren, deren Endpunkte zu unterschiedlichen Mengen gehören:
Dies entspricht einem quadratischen, uneingeschränkten binären Optimierungsproblem (QUBO) der Form . Durch eine Standard-Variablensubstitution ( ) lässt sich das QUBO als Kostenhamiltonian umschreiben, dessen Grundzustand die optimale Lösung kodiert. Im Allgemeinen enthält dieser Hamilton-Operator sowohl quadratische als auch lineare Terme:
Für das hier betrachtete ungewichtete Max-Cut-Problem gehen die linearen Koeffizienten gegen Null ( ) und gilt für jede Kante , was die einfachere Form ergibt, die Sie im folgenden Code umsetzen werden. Die oben genannte allgemeinere Form ist das, was Sie benötigen, um diesen Arbeitsablauf an gewichtete Graphen oder andere QUBO-darstellbare Probleme anzupassen.
So funktioniert QAOA
QAOA erstellt Lösungsvorschläge, indem es abwechselnd Schichten zweier Operatoren auf einen anfänglichen Überlagerungszustand anwendet: den Kostenoperator und einen Mischoperator . Die Winkel und werden in einer klassischen Rückkopplungsschleife optimiert; der Quantencomputer berechnet die Kostenfunktion, und ein klassischer Optimierer aktualisiert die Parameter bis zur Konvergenz. Diese iterative Schleife wird innerhalb einer Quantum-Compute- Sitzung ausgeführt, wodurch das Quantencomputer-Gerät über alle Iterationen hinweg reserviert bleibt, um eine geringere Latenz zu gewährleisten.
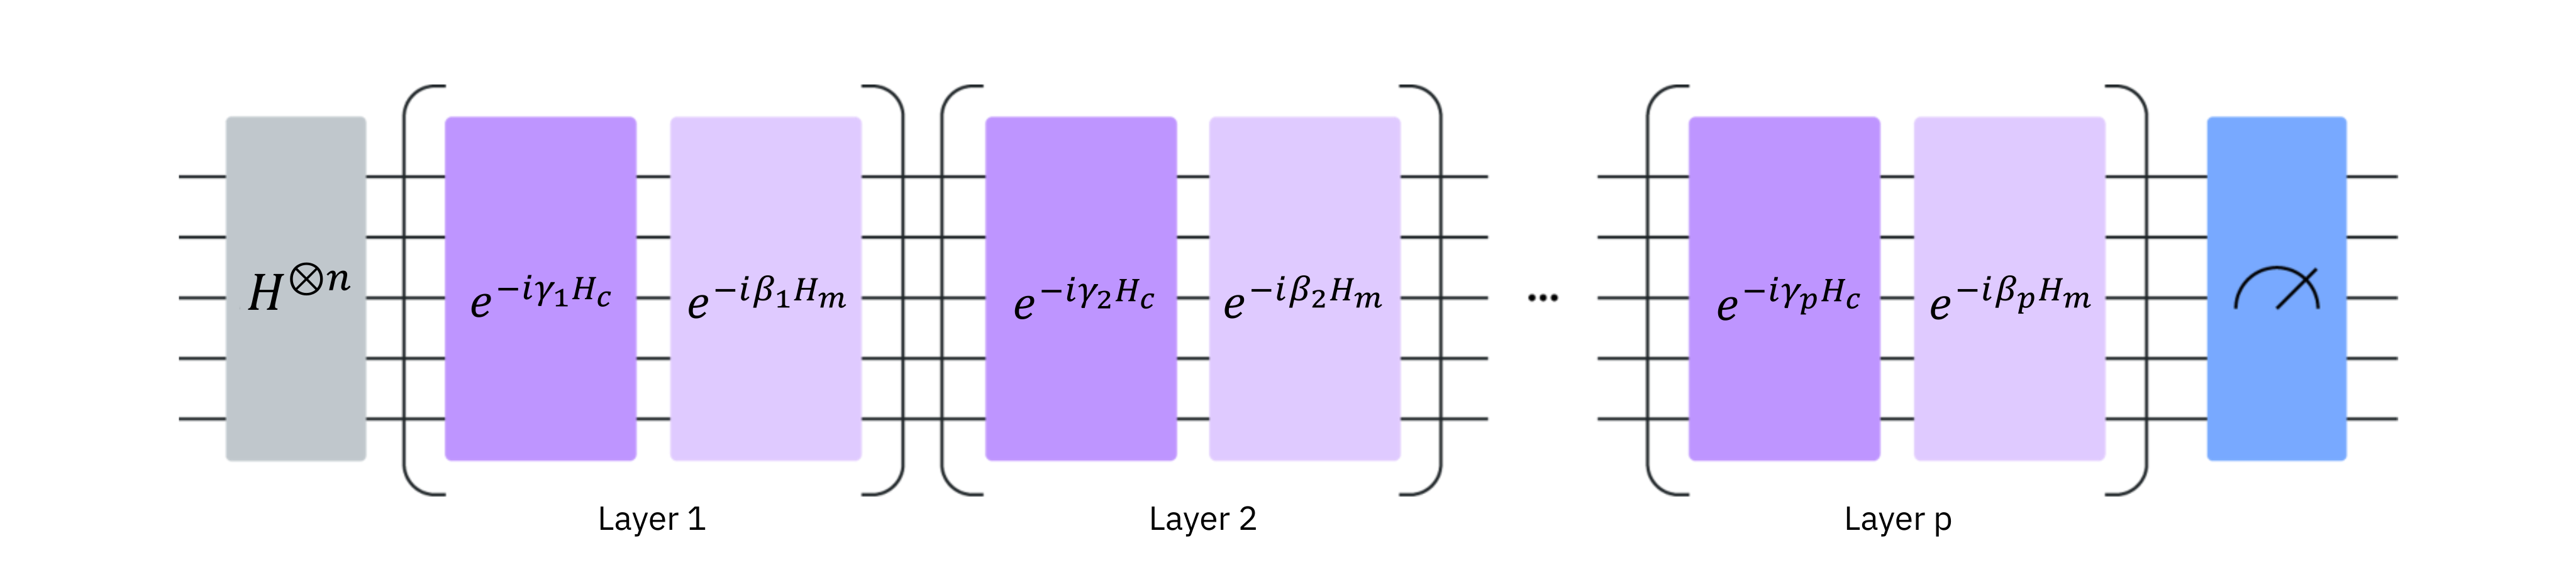
Eine ausführlichere Darstellung der QAOA-Theorie, einschließlich der vollständigen Herleitung vom QUBO zum Hamilton-Operator, finden Sie im QAOA-Kursmodul.
In diesem Tutorial lösen Sie zunächst das Max-Cut-Problem an einem kleinen Graphen mit fünf Knoten und skalieren anschließend denselben Arbeitsablauf auf ein Problem im industriellen Maßstab mit 100 Knoten auf echter Hardware. Hinweis zum Tarifzugang: In diesem Tutorial werden Quantum Compute -Sitzungen verwendet, die nur im Premium-Tarif verfügbar sind. Wenn Sie den „Open Plan“-Tarif nutzen, können Sie dieses Tutorial nicht wie beschrieben ausführen; stattdessen müssen Sie Session auf den Job-Modus umstellen (d. h., jede Iteration als eigenständigen Job einreichen, anstatt die Optimierungsschleife mit zu umschließen Session(...)). Der Workflow läuft zwar weiterhin, aber bei jeder Iteration entsteht die volle Warteschlangenlatenz, anstatt ein reserviertes Gerät wiederzuverwenden. Weitere Informationen finden Sie unter „Übersicht über die verfügbaren Tarife “.
Anforderungen
Bevor Sie mit diesem Tutorial beginnen, sollten Sie sicherstellen, dass Sie Folgendes installiert haben:
- Qiskit SDK v2.0 oder höher, mit Visual isierungsunterstützung
- Qiskit Runtime v0.22 oder später (
pip install qiskit-ibm-runtime)
Außerdem benötigen Sie Zugriff auf eine Instanz unter IBM Quantum® Platform.
Einrichtung
import matplotlib.pyplot as plt
import rustworkx as rx
from rustworkx.visualization import mpl_draw as draw_graph
import numpy as np
from scipy.optimize import minimize
from collections import defaultdict
from typing import Sequence


from qiskit.quantum_info import SparsePauliOp
from qiskit.circuit.library import QAOAAnsatz
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import Session, EstimatorV2 as Estimator
from qiskit_ibm_runtime import SamplerV2 as Sampler
Ein kleines Beispiel
In diesem Abschnitt wird jeder Schritt des QAOA-Workflows anhand einer kleinen Max-Cut-Instanz mit fünf Knoten erläutert. Trotz der Bezeichnung „im kleinen Maßstab“ läuft dieses Beispiel dennoch auf echter „ IBM Quantum “-Hardware – der Code wählt ein Backend mit 127 oder mehr Qubits aus und führt den Schaltkreis dort aus.
Initialisieren Sie Ihr Problem, indem Sie einen Graphen mit Knoten erstellen.
n_small = 5

graph = rx.PyGraph()
graph.add_nodes_from(np.arange(0, n_small, 1))
edge_list = [
    (0, 1, 1.0),
    (0, 2, 1.0),
    (0, 4, 1.0),
    (1, 2, 1.0),
    (2, 3, 1.0),
    (3, 4, 1.0),
]
graph.add_edges_from(edge_list)
draw_graph(graph, node_size=600, with_labels=True)
Output:
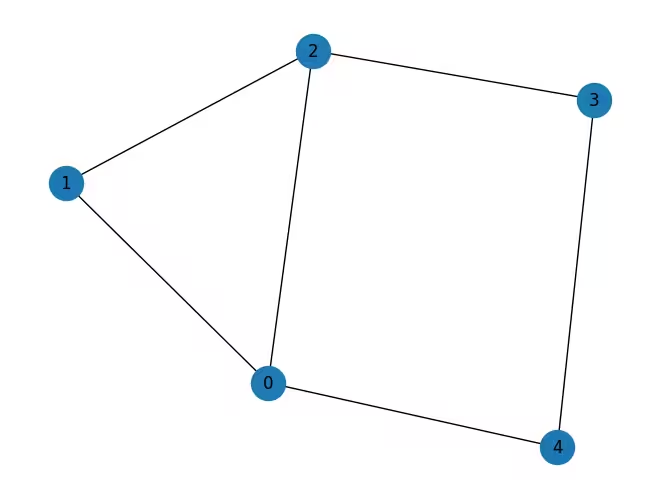
Schritt 1: Klassische Eingaben einem Quantenproblem zuordnen
Stelle den klassischen Graphen als Quantenschaltungen und -operatoren dar. Wie im Hintergrund beschrieben, reduziert sich der Kosten-Hamiltonian für den ungewichteten Max-Cut auf , und QAOA verwendet eine parametrisierte Ansatzschaltung, um Kandidaten für Grundzustände von zu erzeugen.
Erstellen Sie den Kostenhamiltonian
Wandle die Kanten des Graphen in Pauli- -Terme um, um die zu konstruieren (siehe „Hintergrund“ für die Herleitung).
def build_max_cut_paulis(
    graph: rx.PyGraph,
) -> list[tuple[str, list[int], float]]:
    """Convert graph edges to a list of ZZ Pauli terms.

    The returned list is in the sparse format expected by
    ``SparsePauliOp.from_sparse_list``: each element is
    ``(pauli_string, qubit_indices, coefficient)``.
    """
    pauli_list = []
    for edge in list(graph.edge_list()):
        weight = graph.get_edge_data(edge[0], edge[1])
        pauli_list.append(("ZZ", [edge[0], edge[1]], weight))
    return pauli_list


max_cut_paulis = build_max_cut_paulis(graph)
cost_hamiltonian = SparsePauliOp.from_sparse_list(max_cut_paulis, n_small)
print("Cost Function Hamiltonian:", cost_hamiltonian)
Output:
Cost Function Hamiltonian: SparsePauliOp(['IIIZZ', 'IIZIZ', 'ZIIIZ', 'IIZZI', 'IZZII', 'ZZIII'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])
Bau die QAOA-Ansatzschaltung
Verwenden QAOAAnsatz Sie, um die parametrisierte QAOA-Schaltung aus dem Kosten-Hamilton-Operator zu konstruieren. Hier verwenden reps=2 wir (zwei QAOA-Schichten, vier Parameter: ).
circuit = QAOAAnsatz(cost_operator=cost_hamiltonian, reps=2)
circuit.measure_all()

circuit.draw("mpl")
Output:

circuit.parametersOutput:
ParameterView([ParameterVectorElement(β[0]), ParameterVectorElement(β[1]), ParameterVectorElement(γ[0]), ParameterVectorElement(γ[1])])
Schritt 2: Optimierung des Problems für die Ausführung auf Quantenhardware
Die abstrakte Schaltung in hardwarenahe Befehle umwandeln. Dieser Schritt umfasst die Quantenbit-Zuordnung, die Gatterzerlegung, die Routing-Verarbeitung und die Fehlerunterdrückung. Weitere Informationen finden Sie in der Dokumentation zur Transpilierung.
service = QiskitRuntimeService()
backend = service.least_busy(
    operational=True, simulator=False, min_num_qubits=127
)
print(backend)

# Create pass manager for transpilation. Level 3 is the most aggressive
# preset: slower to transpile, but produces shorter circuits that are
# more robust to hardware noise.
pm = generate_preset_pass_manager(optimization_level=3, backend=backend)

candidate_circuit = pm.run(circuit)
candidate_circuit.draw("mpl", fold=False, idle_wires=False)
Output:
<IBMBackend('ibm_pittsburgh')>

Schritt 3: Mit „ Qiskit primitives “ ausführen
Die QAOA-Optimierungsschleife wird innerhalb einer Quantum Compute -Sitzung ausgeführt, damit das Gerät über alle Iterationen hinweg reserviert bleibt. Ein Schätzer berechnet bei jedem Schritt , und ein klassischer Optimierer (COBYLA) aktualisiert die Parameter bis zur Konvergenz.
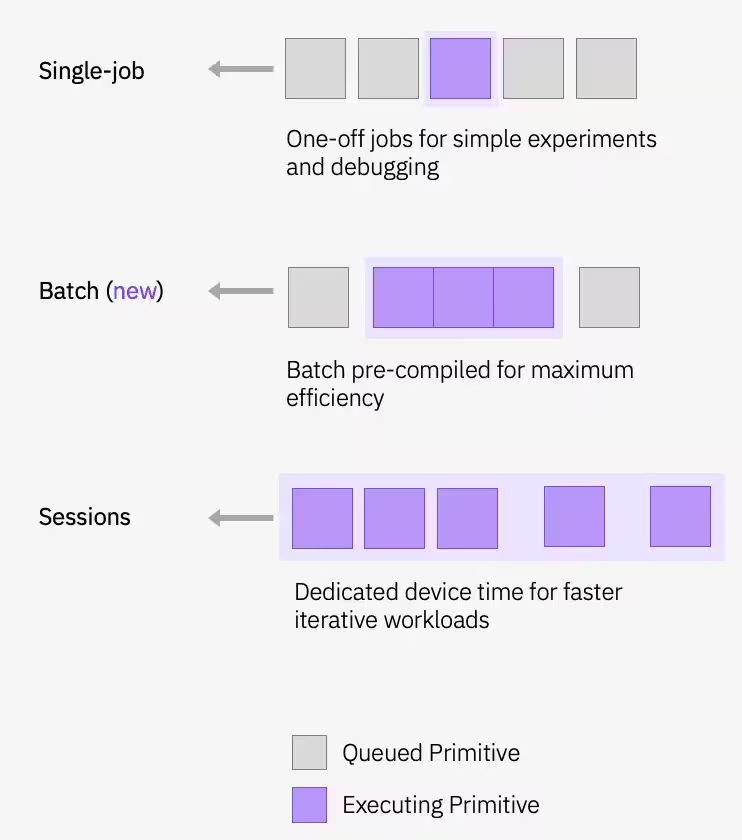
Legen Sie die Anfangsparameter fest und führen Sie die Optimierungsschleife aus:
# QAOA doesn't prescribe principled default angles — any bounded choice
# works as a warm start for problems this small. beta and gamma are
# periodic (beta in [0, pi] and gamma in [0, 2*pi] modulo the underlying
# Pauli-rotation periods), and pi/2 and pi are just midpoints of those
# ranges. For harder problems you would typically warm start from known
# good angles or transfer parameters from smaller instances.
initial_gamma = np.pi
initial_beta = np.pi / 2
init_params = [initial_beta, initial_beta, initial_gamma, initial_gamma]
def cost_func_estimator(params, ansatz, hamiltonian, estimator):
# transform the observable defined on virtual qubits to
# an observable defined on all physical qubits
isa_hamiltonian = hamiltonian.apply_layout(ansatz.layout)
pub = (ansatz, isa_hamiltonian, params)
job = estimator.run([pub])
results = job.result()[0]
cost = results.data.evs
objective_func_vals.append(cost)
return costobjective_func_vals = [] # Global variable
with Session(backend=backend) as session:
# If using qiskit-ibm-runtime<0.24.0, change `mode=` to `session=`
estimator = Estimator(mode=session)
estimator.options.default_shots = 1000
# Set simple error suppression/mitigation options
estimator.options.dynamical_decoupling.enable = True
estimator.options.dynamical_decoupling.sequence_type = "XY4"
estimator.options.twirling.enable_gates = True
estimator.options.twirling.num_randomizations = "auto"
estimator.options.environment.job_tags = ["TUT_QAOA"]
result = minimize(
cost_func_estimator,
init_params,
args=(candidate_circuit, cost_hamiltonian, estimator),
method="COBYLA",
tol=1e-2,
)
print(result)Output:
 message: Return from COBYLA because the trust region radius reaches its lower bound.
 success: True
  status: 0
     fun: -2.0402211719947774
       x: [ 3.041e+00  1.212e+00  2.081e+00  4.471e+00]
    nfev: 36
   maxcv: 0.0
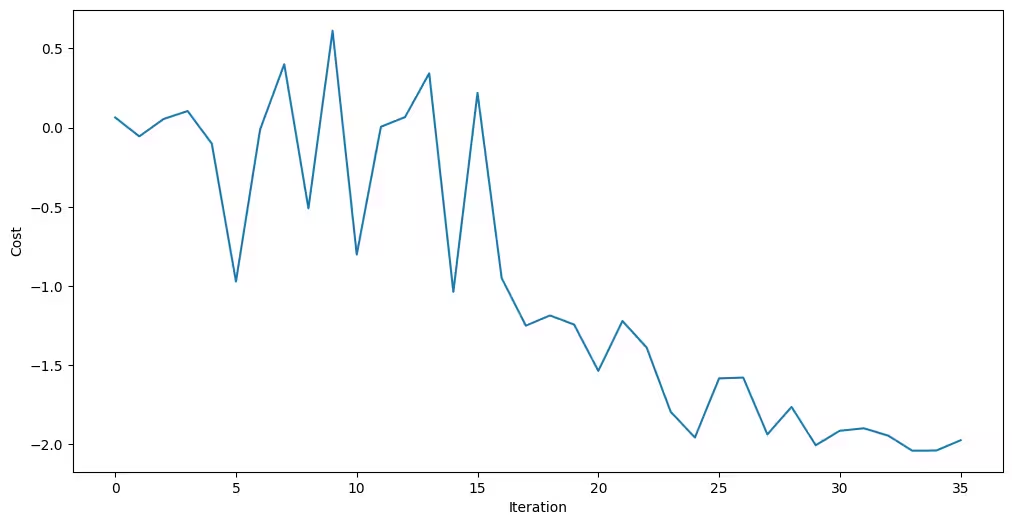
Der Optimierer konnte die Kosten senken und bessere Parameter für die Schaltung finden.
Eine sanft abfallende Kurve, die sich dann abflacht, ist ein typisches Anzeichen für Konvergenz. Eine unruhige, nicht-monotone Kurve deutet in der Regel darauf hin, dass ein vorgelagerter Schritt überprüft werden muss; häufige Ursachen sind zu wenige Iterationen pro Bewertung (hohe Schättevarians), ungeeignete Startparameter oder eine Schaltung, deren Tiefe durch Hardware-Rauschen dominiert wird. COBYLA ist derivatfrei und relativ robust gegenüber mäßigem Rauschen; wenn das Rauschen jedoch die tatsächlichen Kostenverbesserungen pro Schritt überlagert, kann sein lineares Näherungsmodell den tatsächlichen Abstieg nicht mehr von zufälligen Schwankungen unterscheiden, und der Optimierer driftet ab.
plt.figure(figsize=(12, 6))
plt.plot(objective_func_vals)
plt.xlabel("Iteration")
plt.ylabel("Cost")
plt.show()
Output:
Weisen Sie die optimierten Parameter zu und generieren Sie Stichproben der endgültigen Verteilung mithilfe der Sampler-Primitive.
optimized_circuit = candidate_circuit.assign_parameters(result.x)
optimized_circuit.draw("mpl", fold=False, idle_wires=False)
Output:

# If using qiskit-ibm-runtime<0.24.0, change `mode=` to `backend=`
sampler = Sampler(mode=backend)
sampler.options.default_shots = 10000

# Set simple error suppression/mitigation options
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = "XY4"
sampler.options.twirling.enable_gates = True
sampler.options.twirling.num_randomizations = "auto"

sampler.options.environment.job_tags = ["TUT_QAOA"]

pub = (optimized_circuit,)
job = sampler.run([pub], shots=int(1e4))
counts_int = job.result()[0].data.meas.get_int_counts()
counts_bin = job.result()[0].data.meas.get_counts()
shots = sum(counts_int.values())
final_distribution_int = {key: val / shots for key, val in counts_int.items()}
final_distribution_bin = {key: val / shots for key, val in counts_bin.items()}
print(final_distribution_int)
Output:
{18: 0.039, 5: 0.0665, 20: 0.0973, 29: 0.0063, 9: 0.0899, 13: 0.0379, 2: 0.0047, 1: 0.0153, 11: 0.0932, 14: 0.0327, 12: 0.0314, 25: 0.0193, 21: 0.0398, 6: 0.0224, 4: 0.0197, 10: 0.0387, 3: 0.0181, 26: 0.07, 17: 0.0327, 19: 0.0332, 22: 0.0914, 24: 0.007, 0: 0.0033, 8: 0.0066, 30: 0.0158, 28: 0.0169, 27: 0.0222, 16: 0.0073, 7: 0.0057, 23: 0.0062, 15: 0.0054, 31: 0.0041}
Schritt 4: Nachbearbeitung und Rückgabe des Ergebnisses im gewünschten klassischen Format
Extrahieren Sie die wahrscheinlichste Bitfolge aus der Stichprobenverteilung. Dies ist der beste Schnitt, den QAOA gefunden hat.
# auxiliary functions to sample most likely bitstring
def to_bitstring(integer, num_bits):
    result = np.binary_repr(integer, width=num_bits)
    return [int(digit) for digit in result]


keys = list(final_distribution_int.keys())
values = list(final_distribution_int.values())
most_likely = keys[np.argmax(np.abs(values))]
most_likely_bitstring = to_bitstring(most_likely, len(graph))
most_likely_bitstring.reverse()

print("Result bitstring:", most_likely_bitstring)
Output:
Result bitstring: [0, 0, 1, 0, 1]
plt.rcParams.update({"font.size": 10})
final_bits = final_distribution_bin
values = np.abs(list(final_bits.values()))
top_4_values = sorted(values, reverse=True)[:4]
positions = []
for value in top_4_values:
    positions.append(np.where(values == value)[0])
fig = plt.figure(figsize=(11, 6))
ax = fig.add_subplot(1, 1, 1)
plt.xticks(rotation=45)
plt.title("Result Distribution")
plt.xlabel("Bitstrings (reversed)")
plt.ylabel("Probability")
ax.bar(list(final_bits.keys()), list(final_bits.values()), color="tab:grey")
for p in positions:
    ax.get_children()[int(p[0])].set_color("tab:purple")
plt.show()
Output:

Den besten Schnitt visualisieren
Anhand der optimalen Bitfolge kannst du diesen Schnitt dann im ursprünglichen Graphen visualisieren.
# auxiliary function to plot graphs
def plot_result(G, x):
    colors = ["tab:grey" if i == 0 else "tab:purple" for i in x]
    pos, _default_axes = rx.spring_layout(G), plt.axes(frameon=True)
    rx.visualization.mpl_draw(
        G, node_color=colors, node_size=100, alpha=0.8, pos=pos
    )


plot_result(graph, most_likely_bitstring)
Output:

Berechne nun den Wert des Schnitts:
def evaluate_sample(x: Sequence[int], graph: rx.PyGraph) -> float:
    assert len(x) == len(
        list(graph.nodes())
    ), "The length of x must coincide with the number of nodes in the graph."
    return sum(
        x[u] * (1 - x[v]) + x[v] * (1 - x[u])
        for u, v in list(graph.edge_list())
    )


cut_value = evaluate_sample(most_likely_bitstring, graph)
print("The value of the cut is:", cut_value)
Output:
The value of the cut is: 5
Bei einem so kleinen Graphen lässt sich das wahre Optimum leicht durch Brute-Force-Methode ermitteln, sodass Sie die Ergebnisse überprüfen können, indem Sie das QAOA-Ergebnis mit der exakten Lösung vergleichen.
# Classical baseline: enumerate all 2**n_small bitstrings and take the best cut.
def brute_force_max_cut(graph: rx.PyGraph) -> tuple[int, list[int]]:
    n = len(list(graph.nodes()))
    best_cut = -1
    best_x: list[int] = []
    for i in range(2**n):
        x = [(i >> k) & 1 for k in range(n)]
        cut = evaluate_sample(x, graph)
        if cut > best_cut:
            best_cut = int(cut)
            best_x = x
    return best_cut, best_x


classical_best, classical_x = brute_force_max_cut(graph)
print(f"Classical optimum (brute force): {classical_best}")
print(f"QAOA cut value:                  {cut_value}")
Output:
Classical optimum (brute force): 5
QAOA cut value:                  5
Beispiel für groß angelegte Hardware
Unter IBM Quantum Platform haben Sie Zugriff auf zahlreiche Geräte mit über 100 Qubits. Wählen Sie einen aus, auf dem das Max-Cut-Problem in einem gewichteten Graphen mit 100 Knoten gelöst werden soll. Dies ist ein Problem im „Großmaßstab“. Der Arbeitsablauf folgt denselben Schritten wie oben, gilt jedoch für einen wesentlich größeren Graphen.
Durchgängiger Arbeitsablauf im Versorgungsmaßstab
Im Folgenden werden alle vier Schritte am Beispiel des Graphen mit 100 Knoten dargestellt. Der Aufbau entspricht dem des kleinen Beispiels: Karte, Transpile, Ausführung, Nachbearbeitung – allerdings mit einem größeren Problem, das der Übersichtlichkeit halber auf die vier folgenden Zellen aufgeteilt wurde.
# Precomputed parity lookup table: _PARITY[b] = +1 if popcount(b) is even, else -1.
# We use this to vectorize expectation-value evaluation across all Pauli terms.
_PARITY = np.array(
    [-1 if bin(i).count("1") % 2 else 1 for i in range(256)],
    dtype=np.complex128,
)


def evaluate_sparse_pauli(state: int, observable: SparsePauliOp) -> complex:
    """Expectation value of a SparsePauliOp on a single computational-basis state.

    For a Z-only observable (which QAOA cost Hamiltonians are, after the
    QUBO-to-Hamiltonian mapping), the eigenvalue of each Pauli term on a
    computational-basis state is simply (-1)**popcount(z_mask AND state),
    i.e., the parity of the bitwise-AND of the term's Z-support and the
    measured bitstring.

    This routine packs the Z-support of every Pauli term into bytes, ANDs
    them against the measured state in a single vectorized op, and looks up
    the parity in _PARITY. For a 100-qubit / ~hundreds-of-terms Hamiltonian
    over 10_000 samples, this is dramatically faster than calling
    SparsePauliOp.expectation_value per sample.
    """
    packed_uint8 = np.packbits(observable.paulis.z, axis=1, bitorder="little")
    state_bytes = np.frombuffer(
        state.to_bytes(packed_uint8.shape[1], "little"), dtype=np.uint8
    )
    reduced = np.bitwise_xor.reduce(packed_uint8 & state_bytes, axis=1)
    return np.sum(observable.coeffs * _PARITY[reduced])


def best_solution(samples, hamiltonian):
    """Return the sampled bitstring (as int) with the lowest Hamiltonian cost."""
    min_cost = float("inf")
    min_sol = None
    for bit_str in samples.keys():
        candidate_sol = int(bit_str)
        fval = evaluate_sparse_pauli(candidate_sol, hamiltonian).real
        if fval <= min_cost:
            min_cost = fval
            min_sol = candidate_sol
    return min_sol


def _plot_cdf(objective_values: dict, ax, color):
    x_vals = sorted(objective_values.keys(), reverse=True)
    y_vals = np.cumsum([objective_values[x] for x in x_vals])
    ax.plot(x_vals, y_vals, color=color)


def plot_cdf(dist, ax, title):
    _plot_cdf(dist, ax, "C1")
    ax.vlines(min(list(dist.keys())), 0, 1, "C1", linestyle="--")
    ax.set_title(title)
    ax.set_xlabel("Objective function value")
    ax.set_ylabel("Cumulative distribution function")
    ax.grid(alpha=0.3)


def samples_to_objective_values(samples, hamiltonian):
    """Convert the samples to values of the objective function."""
    objective_values = defaultdict(float)
    for bit_str, prob in samples.items():
        candidate_sol = int(bit_str)
        fval = evaluate_sparse_pauli(candidate_sol, hamiltonian).real
        objective_values[fval] += prob
    return objective_values
Schritt 1 : Erstellen Sie den Graphen, den Kosten-Hamiltonian und den Ansatz.
# Step 1: build the 100-node graph, cost Hamiltonian, and QAOA ansatz.
n_large = 100
graph_100 = rx.PyGraph()
graph_100.add_nodes_from(np.arange(0, n_large, 1))
elist = []
for edge in backend.coupling_map:
    if edge[0] < n_large and edge[1] < n_large:
        elist.append((edge[0], edge[1], 1.0))
graph_100.add_edges_from(elist)

max_cut_paulis_100 = build_max_cut_paulis(graph_100)
cost_hamiltonian_100 = SparsePauliOp.from_sparse_list(
    max_cut_paulis_100, n_large
)

circuit_100 = QAOAAnsatz(cost_operator=cost_hamiltonian_100, reps=1)
circuit_100.measure_all()
Schritt 2 : Transpile für das ausgewählte Hardware-Backend.
# Step 2: transpile for hardware.
pm = generate_preset_pass_manager(optimization_level=3, backend=backend)
candidate_circuit_100 = pm.run(circuit_100)
Schritt 3 : Führen Sie die QAOA-Optimierungsschleife innerhalb einer Sitzung aus und nehmen Sie anschließend eine Stichprobe.
# Step 3: run the QAOA optimization loop on the device, then sample the
# final distribution with the optimized parameters.
initial_gamma = np.pi
initial_beta = np.pi / 2
init_params = [initial_beta, initial_gamma]

objective_func_vals = []  # Global variable
with Session(backend=backend) as session:
    estimator = Estimator(mode=session)
    estimator.options.default_shots = 1000

    # Set simple error suppression/mitigation options
    estimator.options.dynamical_decoupling.enable = True
    estimator.options.dynamical_decoupling.sequence_type = "XY4"
    estimator.options.twirling.enable_gates = True
    estimator.options.twirling.num_randomizations = "auto"
    estimator.options.environment.job_tags = ["TUT_QAOA"]

    result = minimize(
        cost_func_estimator,
        init_params,
        args=(candidate_circuit_100, cost_hamiltonian_100, estimator),
        method="COBYLA",
    )
    print(result)

# Assign optimal parameters and sample the final distribution.
optimized_circuit_100 = candidate_circuit_100.assign_parameters(result.x)

sampler = Sampler(mode=backend)
sampler.options.default_shots = 10000

# Set simple error suppression/mitigation options
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = "XY4"
sampler.options.twirling.enable_gates = True
sampler.options.twirling.num_randomizations = "auto"

# Add a unique tag to the job execution
sampler.options.environment.job_tags = ["TUT_QAOA"]

pub = (optimized_circuit_100,)
job = sampler.run([pub], shots=int(1e4))

counts_int = job.result()[0].data.meas.get_int_counts()
shots = sum(counts_int.values())
final_distribution_100_int = {
    key: val / shots for key, val in counts_int.items()
}
Output:
 message: Return from COBYLA because the trust region radius reaches its lower bound.
 success: True
  status: 0
     fun: -17.172689238986344
       x: [ 2.574e+00  4.166e+00]
    nfev: 28
   maxcv: 0.0
Schritt 4 : Bearbeite die Stichprobenverteilung nach, um den besten Schnitt zu ermitteln.
# Step 4: find the best-cost sample and evaluate its cut value.
best_sol_100 = best_solution(final_distribution_100_int, cost_hamiltonian_100)
best_sol_bitstring_100 = to_bitstring(int(best_sol_100), len(graph_100))
best_sol_bitstring_100.reverse()

print("Result bitstring:", best_sol_bitstring_100)

cut_value_100 = evaluate_sample(best_sol_bitstring_100, graph_100)
print("The value of the cut is:", cut_value_100)
Output:
Result bitstring: [1, 1, 0, 1, 1, 0, 1, 1, 1, 0, 1, 0, 1, 1, 1, 0, 1, 1, 1, 1, 0, 0, 1, 0, 0, 1, 1, 0, 1, 0, 1, 0, 1, 1, 0, 1, 1, 0, 0, 0, 0, 0, 1, 1, 0, 1, 0, 0, 0, 1, 0, 0, 1, 0, 1, 0, 0, 1, 1, 1, 1, 1, 0, 1, 0, 1, 0, 0, 0, 1, 0, 1, 0, 1, 0, 0, 0, 0, 1, 0, 0, 1, 0, 1, 1, 1, 1, 0, 1, 0, 1, 0, 1, 1, 1, 0, 1, 1, 1, 0]
The value of the cut is: 156
Überprüfen Sie, ob die im Optimierungszyklus minimierten Kosten konvergiert sind, und stellen Sie die Ergebnisse grafisch dar.
# Plot convergence
plt.figure(figsize=(12, 6))
plt.plot(objective_func_vals)
plt.xlabel("Iteration")
plt.ylabel("Cost")
plt.show()

# Visualize the cut
plot_result(graph_100, best_sol_bitstring_100)

# Plot cumulative distribution function
result_dist = samples_to_objective_values(
    final_distribution_100_int, cost_hamiltonian_100
)
fig, ax = plt.subplots(1, 1, figsize=(8, 6))
plot_cdf(result_dist, ax, backend.name)
Output:


Nächste Schritte
Wenn Sie diese Arbeit interessant fanden, könnten Sie auch an folgenden Materialien interessiert sein:
- Fortgeschrittene Techniken für QAOA – Untersuchung fortgeschrittener Strategien zur Verbesserung der QAOA-Leistung
- Herausforderung zur multikriteriellen Optimierung – stellen Sie Ihre Fähigkeiten bei dieser Community-Herausforderung zur multikriteriellen Quantenoptimierung auf die Probe
- Transpilation-Dokumentation zur Feinabstimmung der Schaltungsoptimierung
- Fehlerunterdrückung und -minderung zur Verbesserung der Hardwareergebnisse