最適化ソルバー:Q-CTRL Fire OpalによるQiskit関数
APIリファレンスを参照してください
Qiskit 関数は、 IBM Quantum® Premium Plan、Flex Plan、およびオンプレム ( IBM Quantum Platform API 経由) Plan ユーザーだけが利用できる実験的な機能です。 これらはプレビューリリースの状態であり、変更される可能性がある。
このページのコードは、以下の要件に基づいて開発されました。 これらのバージョン以降のご利用をお勧めします。
qiskit-ibm-runtime~=0.47.0
sympy~=1.14.0
概要
Fire Opal最適化ソルバーでは、量子ハードウェア上でユーティリティスケールの最適化問題を解くことができます。 高レベルの問題定義を入力するだけで、あとはソルバーが処理してくれる。 ワークフロー全体はノイズを意識しており、 Fire Opalのパフォーマンス・マネジメントを活用している。 Solverは、最大の IBM® QPU上でフルデバイススケールであっても、古典的な難問に対して一貫して正確な解を提供します。
このソルバーは柔軟性が高く、目的関数や任意のグラフとして定義された組み合わせ最適化問題を解くために使用できます。 問題をデバイスのトポロジーに紐付ける必要はありません。 制約のない問題も制約のある問題も解くことができ、制約はペナルティ項ではなく、ハード Hamming-weight-1 制約として適用されます。 このガイドに掲載されている例では、さまざまなソルバー入力タイプを用いて、制約なしおよび制約ありのユーティリティ規模の最適化問題を解く方法を示しています。 最初の例は、156ノードの3正則グラフ上で定義された最大切断問題に関するものであり、2番目の例は、コスト関数によって定義された50ノードのグラフ分割問題に取り組むものである。
最適化ソルバーへのアクセスについては、 Q-CTRLにお問い合わせください。
関数の説明
ソルバーは、ハードウェアレベルでのエラー抑制から、効率的な問題マッピング、クローズドループの古典的最適化まで、アルゴリズム全体を完全に最適化し、自動化します。 その裏では、ソルバーのパイプラインがあらゆる段階でエラーを減らし、有意義なスケーリングに必要なパフォーマンスの向上を可能にしている。 基礎となるワークフローは量子近似最適化アルゴリズム(Quantum Approximate Optimization Algorithm:QAOA)にインスパイアされたもので、これはハイブリッド量子古典アルゴリズムである。 Optimization Solverのワークフローの詳細については、 発表された原稿を参照されたい。

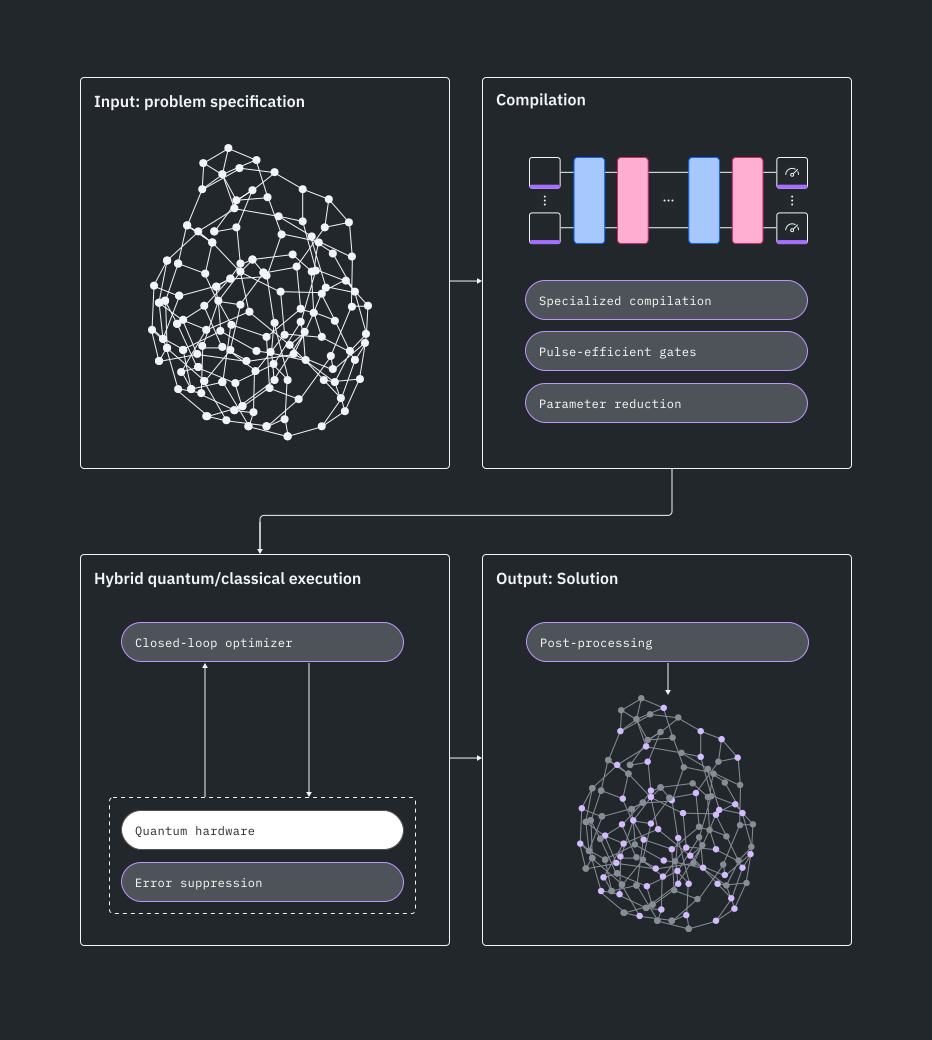
最適化ソルバーで一般的な問題を解く:
- 問題を目的関数、グラフ、
SparsePauliOpスピンチェーンとして定義する。 - Qiskitファンクションカタログからファンクションに接続します。
- ソルバーで問題を実行し、結果を取得する。
対応している問題形式
- 目的関数の多項式表現。 Python、既存の SymPy Polyオブジェクトで作成し、次のようにして文字列に整形するのが理想的です。 sympy.srepr.
- 特定の問題タイプのグラフによる表現。 グラフは、 Python の networkx ライブラリを使用して作成する必要があります。 その後、networkxの関数を使用して、それを文字列に変換する必要があります
nx.readwrite.json_graph.adjacency_data。 - 特定の問題をスピンの連鎖で表現。 スピンチェインは
SparsePauliOpオブジェクトとして表現する必要があります。詳細はドキュメントを参照してください。
この関数が現在サポートしていないバックエンドを使用したい場合は、 Q-CTRLまでご連絡いただき、サポートの追加をご依頼ください。
ベンチマーク
パフォーマンスは、問題のインスタンスとその後の処理ステップの両方に左右される場合があります。 場合によっては、古典的なサンプルと量子生成されたサンプルは、同等の後処理を行った後、同等の最終的な解の品質を達成する可能性があります。 したがって、評価にあたっては、最適化ワークフロー全体を考慮すべきである。
公開されたベンチマーク結果では、ソルバーが120量子ビット以上の問題を解くことに成功しており、量子アニーリングやトラップドイオンデバイスに関する既発表の結果をも上回っている。 以下のベンチマーク・メトリクスは、いくつかの例に基づいて、問題タイプの精度とスケーリングを大まかに示すものです。 実際の測定基準は、目的関数の項数(密度)やその局所性、変数の数、多項式の次数など、さまざまな問題の特徴によって異なる場合があります。
表示されている "量子ビット数 "は難しい制限ではなく、極めて安定した解の精度が期待できる大まかな閾値を表しています。 より大きな問題サイズでも解決に成功しており、この限界を超えたテストが奨励されている。
すべての問題タイプにおいて、任意の量子ビット接続がサポートされている。
問題のタイプ | 量子ビット数 | 例 | 正確性 | 合計回数 | ランタイム使用量 (s) | 反復数 |
|---|---|---|---|---|---|---|
| 疎結合2次問題 | 156 | 3-レギュラー・マックスカット | 100% | 1764 | 293 | 16 |
| 高次バイナリ最適化 | 156 | イジング・スピングラス模型 | 100% | 1461 | 272 | 16 |
| 密結合二次問題 | 50 | 完全連結最大カット | 100% | 1758 | 268 | 12 |
| 厳格な制約条件を持つ制約問題 | 50 | 辺密度8%における重み付きグラフの分割 | 100% | 1074 | 215 | 10 |
使用を開始する
まず、 IBM Quantum のAPIキーを使用して認証を行ってください。 次に、次のようにQiskit関数を選択します。 (このスニペットは、アカウントがすでにローカル環境に保存されていることを前提としています。)
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
Output:
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access Function
solver = catalog.load("q-ctrl/optimization-solver")
例:制約なし最適化
最大カット (max-cut)問題を解く。 以下の例では、156ノードの3正則無重みグラフにおける最大切断問題を用いてソルバーの機能を紹介していますが、重み付きグラフの問題も解くことができます。
この例を実行するには、 qiskit-ibm-catalog に加え、 networkx と numpy のパッケージも使用します。 IPythonカーネルを使ってこのサンプルをノートブックで実行している場合は、以下のセルをアンコメントすることでこれらのパッケージをインストールできます。
# %pip install networkx numpy1. 問題を定義する
problem_type='maxcut'グラフ問題を定義し、を指定することで、最大切断問題を実行できます。
import networkx as nx
import numpy as np

# Generate a random graph with 156 nodes
maxcut_graph = nx.random_regular_graph(d=3, n=156, seed=8)
# Optionally, visualize the graph
nx.draw_networkx(
maxcut_graph, nx.kamada_kawai_layout(maxcut_graph), node_size=100
)Output:

ソルバーは問題定義の入力として文字列を受け付ける。
# Convert graph to string
problem_as_str = nx.readwrite.json_graph.adjacency_data(maxcut_graph)
2. 問題を実行する
グラフベースの入力方法を使用する場合は、問題タイプを指定する。
# Solve the problem
maxcut_job = solver.run(
    problem=problem_as_str,
    problem_type="maxcut",
    backend_name=backend_name,  # E.g. "ibm_fez"
)
Qiskit Function ワークロードのステータスを確認したり、 結果を返したりするには、次のように操作してください:
# Print the ID so you can use it later, if necessary
print(maxcut_job.job_id)

# Get job status
print(maxcut_job.status())
Output:
34b53970-d95a-4e24-8763-fc6f3d112843
QUEUED
3. 結果を取得する
結果辞書から最適なカット値を取得する。
変数のビット列へのマッピングが変更された可能性があります。 出力辞書にはサブ variables_to_bitstring_index_map 辞書が含まれており、順序の検証に役立ちます。
# Poll for results
maxcut_result = maxcut_job.result()

# Take the absolute value of the solution since the cost function is minimized
qctrl_maxcut = abs(maxcut_result["solution_bitstring_cost"])

# Print the optimal cut value found by the Optimization Solver
print(f"Optimal cut value: {qctrl_maxcut}")
Output:
Optimal cut value: 210.0
のようなオープンソースのソルバーで古典的に問題を解くことで、結果の正確さを検証することができる。 PuLP グラフが密結合でない場合は 高密度の問題では、解を検証するために高度な古典的ソルバーが必要になることがある。
例:制約付き最適化
前述の最大切断(max-cut)の例は、一般的な制約なしの二次二値最適化問題である。 Q-CTRLの最適化ソルバーでは、制約を目的関数内のペナルティ項として表現するのではなく、入 constraint 力を通じてハード制約をソルバーに直接渡すことで、制約付き最適化問題を解くこともできます。 このソルバーは現在、 Hamming-weight-1 制約をサポートしています。各制約は、変数のグループを指定し、そのグループ内の変数のうち、正確に1つの変数だけが1となり、残りの変数はすべて0でなければならないという条件を定めています。
以下の例では、 グラフ分割という制約付き最適化問題に対して、グラフ内の各ノードを複数のグループのうちのちょうど1つに割り当てると同時に、端点が同じグループに属する辺の総重みを最小化することで、目的関数と一連のハード制約を構築する方法を示しています。
qiskit-ibm-catalog と qiskit パッケージに加え、このサンプルを実行するには以下のパッケージも使用する: numpy networkx、および sympy。 IPythonカーネルを使ってこのサンプルをノートブックで実行している場合は、以下のセルをアンコメントすることでこれらのパッケージをインストールできます。
# %pip install numpy networkx sympy1. 問題を定義する
ノードにランダムな重みが割り当てられたグラフを生成することで、ランダムグラフ分割問題を定義する。
import networkx as nx
from sympy import Symbol, Poly, srepr

# To change the weights, change the seed to any integer.
rng_seed = 18
_rng = np.random.default_rng(rng_seed)
node_count = 50
edge_probability = 0.08
graph = nx.erdos_renyi_graph(
    node_count, edge_probability, seed=rng_seed, directed=False
)

# add node weights
min_weight = -1.0
max_weight = 1.0
for i in graph.nodes:
    weight = (max_weight - min_weight) * _rng.random() + min_weight
    graph.add_node(i, weight=weight)

# Optionally, visualize the graph
nx.draw_networkx(graph, nx.kamada_kawai_layout(graph), node_size=200)
Output:

重み付きグラフの分割に関する標準的な最適化モデルは、次のように定式化できる。 グラフのノードを の3つのグループに分割し、ノード がグループ に割り当てられた場合は とし、それ以外の場合は とする。 目標は、両端点が同じグループに割り当てられている辺の総重みを最小化することです。ここで、辺 の重みは、その両端点 の重みの合計となります:
# Construct the cost function.
group_count = 3
variables = [
    Symbol(f"n[{i},{g}]")
    for i in range(node_count)
    for g in range(group_count)
]
node_group_var = {
    (i, g): variables[i * group_count + g]
    for i in range(node_count)
    for g in range(group_count)
}
cost_function = Poly(0, *variables)

for i, j in graph.edges():
    edge_weight = graph.nodes[i]["weight"] + graph.nodes[j]["weight"]
    for g in range(group_count):
        cost_function += (
            edge_weight * node_group_var[(i, g)] * node_group_var[(j, g)]
        )
各ノードは、3つのグループのうち、必ず1つにのみ割り当てられなければなりません。 これは Hamming-weight-1 の制約です。すべてのノード について、 のうち、ちょうど1つが1となり、残りはすべて0でなければなりません:
この要件をコスト関数内のペナルティ項として定式化するのではなく、 constraint を使用して、ハード制約として Solver に直接渡してください。
# Build the hard constraint: exactly one group per node.
constraint_dict = {
    str(tuple(f"n[{i},{g}]" for g in range(group_count))): 1
    for i in range(node_count)
}
print(f"Problem constraints: {constraint_dict}")
Output:
Problem constraints: {"('n[0,0]', 'n[0,1]', 'n[0,2]')": 1, "('n[1,0]', 'n[1,1]', 'n[1,2]')": 1, "('n[2,0]', 'n[2,1]', 'n[2,2]')": 1, "('n[3,0]', 'n[3,1]', 'n[3,2]')": 1, "('n[4,0]', 'n[4,1]', 'n[4,2]')": 1, "('n[5,0]', 'n[5,1]', 'n[5,2]')": 1, "('n[6,0]', 'n[6,1]', 'n[6,2]')": 1, "('n[7,0]', 'n[7,1]', 'n[7,2]')": 1, "('n[8,0]', 'n[8,1]', 'n[8,2]')": 1, "('n[9,0]', 'n[9,1]', 'n[9,2]')": 1, "('n[10,0]', 'n[10,1]', 'n[10,2]')": 1, "('n[11,0]', 'n[11,1]', 'n[11,2]')": 1, "('n[12,0]', 'n[12,1]', 'n[12,2]')": 1, "('n[13,0]', 'n[13,1]', 'n[13,2]')": 1, "('n[14,0]', 'n[14,1]', 'n[14,2]')": 1, "('n[15,0]', 'n[15,1]', 'n[15,2]')": 1, "('n[16,0]', 'n[16,1]', 'n[16,2]')": 1, "('n[17,0]', 'n[17,1]', 'n[17,2]')": 1, "('n[18,0]', 'n[18,1]', 'n[18,2]')": 1, "('n[19,0]', 'n[19,1]', 'n[19,2]')": 1, "('n[20,0]', 'n[20,1]', 'n[20,2]')": 1, "('n[21,0]', 'n[21,1]', 'n[21,2]')": 1, "('n[22,0]', 'n[22,1]', 'n[22,2]')": 1, "('n[23,0]', 'n[23,1]', 'n[23,2]')": 1, "('n[24,0]', 'n[24,1]', 'n[24,2]')": 1, "('n[25,0]', 'n[25,1]', 'n[25,2]')": 1, "('n[26,0]', 'n[26,1]', 'n[26,2]')": 1, "('n[27,0]', 'n[27,1]', 'n[27,2]')": 1, "('n[28,0]', 'n[28,1]', 'n[28,2]')": 1, "('n[29,0]', 'n[29,1]', 'n[29,2]')": 1, "('n[30,0]', 'n[30,1]', 'n[30,2]')": 1, "('n[31,0]', 'n[31,1]', 'n[31,2]')": 1, "('n[32,0]', 'n[32,1]', 'n[32,2]')": 1, "('n[33,0]', 'n[33,1]', 'n[33,2]')": 1, "('n[34,0]', 'n[34,1]', 'n[34,2]')": 1, "('n[35,0]', 'n[35,1]', 'n[35,2]')": 1, "('n[36,0]', 'n[36,1]', 'n[36,2]')": 1, "('n[37,0]', 'n[37,1]', 'n[37,2]')": 1, "('n[38,0]', 'n[38,1]', 'n[38,2]')": 1, "('n[39,0]', 'n[39,1]', 'n[39,2]')": 1, "('n[40,0]', 'n[40,1]', 'n[40,2]')": 1, "('n[41,0]', 'n[41,1]', 'n[41,2]')": 1, "('n[42,0]', 'n[42,1]', 'n[42,2]')": 1, "('n[43,0]', 'n[43,1]', 'n[43,2]')": 1, "('n[44,0]', 'n[44,1]', 'n[44,2]')": 1, "('n[45,0]', 'n[45,1]', 'n[45,2]')": 1, "('n[46,0]', 'n[46,1]', 'n[46,2]')": 1, "('n[47,0]', 'n[47,1]', 'n[47,2]')": 1, "('n[48,0]', 'n[48,1]', 'n[48,2]')": 1, "('n[49,0]', 'n[49,1]', 'n[49,2]')": 1}
すべての変数を.に追加する必要はありません constraint。 辞書から除外された変数はすべて制約を受けないため、同じ問題内で、厳密な制約が課された変数のグループと自由変数を組み合わせることができます。
2. 問題を実行する
# Solve the problem
partition_job = solver.run(
    problem=srepr(cost_function),
    constraint=constraint_dict,
    backend_name="ibm_marrakesh",  # E.g. "ibm_marrakesh"
)
Qiskit Function ワークロードのステータスを確認したり、 結果を返したりするには、次のように操作してください:
# Print the ID so you can use it later, if necessary
print(partition_job.job_id)

# Get job status
print(partition_job.status())
Output:
b8085944-f313-444e-be39-ea61b1b47ebd
QUEUED
3. 結果を得る
解を取得し、結果を分析する。 解のコストは、両端点が同じグループに属することになった辺の総重みを表すため、コストが低いほど、グラフの分割が良好であることを示す。
partition_result = partition_job.result()
qctrl_cost = partition_result["solution_bitstring_cost"]
solution_bitstring = partition_result["solution_bitstring"]

# Print results
print(f"Total weight of same-group edges: {qctrl_cost}")
print(f"Solution bitstring: {solution_bitstring}")
Output:
Total weight of same-group edges: -36.5539
Solution bitstring: 100100100100100001100100100100100100100100100100100001010100010100100100100010001001100100100001100001100001010001001010100100100100100010100100100100
サポートの利用
ご質問や問題がありましたら、 Q-CTRLまでご連絡ください。
変更ログ
- 2026年8月10日:
inputconstraint - 2026-02-11: 以下のサポートを追加しました
ibm_miami
次のステップ
- Q-CTRL最適化ソルバー へのアクセスをリクエストします。
- このQiskit関数の APIリファレンスをご覧ください。
- Q-CTRLの最適化ソルバーで高次バイナリ最適化問題を解くチュートリアルをお試しください。
- レビュー サッチデヴァ, N., et al. (2024). 127量子ビットのゲートモデル量子コンピュータ IBM を用いた量子最適化は、非自明な二値最適化問題において量子アニーリングを超越する性能を発揮し得る。 arXiv プレプリント arXiv:2406.01743.
- レビュー ・ロコ、D et al. (2026). 量子コンピューターを用いた創薬のための実用的なタンパク質ポケット水和部位予測 arXiv プレプリント arXiv:2512.08390.
- マツダのケーススタディを確認する。
- ネットワーク ・レールの事例研究を確認する。
- オーストラリア陸軍の事例研究を検討する。
- ニューサウスウェールズ州交通局の事例研究を確認する。